Wydajność process mining: testy i wskazówki
Sprawdź, jak ilość danych, format pliku i rodzaj zapytania wpływają na wydajność process mining. Poznaj wyniki testów dla zbiorów od 100 tys. do 100 mln zdarzeń.

Wydajność process mining zależy nie tylko od liczby zdarzeń. Wpływają na nią również rozmiar pliku, liczba spraw, rodzaj zapytania i przepustowość sieci. Poniższe testy obejmują zbiory od 100 tys. do 100 mln zdarzeń. Przeprowadzono je w marcu 2026 r. na produkcyjnej infrastrukturze AWS, w opisanych tu formatach plików i warunkach.
Najważniejsze wnioski
- Przesyłanie może najbardziej wydłużyć oczekiwanie w przypadku dużych plików lub wolnego połączenia.
- Pliki Parquet i ORC są znacznie mniejsze niż surowe pliki CSV, co skraca czas przesyłania.
- Czas odpowiedzi dashboardu zależy od zapytania. Statystyki są szybko dostępne, a obliczanie przepływu procesu trwa dłużej wraz ze wzrostem liczby zdarzeń.
- Ładowanie przyrostowe przesyła nowe zdarzenia bez konieczności ponownego przesyłania całego zbioru.
- Mniejszy, odpowiednio dobrany zbiór można szybciej przesłać i łatwiej przeanalizować.
Co wpływa na wydajność process mining?
Na wydajność wpływają cztery czynniki: ilość danych, struktura dziennika zdarzeń, uruchamiane zapytanie oraz środowisko przesyłania i przetwarzania danych.
- Liczba zdarzeń i spraw: Więcej zdarzeń oznacza zwykle więcej danych do przesłania i przetworzenia. Liczba spraw określa, ile instancji procesu obejmuje analiza.
- Rodzaj zapytania: Obliczenie statystyki zbiorczej wymaga innych działań niż analiza przepływu procesu. Zapytania wyznaczające przejścia między działaniami mogą trwać dłużej niż te, które korzystają z wcześniej zagregowanych danych.
- Liczba działań i długość spraw: Większa liczba różnych działań i dłuższe sprawy zwiększają nakład pracy potrzebny do obliczenia przepływów i wariantów.
- Rozmiar pliku i szybkość sieci: Te czynniki decydują o czasie przesyłania. Szeroki plik CSV z długimi polami tekstowymi może być znacznie większy niż kompaktowy plik kolumnowy zawierający te same zdarzenia.
Sama liczba zdarzeń nie wystarczy, by przewidzieć czas przetwarzania zbioru. Wyniki testów mogą służyć jako punkt odniesienia, ale warto sprawdzić własny dziennik zdarzeń i zapytania. Taka analiza najlepiej pokaże wydajność process mining w Państwa środowisku.
Potok danych: na co upływa czas?
Zbiór danych przechodzi przez trzy etapy: przesyłanie, wstępne przetwarzanie oraz ponowne obliczenia po zmianie modelu procesu.
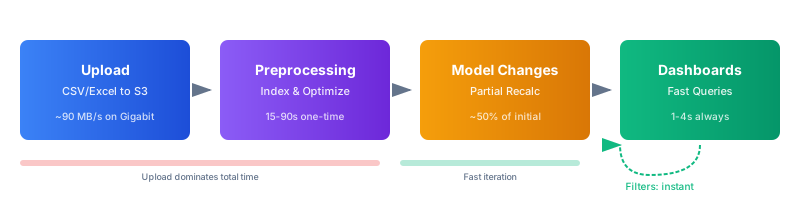
- Przesyłanie: Plik jest przesyłany przez internet do infrastruktury chmurowej ProcessMind. Czas transferu zależy od przepustowości sieci i rozmiaru pliku. Na przykład przesłanie pliku CSV o rozmiarze 11 GB, zawierającego 50 mln zdarzeń, trwa około 2 minut przy 1 Gb/s, 18 minut przy 100 Mb/s lub ponad 3 godziny przy 10 Mb/s. Te same dane w pliku Parquet o rozmiarze 1,7 GB przesyłają się w około 19 sekund, 3 minuty lub 28 minut przy tych samych prędkościach.
- Wstępne przetwarzanie: Po przesłaniu system konwertuje dane do zoptymalizowanego formatu kolumnowego, indeksuje zdarzenia, oblicza przejścia między działaniami i warianty procesu oraz generuje statystyki zbiorcze. W poniższych testach trwało to od 35 sekund dla 100 tys. zdarzeń do 2,5 minuty dla 100 mln zdarzeń.
- Zmiany modelu: Po zmianie mapowania działań lub dodaniu bądź usunięciu działań ProcessMind aktualizuje obliczenia zależne od modelu. W poniższych testach trwało to około 14 sekund dla 1 mln zdarzeń i 52 sekundy dla 100 mln zdarzeń. Zmiany filtrów są natychmiastowe.
W przypadku dużych zbiorów danych zmniejszenie rozmiaru pliku to często najskuteczniejszy sposób na skrócenie początkowego oczekiwania. Po wstępnym przetworzeniu wydajność zapytań zależy od obliczeń wymaganych przez dashboard.
Jak zmienia się czas wykonywania zapytań?
Różne zapytania wymagają różnego nakładu pracy. Poniższe informacje pomagają przewidzieć czas ich wykonania i odpowiednio przygotować dane.
- Liczba działań: Modele z 10–20 różnymi działaniami łatwiej analizować i wyświetlać. Przy ponad 50 działaniach obliczanie przepływu procesu trwa dłużej, a sam diagram może być mniej czytelny. Jeśli odpowiada to rzeczywistemu przebiegowi procesu, warto grupować powiązane kroki.
- Różnorodność wariantów: Proces, w którym większość spraw przebiega według kilku ścieżek, można zwykle analizować szybciej niż taki, w którym każda sprawa ma inną ścieżkę. Duże zróżnicowanie może być istotne, ale wydłużać czas zapytań.
- Liczba kolumn: Do analizy procesu potrzebne są podstawowe pola: CaseId, Activity i Timestamp. Dodatkowe atrybuty ułatwiają filtrowanie i kategoryzację, ale zwiększają ilość danych do przesłania i przeszukania.
- Długość spraw: Sprawa obejmująca 50 zdarzeń wymaga więcej pracy niż taka, która obejmuje ich 5. Zapytania mogą trwać dłużej w procesach, w których sprawy obejmują setki zdarzeń.
Czas odpowiedzi dashboardu
Podane wartości mediany pochodzą z wielu testów. Każdy element dashboardu wykonuje własne zapytanie, a wszystkie ładują się równolegle.
| Zbiór danych | Statystyki | Przepływ procesu | Warianty | Kategorie | Przeglądarka danych | Animacja |
|---|---|---|---|---|---|---|
| 100K | 0.6s | 1.5s | 1.1s | 1.5s | 1.2s | 1.4s |
| 1M | 0.6s | 1.6s | 1.4s | 1.9s | 1.5s | 2.0s |
| 5M | 0.6s | 2.5s | 1.8s | 2.4s | 1.3s | 2.1s |
| 10M | 0.6s | 3.4s | 2.2s | 2.5s | 1.6s | 2.4s |
| 20M | 0.6s | 3.9s | 2.7s | 3.3s | 1.9s | 3.6s |
| 50M | 0.6s | 5.1s | 4.2s | 5.7s | 1.6s | 2.7s |
| 100M | 0.6s | 7.2s | 3.5s | 4.7s | 1.6s | 5.0s |
Czas wyświetlania statystyk wynosił około 0,6 sekundy dla wszystkich testowanych rozmiarów zbioru. Przepływ procesu oblicza przejścia między działaniami, dlatego jego wyświetlanie trwało dłużej wraz ze wzrostem liczby zdarzeń. Czas obliczania wariantów i kategorii rósł umiarkowanie, a przeglądarka danych zachowywała płynność dzięki stronicowaniu. Czas animacji zależał od liczby wyświetlanych aktywnych spraw.
Dla zbiorów od 1 mln do 10 mln zdarzeń zmierzony czas odpowiedzi wynosił od 0,6 do 3,4 sekundy, zależnie od elementu dashboardu. Przy 50 mln zdarzeń przepływ procesu i kategorie były wyświetlane w około 5–6 sekund. To wyniki testów, a nie gwarancja dla każdego zbioru danych i środowiska.
Dane z testów: w jakich warunkach je przeprowadzono?
Testy przeprowadzono w marcu 2026 r. na produkcyjnej infrastrukturze AWS. Czasy przesyłania i wstępnego przetwarzania to średnie z wielu prób. Czasy odpowiedzi dashboardu to mediany z wielu prób. Dla każdego rozmiaru zbioru przetestowano ponad 50 rodzajów zapytań.
Podane niżej liczby zdarzeń odpowiadają rzeczywistej liczbie rekordów w plikach testowych. Rozmiary plików dotyczą nieskompresowanych plików CSV o typowej strukturze dziennika zdarzeń: CaseId, Activity, Timestamp i 5–8 atrybutów biznesowych. Rozmiar pliku i wyniki zależą od liczby kolumn, zawartości, warunków sieciowych, odległości od centrum danych i bieżącego obciążenia.
Czas przesyłania i wstępnego przetwarzania
| Zbiór danych | Rzeczywista liczba zdarzeń | Rozmiar pliku | Przesyłanie (1 Gb/s) | Przesyłanie (100 Mb/s) | Przesyłanie (50 Mb/s) | Przesyłanie (10 Mb/s) | Wstępne przetwarzanie |
|---|---|---|---|---|---|---|---|
| 100K | 125,260 | 22 MB | < 1s | 2s | 4s | 22s | 35s |
| 500K | 626,300 | 110 MB | 1s | 11s | 22s | 2 min | 45s |
| 1M | 1,253,424 | 221 MB | 3s | 22s | 44s | 4 min | 55s |
| 2M | 2,506,848 | 443 MB | 5s | 44s | 1.5 min | 7 min | 1 min |
| 5M | 4,996,877 | 1.1 GB | 13s | 2 min | 4 min | 18 min | 1.5 min |
| 10M | 12,511,867 | 2.2 GB | 25s | 4 min | 7 min | 37 min | 1.5 min |
| 20M | 25,023,734 | 4.4 GB | 50s | 7 min | 15 min | 1.2 hr | 2 min |
| 50M | 62,559,335 | 11.1 GB | 2 min | 18 min | 37 min | 3 hr | 2 min |
| 100M | 125,118,670 | 22.3 GB | 4 min | 37 min | 1.2 hr | 6 hr | 2.5 min |
Zmierzona szybkość transferu 1 Gb/s wyniosła 88 MB/s do regionu AWS eu-central-1. Pozostałe prędkości oszacowano na podstawie praktycznej przepustowości: około 5 MB/s przy 50 Mb/s, 10 MB/s przy 100 Mb/s i 1 MB/s przy 10 Mb/s. Rzeczywista przepustowość zależy od sieci i warunków połączenia.
W tym teście wstępne przetwarzanie trwało od 35 sekund do 2,5 minuty. Czas przesyłania rósł wraz z rozmiarem pliku, a przy dużych plikach stanowił największą część oczekiwania.
Format pliku: Parquet i ORC a CSV
ProcessMind obsługuje formaty CSV, Parquet, ORC, Excel i XES. W poniższym porównaniu rozmiarów plików wykorzystano te same liczby zdarzeń i ten sam schemat co w poprzednim teście.
| Zbiór danych | CSV | Parquet | ORC | CSV.GZ |
|---|---|---|---|---|
| 1M zdarzeń | 221 MB | 34 MB | 39 MB | 20 MB |
| 5M zdarzeń | 1.1 GB | 151 MB | 197 MB | 107 MB |
| 10M zdarzeń | 2.2 GB | 301 MB | 395 MB | 215 MB |
| 20M zdarzeń | 4.4 GB | 603 MB | 791 MB | 430 MB |
| 50M zdarzeń | 11.1 GB | 1.7 GB | 1.9 GB | 1.1 GB |
| 100M zdarzeń | 22.3 GB | 3.4 GB | 3.7 GB | 2.2 GB |
W tych testach pliki Parquet były o około 85% mniejsze od CSV, a pliki ORC o około 82%. Oba formaty przechowują dane kolumnowo i mają wbudowaną kompresję. Narzędzia do pracy z danymi, takie jak Spark, Databricks, dbt i BigQuery, mogą obsługiwać eksport do tych formatów.
Czas wstępnego przetwarzania był podobny dla formatów Parquet, ORC i CSV. Pliki CSV.GZ przetwarzały się dłużej przy większej liczbie zdarzeń, ponieważ plików gzip nie można podzielić na części do równoległej dekompresji.
| Zbiór danych | Parquet | ORC | CSV | CSV.GZ |
|---|---|---|---|---|
| 1M zdarzeń | 55s | 55s | 55s | 55s |
| 5M zdarzeń | 1.5 min | 1.5 min | 1.5 min | 1.5 min |
| 10M zdarzeń | 1.5 min | 1.5 min | 1.5 min | 2 min |
| 20M zdarzeń | 2 min | 2 min | 2 min | 2.5 min |
| 50M zdarzeń | 2 min | 2 min | 2 min | 3 min |
| 100M zdarzeń | 2.5 min | 2.5 min | 2.5 min | 4.5 min |
Łączny czas obejmuje przesyłanie i wstępne przetwarzanie. Poniższe przykłady dotyczą połączenia o przepustowości 100 Mb/s.
| 10M zdarzeń (100 Mb/s) | Rozmiar pliku | Przesyłanie | Wstępne przetwarzanie | Łącznie |
|---|---|---|---|---|
| Parquet | 301 MB | 30s | 1.5 min | ~2 min |
| ORC | 395 MB | 40s | 1.5 min | ~2.2 min |
| CSV | 2.2 GB | 4 min | 1.5 min | ~5.5 min |
| CSV.GZ | 215 MB | 21s | 2 min | ~2.5 min |
| 50M zdarzeń (100 Mb/s) | Rozmiar pliku | Przesyłanie | Wstępne przetwarzanie | Łącznie |
|---|---|---|---|---|
| Parquet | 1.7 GB | 3 min | 2 min | ~5 min |
| ORC | 1.9 GB | 3.2 min | 2 min | ~5.2 min |
| CSV | 11.1 GB | 18 min | 2 min | ~20 min |
| CSV.GZ | 1.1 GB | 2 min | 3 min | ~5 min |
W przypadku dużych zbiorów Parquet i ORC skracają czas przesyłania, ponieważ pliki w tych formatach są mniejsze. CSV pozostaje prostym rozwiązaniem dla mniejszych zbiorów lub gdy proces eksportu nie obsługuje formatów kolumnowych. CSV.GZ może skrócić przesyłanie przy wolnym połączeniu, ale koszt dekompresji rośnie wraz z rozmiarem zbioru.
Wybór formatu pliku
- Parquet: Dobry wybór dla dużych zbiorów danych, jeśli obsługuje go potok danych. W tych testach pliki w tym formacie były najmniejsze.
- ORC: Podobna opcja, szczególnie jeśli potok danych korzysta z Hadoop lub Spark.
- CSV: Prosty i szeroko obsługiwany format, który sprawdza się przy mniejszych zbiorach danych.
- CSV.GZ: Warto go rozważyć, gdy głównym ograniczeniem jest szybkość przesyłania. Należy sprawdzić czas wstępnego przetwarzania na własnych danych, zwłaszcza przy większej liczbie zdarzeń.
Które rodzaje zapytań mogą spowolnić analizę?
Niektóre struktury danych i układy dashboardu wymagają więcej pracy niż inne. Poniższe wskazówki pomagają znaleźć możliwe przyczyny wolniejszych zapytań.
- Zbyt wiele działań: Obliczanie przepływu procesu obejmującego ponad 50 różnych działań może trwać dłużej, a jego interpretacja może być trudna. Warto grupować powiązane kroki, jeśli jest to uzasadnione.
- Wiele różnych wariantów: Gdy sprawy przebiegają wieloma różnymi ścieżkami, obliczenie wariantów wymaga więcej pracy. Duże zróżnicowanie może też wskazywać na zachowania procesu warte zbadania.
- Długie sprawy: Przetwarzanie spraw obejmujących wiele zdarzeń wymaga więcej pracy niż w przypadku krótkich spraw.
- Niepotrzebne kolumny: Dodatkowe atrybuty zwiększają rozmiar pliku i mogą wydłużać zapytania. Warto zachować tylko pola potrzebne do analizy.
- Rozbudowane, przeładowane dashboardy: Każdy wykres lub kafelek wykonuje osobne zapytanie. Warto zostawić elementy odpowiadające na konkretne pytania, a pozostałe widoki umieścić na osobnym dashboardzie.
- Wizualizacje wymagające wielu obliczeń: Na dużych zbiorach wykresy z wieloma kategoriami mogą renderować się dłużej. Jeśli szczegółowy podział nie jest potrzebny, warto użyć widoku zbiorczego.
- Animacja z wieloma aktywnymi sprawami: Czas animacji zależy od liczby wyświetlanych spraw. Jeśli potrzebny jest tylko podgląd przepływu, można zmniejszyć szybkość albo wyłączyć ślady i efekty.
Jak dobrać wielkość zbioru danych?
Warto zacząć od najmniejszego zbioru, który pozwala odpowiedzieć na dane pytanie. Mniejszy, odpowiednio dobrany zbiór szybciej się przesyła i łatwiej go zweryfikować. Można go rozszerzyć, jeśli potrzebne są szerszy zakres danych, rzadkie zdarzenia lub trendy długoterminowe.
Przygotuj i zweryfikuj model na mniejszym zbiorze danych
Zacznij od niedawnej próbki, skonfiguruj model i sprawdź dane przed zwiększeniem ich ilości.
- Zacznij od próbki. Na przykład wyodrębnij 1 mln zdarzeń z ostatnich trzech miesięcy. W teście przesłanie trwało 3 sekundy przy 1 Gb/s lub 22 sekundy przy 100 Mb/s, a wstępne przetwarzanie zajęło 55 sekund.
- Zbuduj model. Skonfiguruj działania, filtry i widoki. Zmiany modelu dla testowanych zbiorów od 1 mln do 10 mln zdarzeń trwały około 14–20 sekund.
- Zweryfikuj wyniki. Sprawdź, czy nazwy działań i ścieżki procesu są zrozumiałe, i usuń problemy z jakością danych.
- W razie potrzeby dodaj więcej danych. Zwiększ liczbę zdarzeń, jeśli trzeba zbadać rzadkie sprawy lub porównać dłuższe okresy.
Tabela porównuje początkowy czas oczekiwania dla różnej liczby zdarzeń przy połączeniu o przepustowości 100 Mb/s.
| Podejście | Przesyłanie (100 Mb/s) | Wstępne przetwarzanie | Łączny czas oczekiwania | Szybkość dashboardu |
|---|---|---|---|---|
| Początek od 1 mln zdarzeń | 22s | 55s | ~1.5 min | 1–2s |
| Początek od 5 mln zdarzeń | 2 min | 1.5 min | ~3.5 min | 1–2.5s |
| Początek od 50 mln zdarzeń | 18 min | 2 min | ~20 min | 1–6s |
Właściwa liczba zdarzeń zależy od pytania. Mniejszy zbiór może wystarczyć do analizy typowych wzorców procesu, ale rzadkie zdarzenia lub wymóg uwzględnienia całej populacji mogą wymagać większej ilości danych.
Podziel dane na segmenty, gdy pytanie dotyczy konkretnego obszaru
Jeśli analizowany jest jeden kraj, dział lub linia produktów, warto zacząć od tego segmentu zamiast łączyć niepowiązane grupy. Podział na segmenty może ułatwić porównania i zmniejszyć ilość danych do przetworzenia.
Przykładowo test opisuje europejski zbiór danych logistycznych obejmujący 42 mln zdarzeń wysyłek w 8 krajach:
- Wszystkie kraje: 42 mln zdarzeń, 9,3 GB, 16 minut przesyłania przy 100 Mb/s i 2 minuty wstępnego przetwarzania.
- Niemcy: 8,5 mln zdarzeń, 1,9 GB, 3 minuty przesyłania i 1,5 minuty wstępnego przetwarzania.
- Holandia: 3,1 mln zdarzeń, 690 MB, 1 minuta przesyłania i 1 minuta wstępnego przetwarzania.
Po zweryfikowaniu każdego segmentu można je porównać. Przydatne kryteria podziału to geografia, organizacja, produkt, okres i segment klientów.
Ogranicz dane do potrzebnych spraw
Jeśli analizowane są wyjątki, eksport tylko odpowiednich spraw może znacznie zmniejszyć zbiór danych. Przykładowo test opisuje proces od zakupu do płatności obejmujący 1,2 mln zamówień zakupu i 8,4 mln zdarzeń. Według testu 96 tys. zamówień, czyli 8%, zawierało wyjątki, takie jak odrzucenia, zwroty, zduplikowane faktury lub brakujące zatwierdzenia.
W tej analizie eksport spraw z wyjątkami zmniejsza zbiór z 8,4 mln do 670 tys. zdarzeń. Według wyników rozmiar pliku spada z 1,9 GB do 150 MB, a czas przesyłania przy 100 Mb/s z 3 minut do 15 sekund. W teście przesłanie tych samych danych w pliku Parquet o rozmiarze 15 MB trwało mniej niż 2 sekundy.
Warto filtrować dane według statusu, działania, czasu trwania sprawy, okresu lub jednostki biznesowej, jeśli te pola odpowiadają badanemu zagadnieniu.
Wybierz tylko potrzebne kolumny
Każda kolumna wpływa na rozmiar pliku. Długie pola tekstowe, zbędne identyfikatory, pola audytowe i metadane techniczne mogą nie być potrzebne do analizy.
Test opisuje eksport z SAP obejmujący 1,8 mln zdarzeń zamówień zakupu i 45 kolumn. Ograniczenie danych do 12 niezbędnych kolumn zmniejszyło rozmiar pliku z 2,1 GB do 380 MB. Eksport tych kolumn do Parquet zmniejszył go dalej, do 58 MB. Według wyników czas przesyłania przy 100 Mb/s spadł z 3,5 minuty do 6 sekund.
Warto zachować pola potrzebne do analizy, w tym CaseId, Activity, Timestamp oraz istotne atrybuty biznesowe, takie jak status, kwota, kategoria czy region. Jeśli dane osobowe nie są potrzebne do analizy, należy je usunąć.
Kiedy warto użyć większego zbioru danych?
Większa liczba zdarzeń może być potrzebna, gdy analiza wymaga szerokiego zakresu danych lub obejmuje dłuższy okres.
- Rzadkie zdarzenia: Aby znaleźć wyjątki występujące raz na 100 000 przypadków, potrzebna jest populacja wystarczająco duża, by je uwzględnić. Jeśli wyjątek pojawia się w 0,01% przypadków i chcą Państwo przeanalizować 50 takich zdarzeń, potrzeba około 500 tys. przypadków.
- Warianty o niskiej częstotliwości: Warianty występujące w 0,1% przypadków mogą być niewidoczne w próbce obejmującej 1 mln zdarzeń, a dobrze widoczne w populacji liczącej 50 mln zdarzeń.
- Zgodność i audyt: Niektóre wymagania nakazują objąć analizą całą populację, a nie tylko próbkę.
- Trendy długoterminowe: Porównanie I kwartału 2024, 2025 i 2026 roku wymaga danych ze wszystkich trzech okresów. Ładowanie przyrostowe pozwala stopniowo gromadzić te dane.
W przypadku zbiorów zawierających ponad 50 mln zdarzeń testy wskazują na korzyści z użycia formatu Parquet, przesyłania danych przez API i szybkiego łącza internetowego, jeśli jest dostępne. Plik CSV z 50 mln zdarzeń użyty w teście miał 11,1 GB, a plik Parquet 1,7 GB.
Wydajność zawsze wiąże się z kompromisem: więcej danych i większa szybkość oznaczają wyższe koszty. Warto więc zapytać nie tylko o możliwości narzędzia, ale przede wszystkim o potrzeby procesu. ProcessMind obsługuje duże zbiory danych, ale odradzamy pracę na ogromnych zbiorach, jeśli nie są potrzebne. Zwiększają one złożoność i mogą odciągać uwagę od samego ulepszania procesów.
Jak zadbać o płynne działanie modelu i interfejsu?
Wielkość zbioru danych to tylko jeden z czynników. Na szybkość pracy wpływają także model procesu i układ dashboardu.
- Zadbaj o czytelność modelu: Duże procesy warto podzielić na modułowe Subprocesses. Renderowanie obszaru roboczego z wieloma widocznymi elementami może trwać dłużej, a nawigacja staje się trudniejsza. Po zmianach struktury użyj funkcji auto-layout.
- Starannie dobieraj elementy dashboardu: Każdy wykres i kafelek wymaga obliczeń. Zostaw widoki, które pomagają odpowiedzieć na aktualne pytania.
- Dobieraj wykresy do danych: Przy dużych zbiorach wizualizacja z wieloma kategoriami może wymagać więcej czasu na obliczenia. Jeśli szczegółowy podział nie jest potrzebny, użyj podsumowania.
- Ogranicz filtry do tych, które pomagają odpowiedzieć na pytanie: Filtry ułatwiają zawężenie analizy. Nie łącz ich jednak, jeśli nie wnoszą nic do odpowiedzi na analizowane pytanie.
- Dostosuj ustawienia animacji: Koszt animacji rośnie wraz z liczbą aktywnych przypadków. Jeśli chcą Państwo tylko sprawdzić przebieg, można zmniejszyć szybkość lub wyłączyć ślady i efekty. Zobacz: Process Animation.
- Przeliczaj tylko to, co się zmieniło: Zmiany w modelu aktualizują zależne od niego obliczenia bez ponownego wykonywania całego etapu wstępnego przetwarzania. W teście aktualizacja trwała od około 14 sekund dla 1 mln zdarzeń do 52 sekund dla 100 mln zdarzeń.
Jak ładowanie przyrostowe skraca czas przesyłania danych?
Ładowanie przyrostowe pozwala dopisywać nowe zdarzenia do istniejącego zbioru zamiast przesyłać go ponownie w całości. Przy aktualizacji rosnącego dziennika zdarzeń ogranicza ilość przesyłanych danych.
| Scenariusz | Ponowne przesłanie całości | Przesłanie przyrostu | Oszczędność czasu |
|---|---|---|---|
| 10 mln danych bazowych + 500 tys. nowych zdarzeń (100 Mb/s) | przesyłanie: 4 min | przesyłanie: 5 s | ~4 min |
| 20 mln danych bazowych + 2 mln nowych zdarzeń (100 Mb/s) | przesyłanie: 7 min | przesyłanie: 44 s | ~6 min |
| 50 mln danych bazowych + 5 mln nowych zdarzeń (100 Mb/s) | przesyłanie: 18 min | przesyłanie: 2 min | ~16 min |
Po przesłaniu przyrostu wstępne przetwarzanie jest ponownie wykonywane na połączonym zbiorze danych. W teście trwało to od 1 do 2,5 minuty. Oszczędność wynika z przesyłania tylko nowych zdarzeń.
Plik przyrostowy musi mieć taki sam format i układ kolumn jak plik przesłany pierwotnie. Szczegóły opisano w przewodniku po przyrostowym ładowaniu danych.
Kiedy warto przesyłać dane przez API?
Przy regularnych przesyłkach lub plikach o rozmiarze kilku gigabajtów łatwiej zarządzać przesyłaniem przez API niż przez przeglądarkę. Skrypt lub narzędzie wiersza poleceń można włączyć do potoku ETL, zaplanować przesyłanie i śledzić jego postęp.
ProcessMind udostępnia podpisane adresy URL do bezpośredniego przesyłania danych do pamięci masowej w chmurze. Adres URL przesyłania można skopiować z menu ustawień zbioru danych w interfejsie ProcessMind.
# Upload a Parquet file directly using a presigned URL
curl -X PUT "$PRESIGNED_URL" --upload-file data.parquet
W dokumentacji API znajdują się przykłady dla Bash, JavaScript i Python, w tym instrukcje pobierania podpisanych adresów URL i przesyłania plików przyrostowych.
Kiedy warto podzielić zbiór danych?
Zbiór danych warto podzielić, gdy konkretna analiza wymaga tylko jego części albo gdy osobne grupy trzeba porównać niezależnie. Dane można podzielić według lokalizacji, działu, linii produktowej, okresu lub typu przypadku, a następnie analizować każdą część osobno.
Dane powinny pozostać w jednym zbiorze, jeśli analiza wymaga porównania grup lub śledzenia całego procesu między nimi. Przed podziałem warto sprawdzić, czy nie zmienia on znaczenia przypadku ani nie usuwa zdarzeń potrzebnych do zrozumienia jego przebiegu. Na przykład przy podziale według czasu trzeba uwzględnić przypadki, które zaczynają się w jednym okresie, a kończą w kolejnym.
Sprawdź wydajność na własnych danych
Testy porównawcze pomagają w planowaniu, ale nie pozwalają przewidzieć wyników dla każdego dziennika zdarzeń, łącza ani zapytania. Warto przetestować zbiór, który ma być używany, a następnie sprawdzić czas przesyłania i wstępnego przetwarzania oraz czas odpowiedzi najważniejszych widoków dashboardu.
Jeśli potrzebują Państwo pomocy w przygotowaniu dziennika zdarzeń, najpierw zapoznajcie się z zaleceniami dotyczącymi przygotowania danych. Warto też sprawdzić, jak analizować proces i jak stale monitorować proces.
Sprawdź działanie na zbiorze o docelowej wielkości
Wczytaj dziennik zdarzeń, który ma być analizowany, i sprawdź jego działanie na własnych danych.