流程挖掘性能:基准数据与优化建议
了解数据量、文件格式和查询方式如何影响流程挖掘性能,并查看针对10万至1亿条事件的基准测试结果及测试日期。

流程挖掘的性能不只取决于事件数量。文件大小、案例数量、查询结构和网络吞吐量都会影响等待时间。以下基准测试涵盖从100K到100M条事件的数据集,于2026年3月在生产环境中的AWS基础设施上运行,采用本文所述的文件格式和测试条件。
要点总结
- 大文件或网络连接较慢时,上传时间可能占据大部分等待时间。
- Parquet和ORC文件比原始CSV小得多,可缩短传输时间。
- 仪表板的响应时间取决于查询类型。统计数据响应较快,而事件数量增加时,流程图的加载时间会更长。
- 增量加载只传输新增事件,无需再次上传完整数据集。
- 聚焦的数据集上传更快,也更便于分析。
哪些因素会影响流程挖掘性能?
性能受四个因素影响:数据量、事件日志结构、运行的查询,以及用于传输和处理数据的环境。
- **事件数和案例数:**事件越多,通常需要上传和处理的数据也越多。案例数决定了分析涵盖多少个流程实例。
- **查询类型:**汇总统计和流程走向需要不同的计算。计算活动间转换关系的查询,可能比查询预聚合数据耗时更长。
- **活动数和案例长度:**不同活动越多、案例越长,计算流程走向和变体所需的工作量就越大。
- **文件大小和网速:**两者决定上传耗时。包含大量长文本字段的宽表CSV,可能比记录相同事件的紧凑列式文件大得多。
仅凭事件数无法预测数据集需要处理多久。请将基准测试作为参考,再针对计划使用的事件日志和查询进行测试。这是评估您所在环境中流程挖掘性能的有效方法。
数据处理流程:时间都花在哪里?
数据集会经过三个阶段:上传、预处理,以及更改流程模型后重新计算。
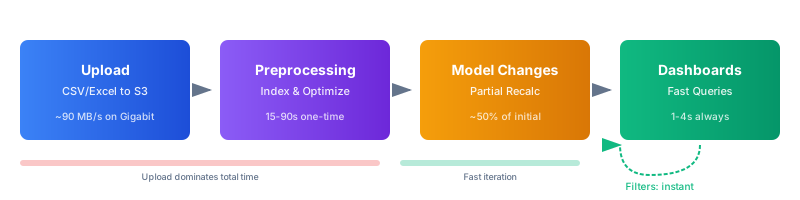
- **上传:**文件通过互联网传输到ProcessMind云基础设施。网络吞吐量和文件大小决定传输耗时。例如,包含5000万个事件、大小为11GB的CSV文件,在1Gbps网速下约需2分钟,在100Mbps下约需18分钟,在10Mbps下则超过3小时。同一批数据若保存为1.7GB的Parquet文件,在上述网速下分别约需19秒、3分钟和28分钟。
- **预处理:**上传后,系统会将数据转换为优化的列式存储、为事件建立索引、计算活动转换关系和流程变体,并生成汇总统计。在下方的基准测试中,处理10万个事件需35秒,处理1亿个事件最多需2.5分钟。
- **模型变更:**更改活动映射,或添加、移除活动时,ProcessMind会更新依赖模型的计算结果。在下方的基准测试中,处理100万个事件约需14秒,处理1亿个事件约需52秒。筛选条件变更会立即生效。
对于大型数据集,缩小文件体积通常是减少首次等待时间的有效方法。预处理完成后,查询性能取决于仪表板需要计算的内容。
查询性能有哪些差异?
不同查询的计算开销各不相同。了解以下特点,有助于您预估性能并合理组织数据。
- **活动数量:**包含10至20种不同活动的模型更易分析和展示。活动超过50种时,流程计算耗时会更长,也可能更难阅读。若符合流程实际情况,可将相关步骤归为一组。
- **变体多样性:**大多数案例沿少数几条路径执行的流程,通常比每个案例都走不同路径的流程更快分析。较高的差异可能有实际意义,但也会增加查询时间。
- **列数:**流程分析需要CaseId、Activity和Timestamp这几个核心字段。其他属性可用于筛选和分类,但会增加传输和扫描的数据量。
- **案例长度:**包含50个事件的案例比包含5个事件的案例需要更多处理。案例跨越数百个事件的流程,查询耗时可能更长。
仪表板响应时间
这些中位数来自多轮基准测试。每个仪表板组件都会独立查询,并行加载。
| 数据集 | 统计信息 | 流程 | 变体 | 类别 | 数据浏览器 | 动画 |
|---|---|---|---|---|---|---|
| 100K | 0.6s | 1.5s | 1.1s | 1.5s | 1.2s | 1.4s |
| 1M | 0.6s | 1.6s | 1.4s | 1.9s | 1.5s | 2.0s |
| 5M | 0.6s | 2.5s | 1.8s | 2.4s | 1.3s | 2.1s |
| 10M | 0.6s | 3.4s | 2.2s | 2.5s | 1.6s | 2.4s |
| 20M | 0.6s | 3.9s | 2.7s | 3.3s | 1.9s | 3.6s |
| 50M | 0.6s | 5.1s | 4.2s | 5.7s | 1.6s | 2.7s |
| 100M | 0.6s | 7.2s | 3.5s | 4.7s | 1.6s | 5.0s |
在测试的不同数据规模下,统计信息的耗时均约为0.6秒。随着事件数量增加,流程查询耗时也随之增加,因为需要计算活动之间的转换。变体和类别的耗时适度增长;数据浏览器通过分页保持响应。动画耗时则取决于显示的活跃案例数量。
在100万至1000万条事件的范围内,各组件的实测响应时间为0.6至3.4秒。事件达到5000万条时,流程和类别查询耗时约为5至6秒。这些是基准测试结果,并不保证适用于所有数据集或环境。
基准测试数据:测试条件是什么?
这些基准测试于2026年3月在AWS生产环境中进行。上传和预处理时间为多轮测试的平均值,仪表板响应时间为多轮测试的中位数。每种数据集规模均测试了50多种查询类型。
以下事件数量为测试文件中的实际数量。文件大小按未压缩CSV计算,采用典型的事件日志结构:CaseId、Activity、Timestamp和5至8个业务属性。您的文件大小和测试结果会因列数、内容、网络状况、与数据中心的距离及当前负载而异。
上传和预处理时间
| 数据集 | 实际事件数 | 文件大小 | 上传(1 Gbps) | 上传(100 Mbps) | 上传(50 Mbps) | 上传(10 Mbps) | 预处理 |
|---|---|---|---|---|---|---|---|
| 100K | 125,260 | 22 MB | < 1s | 2s | 4s | 22s | 35s |
| 500K | 626,300 | 110 MB | 1s | 11s | 22s | 2 min | 45s |
| 1M | 1,253,424 | 221 MB | 3s | 22s | 44s | 4 min | 55s |
| 2M | 2,506,848 | 443 MB | 5s | 44s | 1.5 min | 7 min | 1 min |
| 5M | 4,996,877 | 1.1 GB | 13s | 2 min | 4 min | 18 min | 1.5 min |
| 10M | 12,511,867 | 2.2 GB | 25s | 4 min | 7 min | 37 min | 1.5 min |
| 20M | 25,023,734 | 4.4 GB | 50s | 7 min | 15 min | 1.2 hr | 2 min |
| 50M | 62,559,335 | 11.1 GB | 2 min | 18 min | 37 min | 3 hr | 2 min |
| 100M | 125,118,670 | 22.3 GB | 4 min | 37 min | 1.2 hr | 6 hr | 2.5 min |
测试中,向AWS eu-central-1传输的实测速率为88 MB/s。其他速度根据实际吞吐量估算:50 Mbps约为5 MB/s,100 Mbps约为10 MB/s,10 Mbps约为1 MB/s。实际吞吐量取决于您的网络和具体条件。
本次测试的预处理耗时为35秒至2.5分钟。文件越大,上传耗时越长,因此大文件的等待时间主要花在上传上。
文件格式:Parquet和ORC与CSV对比
ProcessMind支持CSV、Parquet、ORC、Excel和XES。此处的文件大小对比采用与上述基准测试相同的事件数量和结构。
| 数据集 | CSV | Parquet | ORC | CSV.GZ |
|---|---|---|---|---|
| 1M条事件 | 221 MB | 34 MB | 39 MB | 20 MB |
| 5M条事件 | 1.1 GB | 151 MB | 197 MB | 107 MB |
| 10M条事件 | 2.2 GB | 301 MB | 395 MB | 215 MB |
| 20M条事件 | 4.4 GB | 603 MB | 791 MB | 430 MB |
| 50M条事件 | 11.1 GB | 1.7 GB | 1.9 GB | 1.1 GB |
| 100M条事件 | 22.3 GB | 3.4 GB | 3.7 GB | 2.2 GB |
在这些测试中,Parquet文件比CSV小约85%,ORC文件小约82%。两者都是内置压缩的列式格式。Spark、Databricks、dbt和BigQuery等数据工具可能支持导出为这些格式。
Parquet、ORC和CSV的预处理耗时相近。事件数量较大时,CSV.GZ耗时更长,因为gzip文件无法拆分并行解压。
| 数据集 | Parquet | ORC | CSV | CSV.GZ |
|---|---|---|---|---|
| 1M条事件 | 55s | 55s | 55s | 55s |
| 5M条事件 | 1.5 min | 1.5 min | 1.5 min | 1.5 min |
| 10M条事件 | 1.5 min | 1.5 min | 1.5 min | 2 min |
| 20M条事件 | 2 min | 2 min | 2 min | 2.5 min |
| 50M条事件 | 2 min | 2 min | 2 min | 3 min |
| 100M条事件 | 2.5 min | 2.5 min | 2.5 min | 4.5 min |
总耗时包括上传和预处理。以下示例采用100 Mbps连接。
| 10M条事件(100 Mbps) | 文件大小 | 上传 | 预处理 | 总计 |
|---|---|---|---|---|
| Parquet | 301 MB | 30s | 1.5 min | 约2 min |
| ORC | 395 MB | 40s | 1.5 min | 约2.2 min |
| CSV | 2.2 GB | 4 min | 1.5 min | 约5.5 min |
| CSV.GZ | 215 MB | 21s | 2 min | 约2.5 min |
| 50M条事件(100 Mbps) | 文件大小 | 上传 | 预处理 | 总计 |
|---|---|---|---|---|
| Parquet | 1.7 GB | 3 min | 2 min | 约5 min |
| ORC | 1.9 GB | 3.2 min | 2 min | 约5.2 min |
| CSV | 11.1 GB | 18 min | 2 min | 约20 min |
| CSV.GZ | 1.1 GB | 2 min | 3 min | 约5 min |
对于大型数据集,Parquet和ORC文件更小,因此能缩短传输时间。CSV格式简单直接,适用于较小的数据集,或导出流程不支持列式格式的情况。网络较慢时,CSV.GZ有助于缩短传输时间,但数据集越大,解压耗时越长。
选择文件格式
- **Parquet:**如果您的数据管道支持,这是处理大型数据集的不错选择。在这些测试中,它生成的文件最小。
- **ORC:**也是类似的选择,尤其适用于使用Hadoop或Spark的数据管道。
- **CSV:**简单且广泛支持,适合较小的数据集。
- **CSV.GZ:**如果上传速度是主要限制,可考虑使用。尤其是事件数量较大时,请用您自己的数据测试预处理耗时。
哪些查询模式会拖慢分析?
某些数据和仪表板模式需要更多处理。您可以通过以下检查,找出可能导致查询变慢的原因。
- **活动过多:**包含50多种不同活动的流程计算耗时可能更长,也可能难以理解。适当合并相关步骤。
- **变体过多:**案例路径差异越多,变体计算需要处理的内容就越多。较高的差异也可能反映出值得调查的流程行为。
- **案例过长:**事件数量较多的案例比短案例需要更多处理。
- **不必要的列:**额外属性会增大文件,也可能增加查询处理量。请保留分析所需的字段。
- **仪表板过大、组件过多:**每张图表或每个磁贴都会单独执行查询。请保留能回答明确问题的组件,并将其他视图放在单独的仪表板中。
- **可视化计算量大:**大型数据集中的类别较多时,图表渲染可能更慢。如果不需要详细拆分,请使用汇总视图。
- **活跃案例过多的动画:**动画耗时取决于显示的案例数量。如果只需查看流程,可降低播放速度,或关闭尾迹和特效。
如何选择合适的数据量?
从能回答问题的最小数据集开始。范围明确的数据集上传更快,也更容易验证。需要覆盖更多情况、分析罕见事件或观察长期趋势时,再扩大数据范围。
用较小的数据集构建并验证
先选取近期样本、配置模型,并检查数据,再扩大数据范围。
- **先从样本开始。**例如,提取近期三个月内的100万条事件。在基准测试中,使用1 Gbps上传耗时3秒,使用100 Mbps耗时22秒,之后还需55秒预处理。
- **构建模型。**配置活动、筛选条件和视图。对于测试中包含100万至1000万条事件的数据集,模型变更耗时约14至20秒。
- **验证发现。**检查活动名称和流程路径是否合理,并解决数据质量问题。
- **按需增加数据。**需要调查罕见案例或比较更长时间段时,再增加事件数量。
下表比较了使用100 Mbps连接时,不同事件数量对应的初始等待时间。
| 方案 | 上传(100 Mbps) | 预处理 | 总等待时间 | 仪表板响应速度 |
|---|---|---|---|---|
| 从100万条事件开始 | 22s | 55s | 约1.5 min | 1–2s |
| 从500万条事件开始 | 2 min | 1.5 min | 约3.5 min | 1–2.5s |
| 从5000万条事件开始 | 18 min | 2 min | 约20 min | 1–6s |
合适的事件数量取决于您要解决的问题。较小的数据集或许足以识别常见流程模式;如果要研究罕见事件,或需要覆盖完整总体,则可能需要更多数据。
问题明确时,按范围筛选数据
如果您要调查某个国家、部门或产品线,可先分析该范围,而不是合并无关群组。分段分析有助于清晰比较,也能减少需要处理的数据量。
例如,基准测试介绍了一个涵盖8个国家、包含4200万条货运事件的欧洲物流数据集:
- 所有国家:4200万条事件,9.3 GB;使用100 Mbps上传需16分钟,预处理需2分钟。
- 德国:850万条事件,1.9 GB;上传需3分钟,预处理需1.5分钟。
- 荷兰:310万条事件,690 MB;上传需1分钟,预处理需1分钟。
验证各个数据分段后,您可以进行比较。可按地理区域、组织、产品、时间段和客户群体等维度划分。
筛选所需案例
如果您要调查异常情况,只导出相关案例可以大幅缩小数据集。例如,基准测试介绍了一个采购到付款流程,其中有120万张采购订单和840万条事件。测试报告显示,9.6万张订单(占8%)存在异常,例如拒绝、退货、重复发票或缺少审批。
在这项分析中,只导出异常案例可将数据集从840万条事件缩减至67万条。报告中的文件大小从1.9 GB降至150 MB;使用100 Mbps上传的时间从3分钟缩短至15秒。基准测试中,将相同数据导出为15 MB的Parquet文件,上传耗时不到2秒。
如果状态、活动、案例时长、时间段或业务单元等字段与您的分析问题相关,可按这些字段筛选。
只保留所需列
每一列都会增加文件大小。长文本字段、冗余标识符、审计字段和技术元数据可能对分析没有帮助。
基准测试介绍了一份SAP导出文件,其中包含180万条采购订单事件和45列。将其精简至12个必要列后,文件大小从2.1 GB降至380 MB。将这些列导出为Parquet后,文件进一步缩小至58 MB。报告中的100 Mbps上传时间从3.5分钟缩短至6秒。
请保留分析所需的字段,包括CaseId、Activity、Timestamp,以及状态、金额、类别或区域等相关业务属性。分析不需要的个人信息应予以删除。
何时需要使用更大的数据集?
如果问题涉及覆盖范围或时间跨度,可能需要增加事件数量。
- **罕见事件:**要在10万个案例中发现仅发生一次的异常,数据总体必须足够大。如果异常发生率为0.01%,而您希望研究50个异常案例,则需要约50万个案例。
- **低频变体:**发生率为0.1%的变体,在包含100万条事件的样本中可能难以发现,在包含5000万条事件的总体中则更容易衡量。
- **合规与审计:**某些要求需要覆盖完整总体,而不是抽样。
- **长期趋势:**比较2024年第一季度、2025年第一季度和2026年第一季度,需要涵盖这三个时段的数据。通过增量加载逐步补齐数据。
对于超过5000万条事件的数据集,基准测试建议使用Parquet,通过API上传,并尽可能使用高速网络连接。测试中的5000万条事件CSV文件为11.1 GB,而Parquet文件为1.7 GB。
性能始终需要权衡:更多数据和更快速度都意味着更高成本。关键不在于工具能处理多少数据,而在于您的流程实际需要什么。ProcessMind可支持大规模数据,但我们仍建议谨慎对待超大型数据集,因为它们往往并非必需,还会增加复杂性,使注意力偏离流程改进本身。
如何让模型和界面保持响应迅速?
数据量只是影响因素之一。流程模型和仪表板的设计也会影响您的操作效率。
- **保持模型清晰易读:**将大型流程拆分为模块化的Subprocess。画布上可见元素过多时,渲染可能更慢,导航也更困难。结构调整后,请使用自动布局。
- **谨慎选择仪表板组件:**每张图表和每个磁贴都需要计算。请保留能回答当前问题的视图。
- **选择适合数据的图表:**大型数据集中的类别较多时,可视化计算可能更慢。如果不需要详细拆分,请使用汇总视图。
- **筛选条件应围绕问题设置:**筛选条件有助于缩小分析范围。避免组合与当前问题无关的筛选条件。
- **调整动画设置:**活跃案例越多,动画处理量越大。如果只需查看流程,可降低播放速度,或关闭尾迹和特效。请参阅流程动画。
- **只重新计算发生变化的部分:**模型变更会更新依赖模型的计算,无需重新执行完整预处理。在基准测试中,变更耗时从100万条事件时的约14秒,到1亿条事件时的52秒不等。
增量加载如何缩短上传时间?
增量加载可将新事件追加到现有数据集,无需再次上传完整数据集。刷新不断增长的事件日志时,它能减少需要传输的数据量。
| 场景 | 完整重新上传 | 增量上传 | 节省时间 |
|---|---|---|---|
| 1000万条基础数据+50万条新事件(100 Mbps) | 上传4 min | 上传5s | 约4 min |
| 2000万条基础数据+200万条新事件(100 Mbps) | 上传7 min | 上传44s | 约6 min |
| 5000万条基础数据+500万条新事件(100 Mbps) | 上传18 min | 上传2 min | 约16 min |
增量上传后,系统会对合并后的数据集重新执行预处理。基准测试中,这一步耗时1至2.5分钟。上传节省的时间来自只传输新增事件。
增量文件必须与原始上传文件采用相同的格式和列结构。详情请参阅增量数据加载指南。
何时应使用API上传?
对于定期上传或数GB大小的文件,使用API上传可能比通过浏览器传输更便于管理。脚本或命令行工具可集成到ETL管道中,支持定时上传并显示传输进度。
ProcessMind提供预签名URL,可直接上传至云存储。您可以在ProcessMind界面的数据集设置菜单中复制上传URL。
# Upload a Parquet file directly using a presigned URL
curl -X PUT "$PRESIGNED_URL" --upload-file data.parquet请参阅API文档,了解Bash、JavaScript和Python示例,包括如何获取预签名URL及上传增量文件。
何时应拆分数据集?
如果某项分析只需使用部分数据,或需要分别比较不同群组,可拆分数据集。您可以按地理区域、部门、产品线、时间段或案例类型划分,再分别分析各个数据集。
如果问题需要比较不同群组,或追踪跨群组的完整流程,则应保留数据整体。在拆分前,请确认拆分不会改变案例含义,也不会删去理解案例路径所需的事件。例如,按时间拆分时,应考虑在一个时段开始、另一个时段结束的案例。
使用您自己的数据测试性能
基准测试有助于规划,但无法预测每个事件日志、网络或查询的结果。请用预期使用的数据集进行测试,并检查上传时间、预处理时间,以及您关注的仪表板视图响应时间。
如需了解如何整理事件日志,请先阅读数据准备指南。您还可以查看如何分析流程以及如何持续监控流程。
根据您自己的数据量进行测试
加载您计划分析的事件日志,使用自己的数据测试运行表现。