ประสิทธิภาพของ process mining: ผลทดสอบและเคล็ดลับ
ดูว่าปริมาณข้อมูล รูปแบบไฟล์ และลักษณะคิวรีส่งผลต่อประสิทธิภาพของ process mining อย่างไร พร้อมผลทดสอบที่ระบุวันที่ ครอบคลุมข้อมูลตั้งแต่ 100K ถึง 100M เหตุการณ์.

ประสิทธิภาพของ process mining ไม่ได้ขึ้นอยู่กับจำนวนเหตุการณ์เพียงอย่างเดียว ขนาดไฟล์ จำนวนเคส ลักษณะคิวรี และความเร็วเครือข่ายล้วนมีผลต่อเวลาที่ต้องรอ ผลทดสอบด้านล่างครอบคลุมชุดข้อมูลตั้งแต่ 100K ถึง 100M เหตุการณ์ โดยทดสอบบนโครงสร้างพื้นฐาน AWS สำหรับระบบจริงในเดือนมีนาคม 2026 ด้วยรูปแบบไฟล์และเงื่อนไขการทดสอบที่ระบุไว้ในหน้านี้.
ประเด็นสำคัญ
- ไฟล์ขนาดใหญ่หรือการเชื่อมต่อที่ช้าอาจทำให้เวลาอัปโหลดเป็นส่วนที่ใช้เวลานานที่สุด
- ไฟล์ Parquet และ ORC มีขนาดเล็กกว่า CSV ที่ไม่บีบอัดมาก จึงช่วยลดเวลาถ่ายโอน
- เวลาตอบสนองของแดชบอร์ดขึ้นอยู่กับคำค้น สถิติตอบสนองได้เร็ว ส่วนการคำนวณเส้นทางกระบวนการใช้เวลานานขึ้นเมื่อจำนวนเหตุการณ์เพิ่มขึ้น
- การโหลดข้อมูลส่วนเพิ่มจะถ่ายโอนเหตุการณ์ใหม่ โดยไม่ต้องอัปโหลดชุดข้อมูลทั้งหมดซ้ำ
- ชุดข้อมูลที่เลือกมาอย่างตรงประเด็นอัปโหลดได้เร็วขึ้นและวิเคราะห์ได้ง่ายขึ้น
อะไรส่งผลต่อประสิทธิภาพของ process mining?
ประสิทธิภาพขึ้นอยู่กับปัจจัย 4 อย่าง ได้แก่ ปริมาณข้อมูล โครงสร้างของบันทึกเหตุการณ์ คิวรีที่เรียกใช้ และสภาพแวดล้อมที่ใช้ถ่ายโอนและประมวลผลข้อมูล.
- จำนวนเหตุการณ์และจำนวนเคส: โดยทั่วไป ยิ่งมีเหตุการณ์มาก ก็ยิ่งต้องอัปโหลดและประมวลผลข้อมูลมาก จำนวนเคสกำหนดว่าการวิเคราะห์ของคุณครอบคลุมกระบวนการกี่รายการ
- ลักษณะคิวรี: การคำนวณสถิติสรุปกับ process flow ต้องใช้วิธีคำนวณต่างกัน คิวรีที่คำนวณการเปลี่ยนผ่านระหว่างกิจกรรมอาจใช้เวลานานกว่าคิวรีที่ใช้ข้อมูลสรุปไว้ล่วงหน้า
- จำนวนกิจกรรมและความยาวเคส: กิจกรรมที่แตกต่างกันมากขึ้นและเคสที่ยาวขึ้นเพิ่มงานในการคำนวณ flow และรูปแบบกระบวนการ
- ขนาดไฟล์และความเร็วเครือข่าย: ปัจจัยเหล่านี้กำหนดเวลาอัปโหลด CSV ที่มีหลายคอลัมน์และข้อความยาวอาจมีขนาดใหญ่กว่าไฟล์คอลัมน์แบบกระชับที่มีเหตุการณ์ชุดเดียวกันมาก.
จำนวนเหตุการณ์เพียงอย่างเดียวใช้คาดการณ์เวลาในการประมวลผลชุดข้อมูลไม่ได้ ใช้ผลทดสอบเป็นข้อมูลอ้างอิง แล้วทดลองกับบันทึกเหตุการณ์และคิวรีที่คุณจะใช้ การทดสอบในสภาพแวดล้อมของคุณเองเป็นวิธีประเมินประสิทธิภาพ process mining ที่เหมาะที่สุด.
ไปป์ไลน์ข้อมูลใช้เวลาตรงไหนบ้าง?
ชุดข้อมูลผ่าน 3 ขั้นตอน ได้แก่ การอัปโหลด การประมวลผลเบื้องต้น และการคำนวณใหม่เมื่อคุณเปลี่ยนโมเดลกระบวนการ.
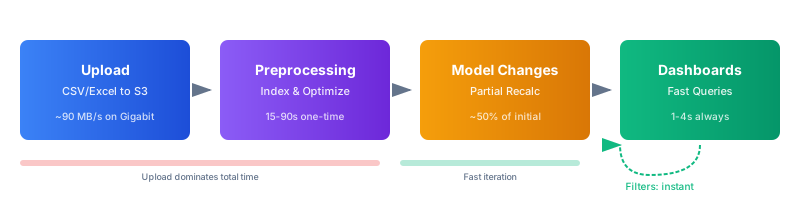
- อัปโหลด: ไฟล์ของคุณจะถูกส่งผ่านอินเทอร์เน็ตไปยังโครงสร้างพื้นฐานคลาวด์ของ ProcessMind ความเร็วเครือข่ายและขนาดไฟล์เป็นตัวกำหนดเวลาถ่ายโอน ตัวอย่างเช่น ไฟล์ CSV ขนาด 11 GB ที่มี 50 ล้านเหตุการณ์ใช้เวลาประมาณ 2 นาทีบนเครือข่าย 1 Gbps, 18 นาทีบน 100 Mbps หรือมากกว่า 3 ชั่วโมงบน 10 Mbps ข้อมูลชุดเดียวกันในไฟล์ Parquet ขนาด 1.7 GB ใช้เวลาประมาณ 19 วินาที 3 นาที หรือ 28 นาทีตามลำดับ
- การประมวลผลเบื้องต้น: หลังอัปโหลด ระบบจะแปลงข้อมูลเป็นพื้นที่จัดเก็บแบบคอลัมน์ที่ปรับประสิทธิภาพแล้ว จัดทำดัชนีเหตุการณ์ คำนวณการเปลี่ยนผ่านระหว่างกิจกรรมและรูปแบบกระบวนการ พร้อมสร้างสถิติสรุป ในผลทดสอบด้านล่าง ขั้นตอนนี้ใช้เวลา 35 วินาทีสำหรับ 100K เหตุการณ์ และสูงสุด 2.5 นาทีสำหรับ 100M เหตุการณ์
- การเปลี่ยนโมเดล: เมื่อคุณเปลี่ยนการจับคู่กิจกรรม หรือเพิ่มหรือลบกิจกรรม ProcessMind จะอัปเดตการคำนวณที่ขึ้นอยู่กับโมเดล ผลทดสอบด้านล่างใช้เวลาประมาณ 14 วินาทีสำหรับ 1M เหตุการณ์ และ 52 วินาทีสำหรับ 100M เหตุการณ์ การเปลี่ยนตัวกรองมีผลทันที.
สำหรับชุดข้อมูลขนาดใหญ่ การลดขนาดไฟล์มักเป็นวิธีที่ได้ผลที่สุดในการลดเวลารอช่วงแรก หลังประมวลผลเบื้องต้นแล้ว ประสิทธิภาพของคิวรีจะขึ้นอยู่กับสิ่งที่แดชบอร์ดต้องคำนวณ.
ประสิทธิภาพของคำค้นแตกต่างกันอย่างไร?
คิวรีแต่ละแบบใช้ทรัพยากรไม่เท่ากัน ลักษณะต่อไปนี้ช่วยให้คุณประเมินผลที่คาดหวังและเตรียมข้อมูลได้เหมาะสม.
- จำนวนกิจกรรม: โมเดลที่มีกิจกรรมแตกต่างกัน 10–20 รายการจะวิเคราะห์และแสดงผลได้ง่ายกว่า หากมีมากกว่า 50 รายการ การคำนวณโฟลว์กระบวนการจะใช้เวลานานขึ้นและอ่านยากขึ้น ควรรวมขั้นตอนที่เกี่ยวข้องกันเมื่อการรวมดังกล่าวสะท้อนกระบวนการได้อย่างถูกต้อง
- ความหลากหลายของรูปแบบ: โดยทั่วไป กระบวนการที่เคสส่วนใหญ่ดำเนินไปตามเส้นทางไม่กี่แบบจะวิเคราะห์ได้เร็วกว่ากระบวนการที่แต่ละเคสมีเส้นทางต่างกัน ความหลากหลายสูงอาจมีความหมาย แต่ก็ทำให้เวลาค้นข้อมูลเพิ่มขึ้นได้
- จำนวนคอลัมน์: ฟิลด์หลัก ได้แก่ CaseId, Activity และ Timestamp จำเป็นต่อการวิเคราะห์กระบวนการ คุณลักษณะเพิ่มเติมช่วยกรองและจัดหมวดหมู่ข้อมูล แต่ก็เพิ่มปริมาณข้อมูลที่ต้องถ่ายโอนและสแกน
- ความยาวของเคส: เคสที่มี 50 เหตุการณ์ต้องใช้การประมวลผลมากกว่าเคสที่มี 5 เหตุการณ์ กระบวนการที่เคสมีเหตุการณ์หลายร้อยรายการอาจใช้เวลาค้นข้อมูลนานขึ้น
เวลาตอบสนองของแดชบอร์ด
ค่ามัธยฐานเหล่านี้มาจากการทดสอบหลายรอบ องค์ประกอบแต่ละรายการในแดชบอร์ดจะส่งคิวรีแยกกันและโหลดพร้อมกัน.
| ชุดข้อมูล | สถิติ | Process Flow | Variants | Categories | Data Browser | Animation |
|---|---|---|---|---|---|---|
| 100K | 0.6s | 1.5s | 1.1s | 1.5s | 1.2s | 1.4s |
| 1M | 0.6s | 1.6s | 1.4s | 1.9s | 1.5s | 2.0s |
| 5M | 0.6s | 2.5s | 1.8s | 2.4s | 1.3s | 2.1s |
| 10M | 0.6s | 3.4s | 2.2s | 2.5s | 1.6s | 2.4s |
| 20M | 0.6s | 3.9s | 2.7s | 3.3s | 1.9s | 3.6s |
| 50M | 0.6s | 5.1s | 4.2s | 5.7s | 1.6s | 2.7s |
| 100M | 0.6s | 7.2s | 3.5s | 4.7s | 1.6s | 5.0s |
สถิติใช้เวลาประมาณ 0.6 วินาทีในทุกขนาดที่ทดสอบ ส่วน Process Flow ใช้เวลานานขึ้นเมื่อจำนวนเหตุการณ์เพิ่ม เพราะต้องคำนวณการเปลี่ยนผ่านระหว่างกิจกรรม รูปแบบกระบวนการและหมวดหมู่ใช้เวลาเพิ่มขึ้นในระดับปานกลาง ส่วนเบราว์เซอร์ข้อมูลยังตอบสนองได้ดีด้วยการแบ่งหน้า เวลาแสดงภาพเคลื่อนไหวเปลี่ยนไปตามจำนวนเคสที่กำลังแสดง.
เมื่อมี 1M ถึง 10M เหตุการณ์ เวลาตอบสนองที่วัดได้อยู่ระหว่าง 0.6 ถึง 3.4 วินาที ขึ้นอยู่กับองค์ประกอบ เมื่อมี 50M เหตุการณ์ Process Flow และหมวดหมู่ใช้เวลาประมาณ 5–6 วินาที ตัวเลขเหล่านี้เป็นผลทดสอบ ไม่ใช่การรับประกันสำหรับทุกชุดข้อมูลหรือทุกสภาพแวดล้อม.
ข้อมูลการทดสอบ: ใช้เงื่อนไขใดบ้าง?
ทดสอบบนโครงสร้างพื้นฐาน AWS สำหรับระบบจริงในเดือนมีนาคม 2026 เวลาอัปโหลดและประมวลผลเบื้องต้นเป็นค่าเฉลี่ยจากการทดสอบหลายรอบ ส่วนเวลาตอบสนองของแดชบอร์ดเป็นค่ามัธยฐานจากหลายรอบ การทดสอบครอบคลุมคิวรีมากกว่า 50 ประเภทต่อชุดข้อมูลแต่ละขนาด.
จำนวนเหตุการณ์ด้านล่างเป็นจำนวนจริงในไฟล์ทดสอบ ขนาดไฟล์อ้างอิงจาก CSV ที่ยังไม่บีบอัดและใช้โครงสร้างบันทึกเหตุการณ์ทั่วไป ได้แก่ CaseId, Activity, Timestamp และคุณลักษณะทางธุรกิจ 5–8 รายการ ขนาดไฟล์และผลลัพธ์ของคุณอาจแตกต่างกันตามจำนวนคอลัมน์ เนื้อหา สภาพเครือข่าย ระยะห่างจากศูนย์ข้อมูล และปริมาณงานในขณะนั้น
เวลาอัปโหลดและประมวลผลเบื้องต้น
| ชุดข้อมูล | จำนวนเหตุการณ์จริง | ขนาดไฟล์ | อัปโหลด (1 Gbps) | อัปโหลด (100 Mbps) | อัปโหลด (50 Mbps) | อัปโหลด (10 Mbps) | ประมวลผลเบื้องต้น |
|---|---|---|---|---|---|---|---|
| 100K | 125,260 | 22 MB | < 1s | 2s | 4s | 22s | 35s |
| 500K | 626,300 | 110 MB | 1s | 11s | 22s | 2 min | 45s |
| 1M | 1,253,424 | 221 MB | 3s | 22s | 44s | 4 min | 55s |
| 2M | 2,506,848 | 443 MB | 5s | 44s | 1.5 min | 7 min | 1 min |
| 5M | 4,996,877 | 1.1 GB | 13s | 2 min | 4 min | 18 min | 1.5 min |
| 10M | 12,511,867 | 2.2 GB | 25s | 4 min | 7 min | 37 min | 1.5 min |
| 20M | 25,023,734 | 4.4 GB | 50s | 7 min | 15 min | 1.2 hr | 2 min |
| 50M | 62,559,335 | 11.1 GB | 2 min | 18 min | 37 min | 3 hr | 2 min |
| 100M | 125,118,670 | 22.3 GB | 4 min | 37 min | 1.2 hr | 6 hr | 2.5 min |
อัตราถ่ายโอน 1 Gbps ที่วัดได้คือ 88 MB/s ไปยัง AWS eu-central-1 ส่วนความเร็วอื่นคำนวณประมาณการจากอัตราถ่ายโอนที่ใช้งานได้จริง ได้แก่ ประมาณ 5 MB/s ที่ 50 Mbps, 10 MB/s ที่ 100 Mbps และ 1 MB/s ที่ 10 Mbps ความเร็วจริงขึ้นอยู่กับเครือข่ายและสภาพแวดล้อมของคุณ.
ในการทดสอบนี้ การประมวลผลเบื้องต้นใช้เวลาตั้งแต่ 35 วินาทีถึง 2.5 นาที เวลาอัปโหลดเพิ่มตามขนาดไฟล์ จึงเป็นส่วนที่ใช้เวลารอนานที่สุดเมื่อไฟล์มีขนาดใหญ่.
รูปแบบไฟล์: เปรียบเทียบ Parquet และ ORC กับ CSV
ProcessMind รองรับ CSV, Parquet, ORC, Excel และ XES การเปรียบเทียบขนาดไฟล์นี้ใช้จำนวนเหตุการณ์และโครงสร้างข้อมูลเดียวกับผลทดสอบข้างต้น.
| ชุดข้อมูล | CSV | Parquet | ORC | CSV.GZ |
|---|---|---|---|---|
| 1M เหตุการณ์ | 221 MB | 34 MB | 39 MB | 20 MB |
| 5M เหตุการณ์ | 1.1 GB | 151 MB | 197 MB | 107 MB |
| 10M เหตุการณ์ | 2.2 GB | 301 MB | 395 MB | 215 MB |
| 20M เหตุการณ์ | 4.4 GB | 603 MB | 791 MB | 430 MB |
| 50M เหตุการณ์ | 11.1 GB | 1.7 GB | 1.9 GB | 1.1 GB |
| 100M เหตุการณ์ | 22.3 GB | 3.4 GB | 3.7 GB | 2.2 GB |
ในการทดสอบนี้ ไฟล์ Parquet มีขนาดเล็กกว่า CSV ประมาณ 85% ส่วนไฟล์ ORC เล็กกว่าประมาณ 82% ทั้งสองรูปแบบจัดเก็บข้อมูลเป็นคอลัมน์และมีการบีบอัดในตัว เครื่องมือข้อมูลอย่าง Spark, Databricks, dbt และ BigQuery อาจรองรับการส่งออกเป็นรูปแบบเหล่านี้.
เวลาในการประมวลผลเบื้องต้นใกล้เคียงกันสำหรับ Parquet, ORC และ CSV ส่วน CSV.GZ ใช้เวลานานขึ้นเมื่อจำนวนเหตุการณ์มาก เพราะไม่สามารถแบ่งไฟล์ gzip เพื่อคลายการบีบอัดพร้อมกันได้.
| ชุดข้อมูล | Parquet | ORC | CSV | CSV.GZ |
|---|---|---|---|---|
| 1M เหตุการณ์ | 55s | 55s | 55s | 55s |
| 5M เหตุการณ์ | 1.5 min | 1.5 min | 1.5 min | 1.5 min |
| 10M เหตุการณ์ | 1.5 min | 1.5 min | 1.5 min | 2 min |
| 20M เหตุการณ์ | 2 min | 2 min | 2 min | 2.5 min |
| 50M เหตุการณ์ | 2 min | 2 min | 2 min | 3 min |
| 100M เหตุการณ์ | 2.5 min | 2.5 min | 2.5 min | 4.5 min |
เวลารวมประกอบด้วยเวลาอัปโหลดและประมวลผลเบื้องต้น ตัวอย่างเหล่านี้ใช้การเชื่อมต่อ 100 Mbps.
| 10M เหตุการณ์ (100 Mbps) | ขนาดไฟล์ | อัปโหลด | ประมวลผลเบื้องต้น | รวม |
|---|---|---|---|---|
| Parquet | 301 MB | 30s | 1.5 min | ~2 min |
| ORC | 395 MB | 40s | 1.5 min | ~2.2 min |
| CSV | 2.2 GB | 4 min | 1.5 min | ~5.5 min |
| CSV.GZ | 215 MB | 21s | 2 min | ~2.5 min |
| 50M เหตุการณ์ (100 Mbps) | ขนาดไฟล์ | อัปโหลด | ประมวลผลเบื้องต้น | รวม |
|---|---|---|---|---|
| Parquet | 1.7 GB | 3 min | 2 min | ~5 min |
| ORC | 1.9 GB | 3.2 min | 2 min | ~5.2 min |
| CSV | 11.1 GB | 18 min | 2 min | ~20 min |
| CSV.GZ | 1.1 GB | 2 min | 3 min | ~5 min |
สำหรับชุดข้อมูลขนาดใหญ่ Parquet และ ORC ช่วยลดเวลาถ่ายโอนเพราะไฟล์มีขนาดเล็กกว่า CSV ยังเป็นตัวเลือกที่ใช้งานง่ายสำหรับชุดข้อมูลขนาดเล็ก หรือเมื่อขั้นตอนส่งออกข้อมูลของคุณไม่รองรับรูปแบบคอลัมน์ CSV.GZ ช่วยลดเวลาถ่ายโอนเมื่อเครือข่ายช้า แต่เมื่อชุดข้อมูลใหญ่ขึ้นก็ใช้เวลาคลายการบีบอัดนานขึ้น.
เลือกรูปแบบไฟล์
- Parquet: เหมาะเป็นตัวเลือกเริ่มต้นสำหรับชุดข้อมูลขนาดใหญ่ หากไปป์ไลน์ข้อมูลของคุณรองรับ ในการทดสอบนี้ไฟล์มีขนาดเล็กที่สุด
- ORC: เป็นอีกตัวเลือกที่ใกล้เคียง โดยเฉพาะเมื่อไปป์ไลน์ข้อมูลของคุณใช้ Hadoop หรือ Spark
- CSV: ใช้งานง่ายและรองรับอย่างแพร่หลาย เหมาะกับชุดข้อมูลขนาดเล็ก
- CSV.GZ: พิจารณาใช้เมื่อความเร็วอัปโหลดเป็นข้อจำกัดหลัก โดยเฉพาะเมื่อมีเหตุการณ์จำนวนมาก ควรทดสอบเวลาประมวลผลเบื้องต้นกับข้อมูลของคุณเอง
คำค้นแบบใดทำให้การวิเคราะห์ช้าลง?
ข้อมูลและแดชบอร์ดบางรูปแบบต้องใช้การประมวลผลมากกว่า ใช้รายการตรวจสอบเหล่านี้เพื่อหาสาเหตุที่อาจทำให้คิวรีช้า.
- มีกิจกรรมมากเกินไป: process flow ที่มีกิจกรรมแตกต่างกันมากกว่า 50 รายการอาจใช้เวลาคำนวณนานขึ้นและตีความได้ยาก ลองจัดกลุ่มขั้นตอนที่เกี่ยวข้องกัน
- มีรูปแบบกระบวนการที่ไม่ซ้ำกันจำนวนมาก: เมื่อเคสมีเส้นทางแตกต่างกันหลายแบบ การคำนวณรูปแบบกระบวนการก็ต้องทำงานมากขึ้น ความหลากหลายสูงอาจชี้ให้เห็นพฤติกรรมของกระบวนการที่ควรตรวจสอบ
- เคสยาว: เคสที่มีเหตุการณ์จำนวนมากต้องใช้การประมวลผลมากกว่าเคสสั้น
- มีคอลัมน์ที่ไม่จำเป็น: แอตทริบิวต์เพิ่มเติมทำให้ไฟล์ใหญ่ขึ้นและอาจเพิ่มภาระเมื่อเรียกใช้คิวรี เก็บเฉพาะฟิลด์ที่จำเป็นต่อการวิเคราะห์
- แดชบอร์ดขนาดใหญ่และมีองค์ประกอบแน่นเกินไป: แผนภูมิหรือการ์ดแต่ละรายการจะเรียกใช้คิวรีของตนเอง เก็บเฉพาะองค์ประกอบที่ตอบคำถามได้ชัดเจน และย้ายมุมมองอื่นไปไว้ในแดชบอร์ดแยก
- การแสดงผลที่ใช้ทรัพยากรมาก: เมื่อมีชุดข้อมูลขนาดใหญ่ แผนภูมิที่มีหลายหมวดหมู่อาจใช้เวลาแสดงผลนานขึ้น หากไม่ต้องการรายละเอียด ให้ใช้มุมมองสรุป
- ภาพเคลื่อนไหวที่มีเคสทำงานอยู่จำนวนมาก: เวลาแสดงภาพเคลื่อนไหวขึ้นอยู่กับจำนวนเคสที่นำมาแสดง หากต้องการตรวจสอบ flow อย่างเดียว ให้ลดความเร็วหรือปิดเส้นทางและเอฟเฟกต์.
ควรเลือกขนาดข้อมูลอย่างไรให้เหมาะสม?
เริ่มจากชุดข้อมูลที่เล็กที่สุดซึ่งตอบคำถามได้ ชุดข้อมูลที่เลือกมาเฉพาะส่วนจะอัปโหลดได้เร็วและตรวจสอบได้ง่ายกว่า เพิ่มข้อมูลเมื่อจำเป็นต้องวิเคราะห์ให้ครอบคลุมขึ้น ดูเหตุการณ์ที่พบไม่บ่อย หรือศึกษาแนวโน้มระยะยาว.
สร้างและตรวจสอบโมเดลด้วยชุดข้อมูลขนาดเล็ก
เริ่มจากข้อมูลตัวอย่างช่วงล่าสุด ตั้งค่าโมเดล แล้วตรวจสอบข้อมูลก่อนขยายขนาด.
- เริ่มจากข้อมูลตัวอย่าง ตัวอย่างเช่น ดึงข้อมูล 1M เหตุการณ์จากช่วง 3 เดือนล่าสุด ในการทดสอบ อัปโหลดใช้เวลา 3 วินาทีบนเครือข่าย 1 Gbps หรือ 22 วินาทีบน 100 Mbps จากนั้นประมวลผลเบื้องต้นอีก 55 วินาที
- สร้างโมเดล ตั้งค่ากิจกรรม ตัวกรอง และมุมมอง การเปลี่ยนโมเดลใช้เวลาประมาณ 14–20 วินาทีสำหรับชุดข้อมูลที่ทดสอบ ซึ่งมีตั้งแต่ 1M ถึง 10M เหตุการณ์
- ตรวจสอบผลลัพธ์ ตรวจดูว่าชื่อกิจกรรมและเส้นทางกระบวนการสมเหตุสมผลหรือไม่ และแก้ไขปัญหาคุณภาพข้อมูล
- เพิ่มข้อมูลเมื่อจำเป็น เพิ่มจำนวนเหตุการณ์เมื่อต้องตรวจสอบเคสที่พบไม่บ่อย หรือเปรียบเทียบช่วงเวลาที่ยาวขึ้น.
ตารางนี้เปรียบเทียบเวลารอช่วงแรกสำหรับจำนวนเหตุการณ์ต่างๆ เมื่อใช้การเชื่อมต่อ 100 Mbps.
| วิธีเริ่มต้น | อัปโหลด (100 Mbps) | ประมวลผลเบื้องต้น | เวลารอรวม | ความเร็วแดชบอร์ด |
|---|---|---|---|---|
| เริ่มด้วย 1M เหตุการณ์ | 22s | 55s | ~1.5 min | 1–2s |
| เริ่มด้วย 5M เหตุการณ์ | 2 min | 1.5 min | ~3.5 min | 1–2.5s |
| เริ่มด้วย 50M เหตุการณ์ | 18 min | 2 min | ~20 min | 1–6s |
จำนวนเหตุการณ์ที่เหมาะสมขึ้นอยู่กับคำถามของคุณ ชุดข้อมูลขนาดเล็กอาจเพียงพอสำหรับดูรูปแบบกระบวนการทั่วไป แต่คุณอาจต้องใช้ข้อมูลเพิ่มเพื่อศึกษาเหตุการณ์ที่พบไม่บ่อย หรือให้ครอบคลุมข้อมูลทั้งหมดตามข้อกำหนด.
แบ่งข้อมูลเมื่อคำถามเจาะจง
หากกำลังตรวจสอบประเทศ แผนก หรือสายผลิตภัณฑ์ใดโดยเฉพาะ ให้เริ่มจากข้อมูลส่วนนั้น แทนการรวมกลุ่มที่ไม่เกี่ยวข้องกัน การแบ่งข้อมูลช่วยให้เปรียบเทียบได้ชัดเจนขึ้นและลดปริมาณข้อมูลที่ต้องประมวลผล.
ตัวอย่างเช่น ผลทดสอบอ้างอิงชุดข้อมูลโลจิสติกส์ในยุโรป ซึ่งมีเหตุการณ์การจัดส่ง 42M รายการจาก 8 ประเทศ:
- ทุกประเทศ: 42M เหตุการณ์ ขนาด 9.3 GB ใช้เวลาอัปโหลด 16 นาทีบนเครือข่าย 100 Mbps และประมวลผลเบื้องต้น 2 นาที
- เยอรมนี: 8.5M เหตุการณ์ ขนาด 1.9 GB ใช้เวลาอัปโหลด 3 นาที และประมวลผลเบื้องต้น 1.5 นาที
- เนเธอร์แลนด์: 3.1M เหตุการณ์ ขนาด 690 MB ใช้เวลาอัปโหลด 1 นาที และประมวลผลเบื้องต้น 1 นาที.
คุณเปรียบเทียบข้อมูลแต่ละส่วนได้หลังจากตรวจสอบความถูกต้องแล้ว มิติที่นำมาแบ่งได้ เช่น ภูมิศาสตร์ องค์กร ผลิตภัณฑ์ ช่วงเวลา และกลุ่มลูกค้า.
กรองให้เหลือเฉพาะเคสที่ต้องใช้
หากกำลังตรวจสอบข้อยกเว้น การส่งออกเฉพาะเคสที่เกี่ยวข้องจะช่วยลดขนาดชุดข้อมูลได้มาก ตัวอย่างเช่น ผลทดสอบกล่าวถึงกระบวนการจัดซื้อจนถึงชำระเงินที่มีใบสั่งซื้อ 1.2 ล้านรายการและเหตุการณ์ 8.4M รายการ โดยระบุว่ามีใบสั่งซื้อ 96,000 รายการ หรือ 8% ที่พบข้อยกเว้น เช่น ถูกปฏิเสธ ส่งคืน ใบแจ้งหนี้ซ้ำ หรือไม่มีการอนุมัติ.
สำหรับการวิเคราะห์นี้ การส่งออกเฉพาะเคสที่มีข้อยกเว้นช่วยลดข้อมูลจาก 8.4M เหลือ 670K เหตุการณ์ ขนาดไฟล์ลดจาก 1.9 GB เหลือ 150 MB และเวลาอัปโหลดบนเครือข่าย 100 Mbps ลดจาก 3 นาทีเหลือ 15 วินาที ในผลทดสอบ การส่งออกข้อมูลเดียวกันเป็นไฟล์ Parquet ขนาด 15 MB ใช้เวลาอัปโหลดไม่ถึง 2 วินาที.
กรองตามสถานะ กิจกรรม ระยะเวลาของเคส ช่วงเวลา หรือหน่วยธุรกิจ เมื่อฟิลด์เหล่านั้นตรงกับคำถามที่คุณกำลังตรวจสอบ.
เลือกเฉพาะคอลัมน์ที่จำเป็น
ทุกคอลัมน์มีผลต่อขนาดไฟล์ ฟิลด์ข้อความยาว ตัวระบุที่ซ้ำซ้อน ฟิลด์ตรวจสอบย้อนหลัง และข้อมูลเมตาทางเทคนิคอาจไม่จำเป็นต่อการวิเคราะห์ของคุณ.
ผลทดสอบกล่าวถึงข้อมูลส่งออกจาก SAP ที่มีเหตุการณ์ใบสั่งซื้อ 1.8M รายการและ 45 คอลัมน์ เมื่อลดเหลือ 12 คอลัมน์ที่จำเป็น ขนาดไฟล์ลดจาก 2.1 GB เหลือ 380 MB หากส่งออกคอลัมน์เหล่านั้นเป็น Parquet ขนาดจะลดลงอีกเหลือ 58 MB เวลาอัปโหลดบนเครือข่าย 100 Mbps ลดจาก 3.5 นาทีเหลือ 6 วินาทีตามผลทดสอบ.
เก็บเฉพาะฟิลด์ที่จำเป็นต่อการวิเคราะห์ เช่น CaseId, Activity, Timestamp และข้อมูลทางธุรกิจที่เกี่ยวข้อง เช่น สถานะ จำนวนเงิน หมวดหมู่ หรือภูมิภาค หากไม่จำเป็นต่อการวิเคราะห์ ให้นำข้อมูลส่วนบุคคลออก
เมื่อใดควรใช้ชุดข้อมูลขนาดใหญ่ขึ้น?
หากคำถามของคุณต้องการข้อมูลที่ครอบคลุมช่วงเวลานานหรือเหตุการณ์ที่เกิดขึ้นไม่บ่อย ก็อาจต้องใช้ข้อมูลเหตุการณ์จำนวนมากขึ้น.
- เหตุการณ์ที่พบได้น้อย: การค้นหาข้อยกเว้นที่เกิดขึ้นเพียง 1 ครั้งใน 100,000 เคส ต้องมีข้อมูลจำนวนมากพอที่จะพบเหตุการณ์นั้น หากข้อยกเว้นเกิดขึ้น 0.01% และคุณต้องการศึกษา 50 ครั้ง คุณต้องมีข้อมูลประมาณ 500K เคส.
- รูปแบบที่เกิดไม่บ่อย: รูปแบบที่เกิดขึ้น 0.1% อาจมองไม่เห็นในตัวอย่างข้อมูล 1M เหตุการณ์ แต่เห็นและวัดได้ชัดเจนเมื่อมีข้อมูล 50M เหตุการณ์.
- การปฏิบัติตามข้อกำหนดและการตรวจสอบ: ข้อกำหนดบางอย่างต้องใช้ข้อมูลทั้งหมด ไม่ใช่การสุ่มตัวอย่าง.
- แนวโน้มระยะยาว: การเปรียบเทียบไตรมาส 1 ปี 2024 กับไตรมาส 1 ปี 2025 และไตรมาส 1 ปี 2026 ต้องใช้ข้อมูลจากทั้งสามช่วงเวลา การโหลดข้อมูลส่วนเพิ่มช่วยเพิ่มข้อมูลให้ครอบคลุมแต่ละช่วงได้ทีละส่วน.
สำหรับชุดข้อมูลที่มีมากกว่า 50M เหตุการณ์ ผลการทดสอบแนะนำให้ใช้ Parquet อัปโหลดผ่าน API และใช้เครือข่ายความเร็วสูงหากมี ไฟล์ CSV ที่ใช้ทดสอบกับข้อมูล 50M เหตุการณ์มีขนาด 11.1 GB ส่วนไฟล์ Parquet มีขนาด 1.7 GB.
ประสิทธิภาพต้องแลกกับต้นทุนเสมอ ยิ่งมีข้อมูลมากและต้องการความเร็วสูง ค่าใช้จ่ายก็ยิ่งเพิ่มขึ้น คำถามสำคัญจึงไม่ใช่เครื่องมือทำอะไรได้บ้าง แต่เป็นกระบวนการของคุณต้องการอะไร ProcessMind รองรับข้อมูลขนาดใหญ่ได้มาก แต่เรายังแนะนำให้หลีกเลี่ยงชุดข้อมูลที่ใหญ่มากเกินจำเป็น เพราะจะเพิ่มความซับซ้อนจนเบี่ยงเบนความสนใจจากการปรับปรุงกระบวนการ.
ทำอย่างไรให้โมเดลและหน้าจอทำงานได้อย่างลื่นไหล?
ปริมาณข้อมูลเป็นเพียงส่วนหนึ่ง การออกแบบโมเดลกระบวนการและแดชบอร์ดก็มีผลต่อความรวดเร็วในการทำงานเช่นกัน.
- จัดโมเดลให้อ่านง่าย: แบ่งกระบวนการขนาดใหญ่เป็น Subprocesses ที่แยกเป็นส่วนๆ แคนวาสที่มีองค์ประกอบแสดงอยู่จำนวนมากอาจใช้เวลาแสดงผลนานขึ้นและนำทางได้ยากขึ้น หลังปรับโครงสร้างแล้ว ให้ใช้ auto-layout.
- เลือกองค์ประกอบในแดชบอร์ดให้เหมาะสม: แผนภูมิและไทล์แต่ละรายการต้องมีการคำนวณ เลือกเก็บมุมมองที่ช่วยตอบคำถามที่คุณกำลังศึกษา.
- เลือกแผนภูมิให้เหมาะกับข้อมูล: เมื่อใช้ชุดข้อมูลขนาดใหญ่ การแสดงผลที่มีหลายหมวดหมู่อาจใช้เวลาคำนวณนานขึ้น หากไม่ต้องการดูรายละเอียดแยกย่อย ให้ใช้ข้อมูลสรุป.
- ใช้ตัวกรองเท่าที่จำเป็น: ตัวกรองช่วยจำกัดขอบเขตการวิเคราะห์ได้ แต่ควรหลีกเลี่ยงการรวมตัวกรองที่ไม่เกี่ยวกับคำถามที่ต้องการหาคำตอบ.
- ปรับการตั้งค่าแอนิเมชัน: ยิ่งมีเคสที่ทำงานอยู่มาก การแสดงแอนิเมชันก็ยิ่งใช้ทรัพยากรมากขึ้น ลดความเร็วหรือปิดหางและเอฟเฟกต์เมื่อคุณต้องการตรวจสอบเฉพาะลำดับการไหล ดูข้อมูลเพิ่มเติมที่ Process Animation.
- คำนวณใหม่เฉพาะส่วนที่เปลี่ยน: เมื่อโมเดลเปลี่ยน ระบบจะอัปเดตการคำนวณที่ขึ้นอยู่กับโมเดล โดยไม่ต้องประมวลผลข้อมูลเบื้องต้นทั้งหมดซ้ำ ในการทดสอบ การเปลี่ยนแปลงใช้เวลาประมาณ 14 วินาทีสำหรับข้อมูล 1M เหตุการณ์ และ 52 วินาทีสำหรับข้อมูล 100M เหตุการณ์.
การโหลดข้อมูลส่วนเพิ่มช่วยลดเวลาอัปโหลดได้อย่างไร?
การโหลดข้อมูลส่วนเพิ่มช่วยให้คุณเพิ่มเหตุการณ์ใหม่ลงในชุดข้อมูลเดิมได้ โดยไม่ต้องอัปโหลดข้อมูลทั้งหมดอีกครั้ง จึงลดปริมาณข้อมูลที่ต้องส่งเมื่ออัปเดตบันทึกเหตุการณ์ที่มีข้อมูลเพิ่มขึ้นเรื่อยๆ.
| สถานการณ์ | อัปโหลดใหม่ทั้งหมด | อัปโหลดข้อมูลส่วนเพิ่ม | เวลาที่ประหยัดได้ |
|---|---|---|---|
| ข้อมูลเดิม 10M + event ใหม่ 500K (100 Mbps) | อัปโหลด 4 นาที | อัปโหลด 5 วินาที | ประมาณ 4 นาที |
| ข้อมูลเดิม 20M + event ใหม่ 2M (100 Mbps) | อัปโหลด 7 นาที | อัปโหลด 44 วินาที | ประมาณ 6 นาที |
| ข้อมูลเดิม 50M + event ใหม่ 5M (100 Mbps) | อัปโหลด 18 นาที | อัปโหลด 2 นาที | ประมาณ 16 นาที |
หลังอัปโหลดข้อมูลส่วนเพิ่ม ระบบจะประมวลผลข้อมูลเบื้องต้นอีกครั้งกับชุดข้อมูลที่รวมกันแล้ว ในการทดสอบใช้เวลา 1–2.5 นาที เวลาที่ประหยัดได้จากการอัปโหลดมาจากการส่งเฉพาะเหตุการณ์ใหม่.
ไฟล์ข้อมูลส่วนเพิ่มต้องใช้รูปแบบไฟล์และโครงสร้างคอลัมน์เดียวกับไฟล์ที่อัปโหลดครั้งแรก ดูรายละเอียดได้ที่ คู่มือการโหลดข้อมูลส่วนเพิ่ม.
ควรอัปโหลดผ่าน API เมื่อใด?
หากต้องอัปโหลดเป็นประจำหรือมีไฟล์ขนาดหลายกิกะไบต์ การอัปโหลดผ่าน API อาจจัดการได้ง่ายกว่าการส่งไฟล์ผ่านเบราว์เซอร์ คุณสามารถใช้สคริปต์หรือเครื่องมือบรรทัดคำสั่งร่วมกับ ETL pipeline ตั้งเวลาอัปโหลด และติดตามความคืบหน้าการส่งข้อมูลได้.
ProcessMind มี URL ที่ลงนามล่วงหน้าสำหรับอัปโหลดไฟล์ไปยังพื้นที่จัดเก็บบนคลาวด์โดยตรง คุณคัดลอก URL สำหรับอัปโหลดได้จาก เมนูการตั้งค่าชุดข้อมูลใน UI ของ ProcessMind.
# Upload a Parquet file directly using a presigned URL
curl -X PUT "$PRESIGNED_URL" --upload-file data.parquet
ดูตัวอย่างการใช้งาน Bash, JavaScript และ Python ได้ใน เอกสาร API รวมถึงวิธีรับ URL ที่ลงนามล่วงหน้าและอัปโหลดไฟล์ข้อมูลส่วนเพิ่ม.
ควรแยกชุดข้อมูลเมื่อใด?
แบ่งชุดข้อมูลเมื่อการวิเคราะห์ต้องใช้ข้อมูลเพียงบางส่วน หรือเมื่อต้องการเปรียบเทียบกลุ่มต่างๆ แยกจากกัน คุณแบ่งตามภูมิภาค แผนก สายผลิตภัณฑ์ ช่วงเวลา หรือประเภทเคส แล้ววิเคราะห์แต่ละชุดแยกกันได้.
เก็บข้อมูลไว้ด้วยกันเมื่อคำถามของคุณต้องเปรียบเทียบกลุ่มต่างๆ หรือติดตามกระบวนการทั้งหมดที่เชื่อมโยงกัน ก่อนแบ่งข้อมูล ให้ตรวจสอบว่าการแบ่งนั้นเปลี่ยนความหมายของเคสหรือตัดเหตุการณ์ที่จำเป็นต่อการทำความเข้าใจเส้นทางของเคสหรือไม่ ตัวอย่างเช่น การแบ่งตามเวลาอาจต้องคำนึงถึงเคสที่เริ่มในช่วงหนึ่งและสิ้นสุดในอีกช่วงหนึ่ง.
ทดสอบประสิทธิภาพด้วยข้อมูลของคุณเอง
ผลการทดสอบช่วยให้คุณวางแผนได้ แต่ไม่สามารถคาดการณ์ผลลัพธ์ของบันทึกเหตุการณ์ เครือข่าย หรือคำค้นทุกแบบได้ ให้ทดสอบกับชุดข้อมูลที่คุณคาดว่าจะใช้ แล้วตรวจสอบเวลาอัปโหลด เวลาประมวลผลข้อมูลเบื้องต้น และเวลาตอบสนองของมุมมองในแดชบอร์ดที่สำคัญสำหรับคุณ.
อ่านคำแนะนำการเตรียมข้อมูลก่อน หากต้องการความช่วยเหลือในการจัดรูปแบบบันทึกเหตุการณ์ คุณยังดูข้อมูลเพิ่มเติมได้ที่ วิธีวิเคราะห์กระบวนการ และ วิธีติดตามกระบวนการอย่างต่อเนื่อง.
ทดสอบกับปริมาณข้อมูลจริงของคุณ
โหลดบันทึกเหตุการณ์ที่คุณต้องการวิเคราะห์ แล้ววัดประสิทธิภาพด้วยข้อมูลของคุณ.