Alat ETL untuk process mining: kebutuhan Anda
Kapan process mining memerlukan ETL, data apa yang harus ada dalam hasil ekstraksi, dan alasan ProcessMind dapat memuat hasil dari alur data yang sudah Anda gunakan.

Apakah process mining membutuhkan ETL?
Alat ETL mengekstrak data dari sistem sumber, mengubahnya ke format yang bisa digunakan, lalu memuatnya untuk dianalisis. Artikel ini membahas kebutuhan ETL dalam proyek process mining dan kapan Anda bisa menghindarinya. Ini bukan panduan memilih pipeline. Jika satu sistem dapat mengekspor catatan dan file tersebut memiliki ID kasus, aktivitas, serta stempel waktu, Anda sering kali bisa melewati pipeline untuk analisis awal dan langsung memuat hasil ekspornya.
Jawabannya bergantung pada proses, sistem yang digunakan, dan seberapa sering analisis perlu diperbarui. Mulailah dengan ekstrak terkecil yang bisa menjawab pertanyaan Anda. Tambahkan persiapan dan otomatisasi jika analisis awal menunjukkan bahwa keduanya diperlukan.
Ada tiga kondisi yang membuat pekerjaan ETL diperlukan:
- Proses mencakup beberapa sistem. Catatan perlu digabungkan dan ID-nya diselaraskan agar satu kasus dapat ditelusuri dari awal hingga akhir.
- Data sumber belum bisa langsung dibaca. Nama aktivitas, stempel waktu, atau ID kasus perlu distandardisasi sebelum dapat digunakan dalam analisis.
- Ekstrak perlu dibuat berulang. Jika data berubah setiap hari dan analisis harus mengikuti perubahan itu, ekspor manual tidak lagi praktis.
Kondisi tersebut menjadi alasan untuk menyiapkan data, bukan untuk membangun pipeline sebelum menjawab pertanyaan pertama. Muat data yang tersedia, lihat apa yang kurang, lalu tentukan langkah berikutnya.
Awalnya kami mengira ETL harus menjadi bagian dari produk. Lalu kami melihat apa yang sudah dimiliki pelanggan. Gelombang data warehouse berlangsung sekitar dua puluh tahun dengan berbagai nama, termasuk data mart dan data lake. Kini, sebagian besar perusahaan sudah memiliki data yang siap digunakan. Karena itu, kami berhenti membangun pipeline sendiri. Bawa hasil ekspor dari sistem yang Anda gunakan, atau arahkan pipeline yang sudah dikelola tim Anda ke API kami. Anda bisa langsung mulai dari data yang sudah tersedia.
Anda juga bisa melewati pipeline terpisah jika:
- Proses terutama tercatat di satu sistem.
- Catatan yang diperlukan bisa diekspor.
- File ekspor memiliki ID kasus, aktivitas, dan stempel waktu.
- File cukup kecil untuk disiapkan secara manual.
- Anda masih menguji apakah data dapat menjawab pertanyaan.
Spreadsheet cukup untuk mengganti nama kolom, memperbaiki ketidakkonsistenan yang jelas, dan menghapus kolom yang tidak diperlukan. Persiapan manual tidak harus berlangsung selamanya. Setelah analisis terbukti berguna dan data perlu diperbarui secara rutin, otomatisasi langkah-langkah yang terus Anda ulangi.
Kolom yang harus ada dalam ekstrak
Log peristiwa untuk process mining membutuhkan tiga kolom dan satu baris untuk setiap peristiwa.
| Kolom | Artinya | Hal yang perlu diperiksa |
|---|---|---|
| ID kasus | Instans proses, seperti pesanan atau permintaan layanan | ID kasus yang sama harus menghubungkan semua peristiwa dalam instans tersebut |
| Aktivitas | Satu langkah yang terjadi dalam proses | Nama harus membedakan langkah yang benar-benar berbeda dan digunakan secara konsisten |
| Stempel waktu | Waktu terjadinya langkah | Tanggal dan waktu harus valid, dengan zona waktu yang sama di semua sumber yang digabungkan |
Atribut seperti biaya, pengguna, tim, segmen pelanggan, atau jejak CO2 bersifat opsional. Namun, atribut inilah yang mengubah tampilan proses menjadi bahan analisis. Setiap atribut yang Anda simpan nantinya bisa digunakan sebagai filter, pemisah, atau ukuran. Lihat referensi atribut dataset untuk mengetahui fungsi setiap kolom.
Kolom bisa saja ada di sumber data, tetapi tetap tidak bisa digunakan. ID kasus yang berubah antar sistem tidak akan menghubungkan peristiwa. Label aktivitas yang tidak konsisten bisa membuat satu langkah nyata terlihat seperti tiga langkah berbeda. Stempel waktu yang disimpan sebagai teks dapat mengurutkan peristiwa secara keliru. Periksa hasil ekspor sebelum memetakannya, terutama tiga kolom wajib. Untuk melihat persyaratan log secara lebih luas, baca kebutuhan data untuk process mining.
Contoh kueri log peristiwa paling sederhana
Jika sumber data sudah menyimpan satu baris untuk setiap aktivitas, kuerinya cukup memilih kolom yang diperlukan. Contoh ini menggunakan tabel bernama process_events yang berisi kasus, aktivitas, dan waktu peristiwa:
SELECT
  case_id        AS case_id,
  activity_name  AS activity,
  event_time     AS timestamp
FROM process_events
WHERE case_id IS NOT NULL
  AND activity_name IS NOT NULL
  AND event_time IS NOT NULL
ORDER BY case_id, event_time;
Kueri ini memberi nama pada tiga kolom, membuang baris yang tidak bisa digunakan, lalu mengurutkan peristiwa dalam setiap kasus. Sesuaikan nama tabel dan kolom dengan sumber data Anda. Sebelum memuatnya, periksa beberapa kasus. Pastikan setiap kasus memuat peristiwa yang diharapkan, dalam urutan yang dikenali oleh orang yang menjalankan pekerjaan tersebut.
Langkah transformasi yang perlu dilakukan
Transformasi sebaiknya memperbaiki hal-hal yang dapat mengacaukan analisis. Empat langkah berikut biasanya sudah mencukupi.
-
Normalisasi peristiwa
Tempatkan setiap kemunculan aktivitas pada baris tersendiri, bersama ID kasus dan stempel waktu. Lakukan ini meskipun sumber data menyimpan langkah proses di kolom terpisah. -
Pastikan stempel waktu bisa digunakan
Pastikan nilainya berupa tanggal dan waktu yang valid, lalu periksa apakah menggunakan waktu lokal atau UTC. Selaraskan zona waktu sumber yang digabungkan, agar urutan peristiwa tidak keliru. -
Standardisasi nama aktivitas
Gunakan satu label untuk setiap langkah nyata, dalam satu bahasa dan dengan ejaan yang konsisten. Jangan gabungkan langkah yang hanya tampak mirip demi mempersingkat daftar. -
Gabungkan sumber hanya jika diperlukan
Temukan kunci penghubung catatan, lalu uji kecocokannya. Penggabungan yang menggandakan peristiwa atau menghilangkan kasus akan mengubah tampilan proses. Karena itu, bandingkan jumlah catatan sebelum dan sesudah penggabungan.
Jika hasil ekspor sudah memiliki satu baris per peristiwa dan tiga kolom yang diperlukan, Anda tidak perlu melakukan transformasi. Itu hal yang wajar, bukan jalan pintas. Cara membuat log peristiwa untuk process mining membahas langkah yang sama dengan contoh Excel dan SQL.
Di mana log peristiwa harus dimuat?
Muat data yang sudah disiapkan ke platform tempat Anda akan menganalisisnya. Untuk pemeriksaan awal, satu file saja cukup: siapkan, muat, lihat tampilan proses, lalu sempurnakan ekstrak setelah Anda mengetahui data apa yang tersedia. Jangan menyiapkan lapisan penyimpanan baru hanya untuk process mining. Jika tim Anda sudah mengelola warehouse atau lake, simpan data di sana dan muat hasil yang dihasilkan lingkungan tersebut.
Halaman format data yang didukung menjelaskan detailnya. Jika tidak ingin mengunggah file secara manual, Anda juga dapat mengirim file dalam format yang sama melalui data API menggunakan tugas terjadwal.
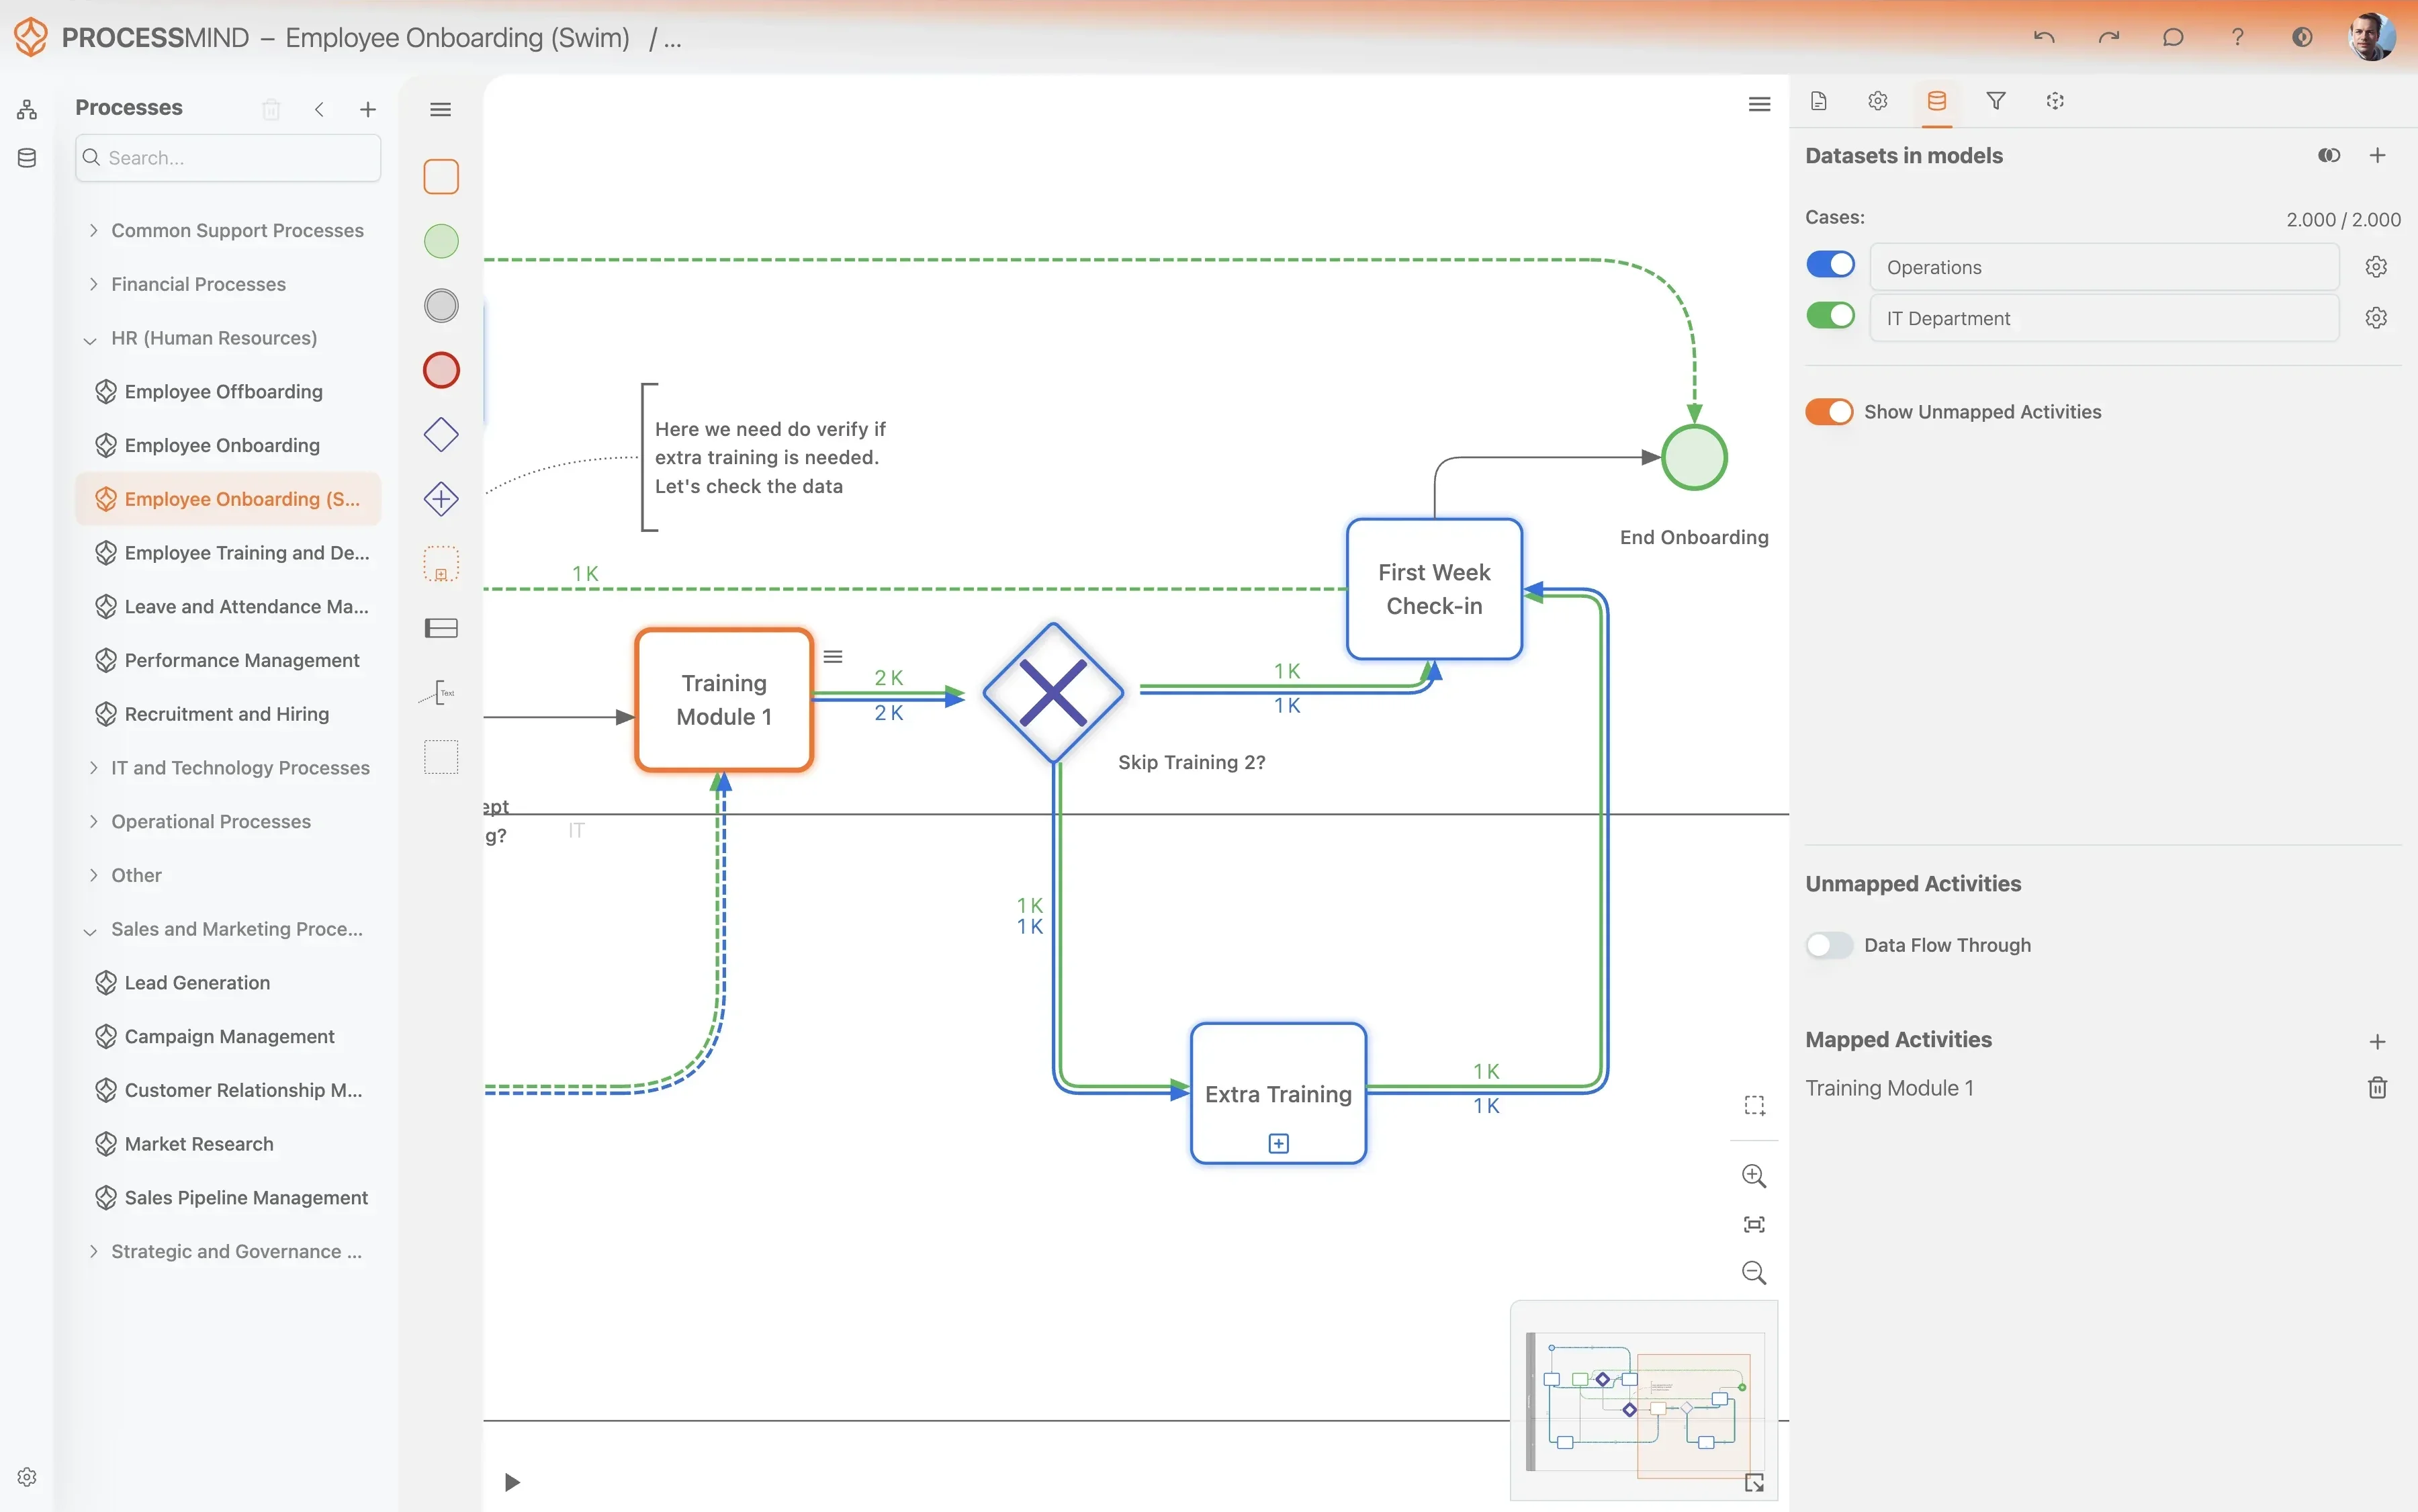
Apa pun cara yang Anda pilih, muat data ke tempat analisis dilakukan. File di folder yang tidak dipantau bukanlah strategi data. Dataset yang dipetakan dan ditinjau oleh seseorang, itulah yang berguna.
Alat ETL apa yang cocok untuk process mining?
Tidak ada satu daftar alat ETL yang cocok untuk semua proyek. Pilih berdasarkan lokasi data, alat yang sudah digunakan tim, dan tingkat persiapan yang dibutuhkan log. Pekerjaannya sendiri termasuk rekayasa data biasa. Satu-satunya kebutuhan khusus process mining adalah hasil akhirnya tetap memiliki ID kasus, aktivitas, dan stempel waktu.
| Pendekatan | Gunakan jika | Pertimbangannya |
|---|---|---|
| Ekspor dan siapkan secara manual | Anda menguji satu proses dengan dataset kecil yang stabil | Cara tercepat untuk mulai, tetapi setiap pembaruan harus dilakukan manual |
| Alat yang sudah digunakan tim | SQL, dbt, warehouse, atau lake sudah tersedia | Memanfaatkan keterampilan dan infrastruktur yang ada, serta membuat logika bisa digunakan kembali di luar process mining |
| Alat ETL pihak ketiga | Ekstraksi perlu dilakukan berulang dari beberapa sistem | Lebih banyak komponen yang harus disiapkan dan dikelola |
| ETL bawaan di platform mining | Platform mendukung transformasi yang Anda perlukan | Praktis, tetapi periksa apakah logikanya bisa dipindahkan dan datanya dapat digunakan kembali di tempat lain |
Nama yang sering muncul dalam proyek process mining antara lain CData dan dbt untuk ekstraksi data dan transformasi SQL, BigQuery, Snowflake, dan Databricks untuk warehouse, serta Talend, Apache NiFi, dan Airbyte untuk memindahkan data antar sistem. Perangkat lunak sumber terbuka juga layak dipertimbangkan. NiFi dan Airbyte sering menjadi pilihan awal. Beberapa vendor, termasuk Evidant dan Konekti, menawarkan ETL yang dirancang untuk process mining dengan templat bagi sistem yang umum digunakan.
Nama-nama tersebut hanya contoh, bukan rekomendasi atau mitra kami. Pilih alat dan format yang dapat terus dikelola tim setelah proyek selesai. Jika memungkinkan, simpan logika transformasi di luar produk mining agar bisa digunakan kembali. Pertimbangkan ETL bawaan dengan cermat. Memang praktis jika Anda terus menggunakan platform yang sama, tetapi persiapan data Anda akan tersimpan di tempat yang lebih sulit digunakan kembali untuk proyek analitik atau AI berikutnya.
Bagaimana mengelola data setelah dimuat?
Ekstraksi baru separuh pekerjaan. Cara Anda mengelola dataset setelahnya menentukan apakah analisisnya masih bisa diandalkan tiga bulan kemudian.
- Beri nama dataset sesuai isinya.
Q1_2025_Sales_DataatauCustomer_Support_Logslebih jelas daripadaexport_final_v3. - Pilih format sesuai kebutuhan. CSV atau Excel cocok untuk file kecil yang diunggah manual. Parquet atau ORC lebih sesuai untuk dataset besar dan data yang dihasilkan pipeline.
- Lihat pratinjau sebelum memetakan. Periksa struktur, jenis kolom, dan beberapa baris. Pastikan ID kasus, aktivitas, dan stempel waktu sudah benar di konfigurasi dataset Anda.
- Periksa pemetaan aktivitas. Gunakan pemetaan otomatis untuk pemeriksaan awal, lalu tinjau aktivitas yang belum dipetakan. Langkah yang terjadi tetapi tidak tercatat dalam data dapat ditandai sebagai aliran data. Langkah tersebut tetap terlihat tanpa mengubah angka.
- Perbarui, jangan buat ulang. Untuk ekspor rutin, ganti dataset dengan file terbaru sesuai kebutuhan analisis, baik harian maupun mingguan, dan pertahankan pemetaan yang sama.
- Catat hal-hal yang tidak tercakup dalam data. Periode, sistem, dan langkah yang hilang perlu dicatat dalam analisis karena menentukan kesimpulan yang bisa Anda ambil.
- Atur akses, lalu arsipkan. Berikan akses dataset kepada orang yang membutuhkannya, lalu arsipkan dataset yang tidak lagi digunakan setelah proyek selesai.
Intinya
ETL adalah sarana, bukan tujuan proyek process mining. Siapkan ETL agar tidak memperlambat analisis pertama:
- Mulailah dengan data yang bisa Anda dapatkan minggu ini.
- Pertahankan tiga kolom wajib, apa pun kolom lain yang Anda hapus.
- Muat hasil ekspor terlebih dahulu. Otomatiskan pemuatan setelah analisis menunjukkan bahwa langkah itu perlu.
- Gunakan alat dan format yang sudah dikelola tim Anda.
Lebih banyak proyek gagal karena pipeline dibuat sebelum siapa pun tahu pertanyaan yang harus dijawab, bukan karena pipelinenya terlalu sederhana.
Where to Go From Here
Anda sudah memiliki hasil ekspor atau pipeline yang bisa membuatnya. Langkah berikutnya, muat data dan periksa apakah ekstraknya menjawab pertanyaan Anda.