Miglioramento dei processi lean: una guida basata sui dati
Scopra il processo DMAIC, il processo Six Sigma e gli strumenti per il miglioramento dei processi lean, così da ottenere risultati aziendali misurabili.

Le prestazioni del Process Mining dipendono da tre fattori: dalla quantità di dati caricati, dal modo in cui vengono strutturati e dal modo in cui il sistema li elabora. Questa guida li esamina tutti, con benchmark reali e metodi concreti per migliorare i risultati.
Pubblichiamo tutti i nostri numeri. Li confronti con quelli di qualsiasi strumento di Process Mining sul mercato.
Punti chiave
Quando carica i dati in ProcessMind, accadono tre cose. Ecco esattamente dove viene impiegato il tempo:
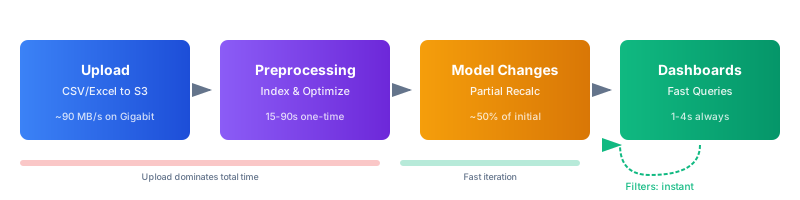
Upload (incide sulla maggior parte del tempo totale). Il Suo file viaggia attraverso Internet fino alla nostra infrastruttura cloud. Per i file di grandi dimensioni, questo è il principale collo di bottiglia. La velocità fisica della rete fa la differenza: un CSV da 50 milioni di eventi (11 GB) richiede 2 minuti su una connessione gigabit, 18 minuti a 100 Mbps o più di 3 ore a 10 Mbps. Gli stessi dati in Parquet occupano appena 1,7 GB, riducendo i tempi rispettivamente a 19 secondi, 3 minuti e 28 minuti. Questo è il motivo principale per cui conviene utilizzare formati colonnari come Parquet o ORC, oppure dataset più piccoli.
Preprocessing (costo una tantum, da circa 30 secondi a 2,5 minuti). Una volta completato l’upload, trasformiamo i Suoi dati in uno storage colonnare ottimizzato: indicizziamo gli eventi, precalcoliamo le transizioni delle attività, identifichiamo le varianti di processo e calcoliamo le statistiche riepilogative. Questa operazione richiede 30 secondi per i dataset più piccoli e fino a 2,5 minuti per 100 milioni di eventi. Sostiene questo costo una sola volta per ogni upload e ne beneficia per tutte le elaborazioni successive.
Modifiche al modello (ricalcolo parziale, 6–52 secondi). Quando modifica il modello di processo aggiungendo o rimuovendo attività oppure cambiando le mappature, vengono aggiornati solo i calcoli dipendenti dal modello. L’operazione richiede 6 secondi per i dataset più piccoli e fino a 52 secondi per 100 milioni di eventi, molto meno del preprocessing completo. Le modifiche ai filtri sono immediate.
Prestazioni dei Dashboard: sempre veloci
I Dashboard sono veloci. Una volta completato il preprocessing, le interazioni con i Dashboard rispondono in meno di 2,5 secondi per dataset fino a 10 milioni di eventi. Anche con 50 milioni di eventi, la maggior parte delle query restituisce risultati in 2–5 secondi. Solo i process flow su dataset da oltre 100 milioni di eventi si avvicinano ai 7 secondi. Di seguito sono riportati i tempi di risposta dettagliati.
Abbiamo investito molto nel preprocessing affinché l’analisi, che occupa gran parte del Suo tempo, risulti immediata.
Una volta caricati i Suoi dati, diversi fattori determinano la velocità delle query. Comprenderli La aiuta a progettare export migliori e a definire aspettative realistiche.
Il numero di attività è importante. I modelli di processo con 10–20 attività distinte sono ottimali. Oltre 50 attività, il process flow richiede più tempo per essere calcolato e diventa più difficile da comprendere. Un numero eccessivo di nodi e archi crea rumore visivo. Se il Suo export contiene molte attività, valuti di raggruppare i passaggi correlati.
La varietà delle varianti influisce sui calcoli. Un processo in cui l’80% dei casi segue 5 varianti è più rapido da analizzare rispetto a uno in cui ogni caso segue un percorso diverso. Un’elevata variabilità non è necessariamente negativa e spesso segnala problemi reali, ma comporta tempi di risposta delle query leggermente più lunghi.
Più colonne significano più dati da analizzare. Ogni attributo incluso viene indicizzato e interrogato. Le colonne fondamentali, CaseId, Activity e Timestamp, sono sempre necessarie. Le colonne aggiuntive aiutano a filtrare e categorizzare i dati, ma ciascuna introduce un ulteriore carico di elaborazione.
I casi lunghi richiedono più tempo. Un caso con 50 eventi richiede più calcoli rispetto a uno con 5. Se il Suo processo comprende casi che si estendono per centinaia di eventi, le query saranno proporzionalmente più lente. È una caratteristica intrinseca del Process Mining, non una peculiarità di uno strumento specifico.
Comprendere cosa aspettarsi La aiuta a pianificare. Questi benchmark vengono eseguiti su un’infrastruttura AWS di produzione, con la latenza di rete reale, e rappresentano la media di più esecuzioni di test. Abbiamo testato oltre 50 tipi di query per ogni dimensione di dataset.
La tabella seguente mostra aspettative realistiche per ogni dimensione di dataset. Per i file più grandi, soprattutto con connessioni lente, il tempo di upload incide maggiormente. È il singolo fattore che influisce di più sul tempo totale di attesa.
| Dataset | Eventi effettivi | Dimensione file | Upload (1 Gbps) | Upload (100 Mbps) | Upload (50 Mbps) | Upload (10 Mbps) | Preprocessing |
|---|---|---|---|---|---|---|---|
| 100K | 125.260 | 22 MB | < 1 s | 2 s | 4 s | 22 s | 35 s |
| 500K | 626.300 | 110 MB | 1 s | 11 s | 22 s | 2 min | 45 s |
| 1M | 1.253.424 | 221 MB | 3 s | 22 s | 44 s | 4 min | 55 s |
| 2M | 2.506.848 | 443 MB | 5 s | 44 s | 1,5 min | 7 min | 1 min |
| 5M | 4.996.877 | 1,1 GB | 13 s | 2 min | 4 min | 18 min | 1,5 min |
| 10M | 12.511.867 | 2,2 GB | 25 s | 4 min | 7 min | 37 min | 1,5 min |
| 20M | 25.023.734 | 4,4 GB | 50 s | 7 min | 15 min | 1,2 h | 2 min |
| 50M | 62.559.335 | 11,1 GB | 2 min | 18 min | 37 min | 3 h | 2 min |
| 100M | 125.118.670 | 22,3 GB | 4 min | 37 min | 1,2 h | 6 h | 2,5 min |
Le dimensioni dei file si riferiscono a CSV non compressi con uno schema tipico di Event Log (CaseId, Activity, Timestamp e 5–8 attributi aziendali). I Suoi file possono essere più grandi o più piccoli in base al numero e al contenuto delle colonne.
I tempi di upload a 1 Gbps sono misurati con una velocità effettiva di 88 MB/s verso AWS eu-central-1. Le altre velocità sono state estrapolate sulla base di velocità pratiche: 50 Mbps → circa 5 MB/s, 100 Mbps → circa 10 MB/s, 10 Mbps → circa 1 MB/s. La velocità effettiva dipende dalla Sua rete, dalla distanza dal data center e dal carico del momento.
Il punto chiave: il tempo di preprocessing si stabilizza tra 1 e 2,5 minuti indipendentemente dalla scala. Il tempo di upload cresce linearmente con la dimensione del file. Ridurre la dimensione del file è l’ottimizzazione con il maggiore impatto.
Il formato del file che carica influisce in modo significativo sulla velocità di upload e sul tempo di preprocessing. ProcessMind supporta CSV, Parquet, ORC, Excel e XES. Per i dataset di grandi dimensioni, Parquet e ORC superano nettamente CSV sia in termini di dimensione del file sia di velocità di elaborazione.
| Dataset | CSV | Parquet | ORC | CSV.GZ |
|---|---|---|---|---|
| 1M eventi | 221 MB | 34 MB | 39 MB | 20 MB |
| 5M eventi | 1,1 GB | 151 MB | 197 MB | 107 MB |
| 10M eventi | 2,2 GB | 301 MB | 395 MB | 215 MB |
| 20M eventi | 4,4 GB | 603 MB | 791 MB | 430 MB |
| 50M eventi | 11,1 GB | 1,7 GB | 1,9 GB | 1,1 GB |
| 100M eventi | 22,3 GB | 3,4 GB | 3,7 GB | 2,2 GB |
I file Parquet sono più piccoli dell’85% rispetto ai CSV. I file ORC sono più piccoli dell’82%. Entrambi sono formati colonnari con compressione integrata, quindi non è necessario alcun passaggio aggiuntivo. Il Suo strumento ETL o la Sua piattaforma dati, come Spark, Databricks, dbt o BigQuery, probabilmente supporta già l’export in Parquet o ORC.
La dimensione del file racconta solo metà della storia. Dopo l’upload, i Suoi dati passano attraverso l’acquisizione e i calcoli analitici specifici del formato, inclusi l’indicizzazione degli eventi e il calcolo delle transizioni e delle varianti. La fase analitica è quella predominante ed è uguale per tutti i formati. CSV.GZ è l’unico formato che aggiunge un tempo significativo, perché i file gzip non possono essere suddivisi per la decompressione parallela.
| Dataset | Parquet | ORC | CSV | CSV.GZ |
|---|---|---|---|---|
| 1M eventi | 55 s | 55 s | 55 s | 55 s |
| 5M eventi | 1,5 min | 1,5 min | 1,5 min | 1,5 min |
| 10M eventi | 1,5 min | 1,5 min | 1,5 min | 2 min |
| 20M eventi | 2 min | 2 min | 2 min | 2,5 min |
| 50M eventi | 2 min | 2 min | 2 min | 3 min |
| 100M eventi | 2,5 min | 2,5 min | 2,5 min | 4,5 min |
Il tempo di preprocessing è quasi identico per Parquet, ORC e CSV perché, indipendentemente dal formato di input, a incidere maggiormente sono i calcoli analitici. Tuttavia, il preprocessing di CSV.GZ peggiora significativamente con l’aumentare della scala, passando da circa un minuto con 1 milione di eventi a oltre 4 minuti con 100 milioni. I file compressi con gzip non possono essere suddivisi ed elaborati in parallelo, quindi la decompressione aggiunge una fase sempre più lunga prima dell’avvio delle analisi.
Considerando sia il tempo di upload sia il preprocessing, la scelta del formato diventa chiara:
| 10M eventi (100 Mbps) | Dimensione file | Upload | Preprocessing | Totale |
|---|---|---|---|---|
| Parquet | 301 MB | 30 s | 1,5 min | circa 2 min |
| ORC | 395 MB | 40 s | 1,5 min | circa 2,2 min |
| CSV | 2,2 GB | 4 min | 1,5 min | circa 5,5 min |
| CSV.GZ | 215 MB | 21 s | 2 min | circa 2,5 min |
| 50M eventi (100 Mbps) | Dimensione file | Upload | Preprocessing | Totale |
|---|---|---|---|---|
| Parquet | 1,7 GB | 3 min | 2 min | circa 5 min |
| ORC | 1,9 GB | 3,2 min | 2 min | circa 5,2 min |
| CSV | 11,1 GB | 18 min | 2 min | circa 20 min |
| CSV.GZ | 1,1 GB | 2 min | 3 min | circa 5 min |
Su larga scala, Parquet e ORC sono i chiari vincitori perché le dimensioni dei file sono nettamente inferiori. Il tempo di upload è il principale collo di bottiglia. Il preprocessing richiede all’incirca lo stesso tempo per tutti i formati, ad eccezione di CSV.GZ, che comporta un costo di decompressione crescente.
Quale formato dovrebbe utilizzare?
E gzip?
I file CSV.GZ sono più piccoli del 90% rispetto ai CSV non compressi, un vantaggio sulle connessioni lente. Tuttavia, a differenza di Parquet e ORC, che integrano la compressione e possono essere interrogati direttamente, i file gzip devono essere decompressi completamente prima dell’elaborazione e gzip non supporta la decompressione parallela. Con oltre 50 milioni di eventi, il preprocessing di CSV.GZ richiede 3–4,5 minuti, contro circa 2 minuti per gli altri formati. Con una connessione veloce, caricare un file Parquet leggermente più grande è quasi sempre la scelta migliore.
Se utilizza una connessione molto lenta, 10 Mbps, e dispone di un CSV di grandi dimensioni, gzip può comunque essere una scelta sensata: gzip -k data.csv su Mac/Linux oppure 7-Zip su Windows.
Dopo aver caricato un dataset di base, non è necessario ripetere l’upload completo ogni volta che arrivano nuovi dati. ProcessMind supporta il delta loading, ovvero gli upload incrementali, che consentono di aggiungere nuovi eventi a un dataset esistente.
Come funziona:
L’impatto sulle prestazioni è significativo. Invece di ripetere ogni volta l’upload del dataset in crescita, carica solo ciò che è nuovo:
| Scenario | Nuovo upload completo | Upload delta | Tempo risparmiato |
|---|---|---|---|
| 10M di base + 500K nuovi eventi (100 Mbps) | 4 min di upload | 5 s di upload | circa 4 min |
| 20M di base + 2M nuovi eventi (100 Mbps) | 7 min di upload | 44 s di upload | circa 6 min |
| 50M di base + 5M nuovi eventi (100 Mbps) | 18 min di upload | 2 min di upload | circa 16 min |
Dopo un upload delta, il preprocessing viene eseguito nuovamente sul dataset combinato, con lo stesso costo di 1–2,5 minuti. Tuttavia, risparmia tutto il tempo di upload relativo ai dati già caricati.
Il delta loading è ideale per:
I file delta devono utilizzare lo stesso formato e la stessa struttura di colonne dell’upload originale. Per maggiori dettagli, consulti la guida al caricamento incrementale dei dati.
Per dataset superiori a pochi gigabyte o per upload ricorrenti, gli script e gli strumenti da riga di comando sono più affidabili degli upload dal browser. I browser possono interrompere la sessione per timeout, consumare una quantità eccessiva di memoria o perdere i progressi quando la rete viene interrotta.
Perché l’API è più efficace con i file di grandi dimensioni:
curl mostrano l’avanzamento del trasferimento in tempo reale.Esempio con curl:
# Upload a Parquet file directly using a presigned URL
curl -X PUT "$PRESIGNED_URL" --upload-file data.parquet
ProcessMind fornisce URL presigned che autorizzano gli upload diretti nello storage cloud. Non sono necessarie credenziali oltre alla Sua chiave API. Può inoltre copiare direttamente l’URL di upload presigned dal menu delle impostazioni del dataset nell’interfaccia utente di ProcessMind.
Consulti la documentazione dell’API per esempi completi in Bash, JavaScript e Python, inclusi quelli relativi all’ottenimento di URL presigned, al caricamento di file delta e alla gestione programmatica di dataset di grandi dimensioni.
Quando perfeziona il modello di processo rinominando le attività, modificando le mappature o aggiungendo raggruppamenti, devono essere aggiornati solo i calcoli dipendenti dal modello. I dati di base rimangono invariati:
| Dataset | Preprocessing completo | Modifica del modello | Tempo risparmiato |
|---|---|---|---|
| 1M eventi | 55 s | circa 14 s | 75% |
| 2M eventi | 1 min | circa 16 s | 73% |
| 10M eventi | 1,5 min | circa 20 s | 78% |
| 20M eventi | 2 min | circa 23 s | 81% |
| 50M eventi | 2 min | circa 37 s | 69% |
| 100M eventi | 2,5 min | circa 52 s | 65% |
Le modifiche al modello sono rapide perché il caricamento iniziale dei dati, che cresce con la dimensione del dataset, è già completato. Viene eseguita nuovamente solo l’aggregazione dipendente dal modello, incluse le mappature delle attività, le transizioni e le varianti. Per dataset fino a 20 milioni di eventi, le modifiche al modello vengono completate in meno di 25 secondi. Anche con 100 milioni di eventi richiedono meno di un minuto, molto meno del preprocessing completo.
Una volta caricati i Suoi dati, questi sono i tempi di risposta che sperimenta durante l’analisi. I tempi riportati di seguito sono mediane calcolate su più esecuzioni di benchmark. Ogni componente del Dashboard esegue le proprie query in modo indipendente e viene caricato in parallelo:
| Dataset | Statistiche | Process Flow | Varianti | Categorie | Data Browser | Animazione |
|---|---|---|---|---|---|---|
| 100K | 0,6 s | 1,5 s | 1,1 s | 1,5 s | 1,2 s | 1,4 s |
| 1M | 0,6 s | 1,6 s | 1,4 s | 1,9 s | 1,5 s | 2,0 s |
| 5M | 0,6 s | 2,5 s | 1,8 s | 2,4 s | 1,3 s | 2,1 s |
| 10M | 0,6 s | 3,4 s | 2,2 s | 2,5 s | 1,6 s | 2,4 s |
| 20M | 0,6 s | 3,9 s | 2,7 s | 3,3 s | 1,9 s | 3,6 s |
| 50M | 0,6 s | 5,1 s | 4,2 s | 5,7 s | 1,6 s | 2,7 s |
| 100M | 0,6 s | 7,2 s | 3,5 s | 4,7 s | 1,6 s | 5,0 s |
Schemi da osservare:
In sintesi: con le dimensioni di dataset consigliate, da 1 a 10 milioni di eventi, ogni componente del Dashboard risponde in meno di 3,5 secondi. Anche con 50 milioni di eventi, la maggior parte delle query restituisce risultati in 2–4 secondi con i filtri applicati. Solo i Process Flow e le viste delle categorie senza filtri, su dataset da 50 milioni di eventi in su, raggiungono 5–6 secondi.
Questo è il consiglio più importante della guida: non inizi dal dataset più grande.
L'approccio iterativo
I numeri parlano da soli:
| Approccio | Upload (100 Mbps) | Preprocessing | Attesa totale | Velocità del Dashboard |
|---|---|---|---|---|
| Iniziare con 1M di eventi | 22 s | 55 s | circa 1,5 min | 1–2 s |
| Iniziare con 5M di eventi | 2 min | 1,5 min | circa 3,5 min | 1–2,5 s |
| Iniziare con 50M di eventi | 18 min | 2 min | circa 20 min | 1–6 s |
La maggior parte delle organizzazioni scopre che 1–5 milioni di eventi sono più che sufficienti per ottenere insight concreti. Il comportamento del processo si stabilizza ben prima di 10 milioni di eventi. Oltre questa soglia, si aggiungono soprattutto duplicati di pattern già osservati.
Se il Suo file Parquet da 1 milione di eventi, di 34 MB, viene caricato in 3 secondi e Le offre la stessa mappa di processo di 50 milioni di eventi, perché aspettare 18 minuti?
I numeri riportati sopra raccontano una storia chiara: con 1–5 milioni di eventi, gli upload richiedono pochi secondi, il preprocessing meno di 2 minuti e i Dashboard rispondono in 1–2,5 secondi. Con 50 milioni di eventi, attende 20 minuti per un upload a 100 Mbps e i Dashboard rallentano fino a 3–6 secondi. L’esperienza è radicalmente diversa.
La vera domanda, quindi, non è «quanto è veloce lo strumento?», ma «di quanti dati ho effettivamente bisogno?». La risposta è quasi sempre: meno di quanto pensa.
Analizzi prima un Paese, un reparto o una linea di prodotto.
Non si tratta di una limitazione, ma di chiarezza. Un’analisi segmentata produce insight più precisi rispetto alle medie globali.
Perché la segmentazione funziona:
Esempio: un’azienda logistica europea con 42 milioni di eventi di spedizione distribuiti in 8 Paesi:
Dimensioni della segmentazione
Geografica, inclusi Paese, regione e sito; organizzativa, inclusi unità aziendale e reparto; di prodotto, inclusi linea di prodotto e categoria; temporale, inclusi anno fiscale e trimestre; cliente, inclusi segmento e canale.
Escluda il percorso standard prima dell’upload. Questa tecnica può ridurre i dataset del 90–95%.
La maggior parte dei processi aziendali segue la regola 80/20. La grande maggioranza dei casi segue il percorso standard e si conclude con successo. Se sta cercando eccezioni, violazioni della conformità o deviazioni di processo, non ha bisogno di quei dati.
Esempio: un processo purchase-to-pay con 1,2 milioni di ordini di acquisto (8,4 milioni di eventi):
Se sta analizzando problemi di conformità, esporti solo i casi con eccezioni. Si tratta di una riduzione del 92%, da 8,4 milioni di eventi (1,9 GB) a 670.000 eventi (150 MB). Il tempo di upload scende da 3 minuti a 15 secondi a 100 Mbps. Esportando in Parquet (15 MB), può completare l’upload in meno di 2 secondi.
Come filtrare prima dell'export
Filtri per stato, ad esempio rifiutato, annullato o con eccezione; per attività specifiche, ad esempio casi che contengono «Rifiuto» o «Override manuale»; per durata del caso, ad esempio casi che richiedono più tempo del previsto; oppure per periodi specifici o unità aziendali.
Ogni colonna esportata comporta costi in termini di banda, storage e tempo di elaborazione. Scegliere con attenzione le colonne è una delle ottimizzazioni con il maggiore impatto.
Cosa escludere:
Esempio: un export SAP di 1,8 milioni di eventi relativi a ordini di acquisto, con 45 colonne, ridotto a 12 colonne essenziali:
Le colonne importanti: CaseId, Activity, Timestamp e alcuni attributi aziendali, come stato, importo, categoria e regione. Tutto il resto è probabilmente rumore.
Alcune domande analitiche richiedono realmente dataset di grandi dimensioni. Comprendere quando è necessario La aiuta a prendere la decisione giusta:
Se ha bisogno di oltre 50 milioni di eventi, pianifichi l’operazione: utilizzi il formato Parquet, che riduce un CSV da 11 GB a 1,7 GB e accelera il preprocessing; utilizzi l’API per trasferimenti affidabili; e, se disponibile, scelga una connessione di rete veloce. Dopo il primo caricamento, i Dashboard rimangono veloci.
Le sezioni precedenti riguardano il volume dei dati. L’altra metà della reattività dipende dal modo in cui sono costruiti il modello e le Dashboard:
Il modo migliore per comprendere le prestazioni del Process Mining è sperimentarle con i Suoi dati.
Inizi con un campione. Esporti 1 milione di eventi relativi a un periodo recente in formato Parquet. Li carichi. Costruisca il primo modello. Verifichi quanto rapidamente può iterare.
Applichi le tecniche di questa guida. Utilizzi formati colonnari. Filtri le eccezioni. Segmenti per regione. Rimuova le colonne non necessarie. Ogni ottimizzazione si basa sulla precedente.
Aumenti la scala in modo consapevole. Dopo aver compreso il Suo processo con 1 milione di eventi, valuti se ne servono di più. Di solito, non è necessario. Quando lo è, utilizzi il delta loading per aggiungere dati invece di ripetere l’upload.
Inizi la prova gratuita e verifichi questi benchmark direttamente. Per ricevere assistenza nel dimensionamento del Suo dataset o nell’ottimizzazione degli export, ci contatti. Abbiamo aiutato centinaia di organizzazioni a trovare il giusto equilibrio tra volume dei dati e velocità di analisi.
Scopra il processo DMAIC, il processo Six Sigma e gli strumenti per il miglioramento dei processi lean, così da ottenere risultati aziendali misurabili.
Confronti il Process Mining di Celonis con ProcessMind per trovare il software più adatto ai Suoi processi, al Suo budget e ai Suoi obiettivi.
Confronti Fluxicon Disco e ProcessMind per funzionalità, prezzi e casi d’uso, così da scegliere la piattaforma di Process Mining più adatta al Suo team.
Confronti ProcessMind e SAP Signavio per Process Mining, modellazione e simulazione. Scelga la soluzione più adatta alla Sua azienda.
Ottenga subito l’accesso, senza carta di credito né attese. Trasformi il modo in cui opera la Sua organizzazione in una progettazione dei processi chiara e connessa.
Costruisca l’architettura dei processi, definisca responsabilità e controlli e allinei ruoli e responsabilità a ogni livello.
Inizi la prova gratuita e crei un’unica base affidabile per governare, gestire e migliorare continuamente i processi.
Utilizziamo i cookie per migliorare la Sua esperienza, personalizzare i contenuti e analizzare il traffico. Facendo clic su "Accetta tutto", acconsente all’utilizzo dei cookie.