Hiệu suất process mining: số liệu kiểm thử và mẹo cải thiện
Tìm hiểu cách khối lượng dữ liệu, định dạng tệp và dạng truy vấn ảnh hưởng đến hiệu suất process mining, qua các số liệu kiểm thử từ 100K đến 100M sự kiện.

Hiệu suất process mining không chỉ phụ thuộc vào số lượng sự kiện. Kích thước tệp, số trường hợp, dạng truy vấn và tốc độ mạng đều ảnh hưởng đến thời gian chờ. Số liệu kiểm thử dưới đây bao gồm tập dữ liệu từ 100K đến 100M sự kiện. Các lần thử được thực hiện trên hạ tầng AWS thực tế vào tháng 3 năm 2026, với định dạng tệp và điều kiện thử nghiệm được mô tả tại đây.
Điểm chính cần nhớ
- Tệp lớn hoặc kết nối chậm có thể khiến thời gian tải lên chiếm phần lớn thời gian chờ.
- Tệp Parquet và ORC nhỏ hơn nhiều so với CSV thô, giúp giảm thời gian truyền dữ liệu.
- Thời gian phản hồi của dashboard phụ thuộc vào truy vấn. Thống kê phản hồi nhanh, còn luồng quy trình mất nhiều thời gian hơn khi số sự kiện tăng.
- Tải delta truyền sự kiện mới mà không cần tải lại toàn bộ tập dữ liệu.
- Tập dữ liệu tập trung giúp tải lên nhanh hơn và phân tích dễ hơn.
Yếu tố nào ảnh hưởng đến hiệu suất process mining?
Hiệu suất phụ thuộc vào bốn yếu tố: lượng dữ liệu, cấu trúc event log, truy vấn được chạy và môi trường truyền, xử lý dữ liệu.
- Số lượng sự kiện và trường hợp: Càng nhiều sự kiện, thường càng có nhiều dữ liệu cần tải lên và xử lý. Số trường hợp quyết định phạm vi phiên bản quy trình mà bạn phân tích.
- Dạng truy vấn: Truy vấn thống kê tổng hợp và truy vấn luồng quy trình cần các phép tính khác nhau. Truy vấn tính chuyển tiếp giữa các hoạt động có thể mất nhiều thời gian hơn truy vấn trên dữ liệu đã tổng hợp.
- Số lượng hoạt động và độ dài trường hợp: Nhiều hoạt động riêng biệt hơn và trường hợp dài hơn làm tăng khối lượng tính toán luồng và biến thể.
- Kích thước tệp và tốc độ mạng: Hai yếu tố này quyết định thời gian tải lên. Tệp CSV có nhiều cột và trường văn bản dài có thể lớn hơn nhiều so với tệp dạng cột gọn chứa cùng sự kiện.
Chỉ dựa vào số lượng sự kiện thì không thể dự đoán thời gian xử lý tập dữ liệu. Hãy dùng số liệu kiểm thử làm mốc tham khảo, sau đó thử với event log và các truy vấn bạn định sử dụng. Đây là cách hữu ích nhất để đánh giá hiệu suất process mining trong môi trường của bạn.
Quy trình dữ liệu: thời gian được dùng vào đâu?
Tập dữ liệu trải qua ba giai đoạn: tải lên, tiền xử lý và tính toán lại khi bạn thay đổi mô hình quy trình.
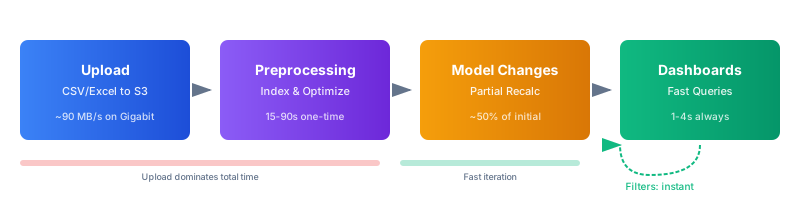
- Tải lên: Tệp được truyền qua internet đến hạ tầng đám mây của ProcessMind. Tốc độ mạng và kích thước tệp quyết định thời gian truyền. Ví dụ, tệp CSV có 50 triệu sự kiện, dung lượng 11 GB, mất khoảng 2 phút ở tốc độ 1 Gbps, 18 phút ở 100 Mbps hoặc hơn 3 giờ ở 10 Mbps. Cùng dữ liệu đó trong tệp Parquet 1,7 GB mất khoảng 19 giây, 3 phút hoặc 28 phút ở các tốc độ tương ứng.
- Tiền xử lý: Sau khi tải lên, hệ thống chuyển dữ liệu sang bộ nhớ dạng cột đã tối ưu, lập chỉ mục sự kiện, tính các bước chuyển tiếp giữa hoạt động và biến thể quy trình, rồi tạo thống kê tổng hợp. Trong các lần kiểm thử dưới đây, giai đoạn này mất 35 giây với 100K sự kiện và tối đa 2,5 phút với 100M sự kiện.
- Thay đổi mô hình: Khi bạn đổi cách ánh xạ hoạt động hoặc thêm, xóa hoạt động, ProcessMind cập nhật các phép tính phụ thuộc vào mô hình. Trong các lần kiểm thử dưới đây, việc này mất khoảng 14 giây với 1M sự kiện và 52 giây với 100M sự kiện. Thay đổi bộ lọc có hiệu lực ngay.
Với tập dữ liệu lớn, giảm kích thước tệp thường là cách hiệu quả nhất để rút ngắn thời gian chờ ban đầu. Sau khi tiền xử lý, tốc độ truy vấn phụ thuộc vào những phép tính dashboard cần thực hiện.
Hiệu suất truy vấn thay đổi ra sao?
Mỗi truy vấn có mức tiêu tốn tài nguyên khác nhau. Những đặc điểm sau giúp bạn biết điều gì cần lưu ý và cách chuẩn bị dữ liệu.
- Số lượng hoạt động: Mô hình có 10–20 hoạt động riêng biệt thường dễ phân tích và hiển thị hơn. Khi có trên 50 hoạt động, việc tính toán luồng quy trình mất nhiều thời gian hơn và kết quả có thể khó đọc. Hãy nhóm các bước liên quan nếu cách đó phản ánh đúng quy trình.
- Mức đa dạng của biến thể: Quy trình mà phần lớn trường hợp đi theo một số ít luồng thường phân tích nhanh hơn quy trình mà mỗi trường hợp đi theo một luồng khác nhau. Mức độ khác biệt cao có thể mang ý nghĩa, nhưng cũng làm tăng thời gian truy vấn.
- Số lượng cột: Các trường cốt lõi CaseId, Activity và Timestamp là cần thiết để phân tích quy trình. Thuộc tính bổ sung hỗ trợ lọc và phân loại, nhưng làm tăng lượng dữ liệu cần truyền và quét.
- Độ dài trường hợp: Trường hợp có 50 sự kiện cần xử lý nhiều hơn trường hợp có 5 sự kiện. Quy trình có các trường hợp kéo dài hàng trăm sự kiện có thể mất nhiều thời gian truy vấn hơn.
Thời gian phản hồi của dashboard
Đây là giá trị trung vị từ nhiều lần kiểm thử. Mỗi thành phần dashboard chạy truy vấn riêng và tải song song.
| Tập dữ liệu | Thống kê | Luồng quy trình | Biến thể | Danh mục | Trình duyệt dữ liệu | Hoạt ảnh |
|---|---|---|---|---|---|---|
| 100K | 0.6s | 1.5s | 1.1s | 1.5s | 1.2s | 1.4s |
| 1M | 0.6s | 1.6s | 1.4s | 1.9s | 1.5s | 2.0s |
| 5M | 0.6s | 2.5s | 1.8s | 2.4s | 1.3s | 2.1s |
| 10M | 0.6s | 3.4s | 2.2s | 2.5s | 1.6s | 2.4s |
| 20M | 0.6s | 3.9s | 2.7s | 3.3s | 1.9s | 3.6s |
| 50M | 0.6s | 5.1s | 4.2s | 5.7s | 1.6s | 2.7s |
| 100M | 0.6s | 7.2s | 3.5s | 4.7s | 1.6s | 5.0s |
Thời gian thống kê duy trì ở mức khoảng 0,6 giây với mọi kích thước được thử nghiệm. Luồng quy trình mất nhiều thời gian hơn khi số sự kiện tăng vì phải tính các bước chuyển tiếp giữa hoạt động. Biến thể và Danh mục tăng thời gian ở mức vừa phải, còn Trình duyệt dữ liệu vẫn phản hồi nhanh nhờ phân trang. Thời gian chạy hoạt ảnh thay đổi theo số trường hợp đang hiển thị.
Với 1M đến 10M sự kiện, thời gian phản hồi đo được dao động từ 0,6 đến 3,4 giây, tùy thành phần. Với 50M sự kiện, Luồng quy trình và Danh mục mất khoảng 5–6 giây. Đây là kết quả kiểm thử, không phải cam kết cho mọi tập dữ liệu hay môi trường.
Dữ liệu kiểm thử: điều kiện thử nghiệm là gì?
Các lần kiểm thử này được thực hiện trên hạ tầng AWS thực tế vào tháng 3 năm 2026. Thời gian tải lên và tiền xử lý là giá trị trung bình của nhiều lần thử. Thời gian phản hồi dashboard là giá trị trung vị qua nhiều lần thử. Mỗi kích thước tập dữ liệu được thử với hơn 50 loại truy vấn.
Số lượng sự kiện bên dưới là số liệu thực tế trong các tệp kiểm thử. Dung lượng tệp được tính cho CSV chưa nén với lược đồ nhật ký sự kiện thông thường: CaseId, Activity, Timestamp và 5–8 thuộc tính nghiệp vụ. Dung lượng tệp và kết quả của bạn sẽ khác tùy theo số cột, nội dung, điều kiện mạng, khoảng cách đến trung tâm dữ liệu và tải hiện tại.
Thời gian tải lên và tiền xử lý
| Tập dữ liệu | Số sự kiện thực tế | Kích thước tệp | Tải lên (1 Gbps) | Tải lên (100 Mbps) | Tải lên (50 Mbps) | Tải lên (10 Mbps) | Tiền xử lý |
|---|---|---|---|---|---|---|---|
| 100K | 125,260 | 22 MB | < 1s | 2s | 4s | 22s | 35s |
| 500K | 626,300 | 110 MB | 1s | 11s | 22s | 2 min | 45s |
| 1M | 1,253,424 | 221 MB | 3s | 22s | 44s | 4 min | 55s |
| 2M | 2,506,848 | 443 MB | 5s | 44s | 1.5 min | 7 min | 1 min |
| 5M | 4,996,877 | 1.1 GB | 13s | 2 min | 4 min | 18 min | 1.5 min |
| 10M | 12,511,867 | 2.2 GB | 25s | 4 min | 7 min | 37 min | 1.5 min |
| 20M | 25,023,734 | 4.4 GB | 50s | 7 min | 15 min | 1.2 hr | 2 min |
| 50M | 62,559,335 | 11.1 GB | 2 min | 18 min | 37 min | 3 hr | 2 min |
| 100M | 125,118,670 | 22.3 GB | 4 min | 37 min | 1.2 hr | 6 hr | 2.5 min |
Tốc độ truyền 1 Gbps đo được là 88 MB/s đến AWS eu-central-1. Các tốc độ khác được ước tính theo thông lượng thực tế: khoảng 5 MB/s ở 50 Mbps, 10 MB/s ở 100 Mbps và 1 MB/s ở 10 Mbps. Thông lượng thực tế tùy thuộc vào mạng và điều kiện kết nối của bạn.
Trong lần thử này, tiền xử lý mất từ 35 giây đến 2,5 phút. Thời gian tải lên tăng theo kích thước tệp, nên chiếm phần lớn thời gian chờ với các tệp lớn.
Định dạng tệp: Parquet và ORC so với CSV
ProcessMind hỗ trợ CSV, Parquet, ORC, Excel và XES. Phần so sánh kích thước tệp này dùng cùng số lượng sự kiện và cấu trúc như trong lần kiểm thử ở trên.
| Tập dữ liệu | CSV | Parquet | ORC | CSV.GZ |
|---|---|---|---|---|
| 1M sự kiện | 221 MB | 34 MB | 39 MB | 20 MB |
| 5M sự kiện | 1.1 GB | 151 MB | 197 MB | 107 MB |
| 10M sự kiện | 2.2 GB | 301 MB | 395 MB | 215 MB |
| 20M sự kiện | 4.4 GB | 603 MB | 791 MB | 430 MB |
| 50M sự kiện | 11.1 GB | 1.7 GB | 1.9 GB | 1.1 GB |
| 100M sự kiện | 22.3 GB | 3.4 GB | 3.7 GB | 2.2 GB |
Trong các lần thử này, tệp Parquet nhỏ hơn CSV khoảng 85%, còn tệp ORC nhỏ hơn khoảng 82%. Cả hai đều là định dạng dạng cột có tích hợp nén. Các công cụ dữ liệu như Spark, Databricks, dbt và BigQuery có thể hỗ trợ xuất dữ liệu sang những định dạng này.
Thời gian tiền xử lý của Parquet, ORC và CSV tương đương nhau. CSV.GZ mất nhiều thời gian hơn khi số sự kiện lớn vì không thể chia tệp gzip để giải nén song song.
| Tập dữ liệu | Parquet | ORC | CSV | CSV.GZ |
|---|---|---|---|---|
| 1M sự kiện | 55s | 55s | 55s | 55s |
| 5M sự kiện | 1.5 min | 1.5 min | 1.5 min | 1.5 min |
| 10M sự kiện | 1.5 min | 1.5 min | 1.5 min | 2 min |
| 20M sự kiện | 2 min | 2 min | 2 min | 2.5 min |
| 50M sự kiện | 2 min | 2 min | 2 min | 3 min |
| 100M sự kiện | 2.5 min | 2.5 min | 2.5 min | 4.5 min |
Tổng thời gian gồm thời gian tải lên và tiền xử lý. Các ví dụ này dùng kết nối 100 Mbps.
| 10M sự kiện (100 Mbps) | Kích thước tệp | Tải lên | Tiền xử lý | Tổng |
|---|---|---|---|---|
| Parquet | 301 MB | 30s | 1.5 min | ~2 min |
| ORC | 395 MB | 40s | 1.5 min | ~2.2 min |
| CSV | 2.2 GB | 4 min | 1.5 min | ~5.5 min |
| CSV.GZ | 215 MB | 21s | 2 min | ~2.5 min |
| 50M sự kiện (100 Mbps) | Kích thước tệp | Tải lên | Tiền xử lý | Tổng |
|---|---|---|---|---|
| Parquet | 1.7 GB | 3 min | 2 min | ~5 min |
| ORC | 1.9 GB | 3.2 min | 2 min | ~5.2 min |
| CSV | 11.1 GB | 18 min | 2 min | ~20 min |
| CSV.GZ | 1.1 GB | 2 min | 3 min | ~5 min |
Với tập dữ liệu lớn, Parquet và ORC giảm thời gian truyền vì tệp nhỏ hơn. CSV vẫn là lựa chọn đơn giản cho tập dữ liệu nhỏ hoặc khi quy trình xuất dữ liệu của bạn không hỗ trợ định dạng dạng cột. CSV.GZ có thể giảm thời gian truyền khi kết nối chậm, nhưng thời gian giải nén tăng theo kích thước tập dữ liệu.
Chọn định dạng tệp
- Parquet: Lựa chọn mặc định phù hợp cho tập dữ liệu lớn nếu quy trình dữ liệu của bạn hỗ trợ. Định dạng này tạo ra các tệp nhỏ nhất trong những lần kiểm thử.
- ORC: Lựa chọn tương tự, nhất là khi quy trình dữ liệu của bạn dùng Hadoop hoặc Spark.
- CSV: Đơn giản và được hỗ trợ rộng rãi. Có thể phù hợp với tập dữ liệu nhỏ.
- CSV.GZ: Cân nhắc định dạng này khi tốc độ tải lên là trở ngại chính. Hãy thử thời gian tiền xử lý với dữ liệu của bạn, nhất là khi số sự kiện lớn.
Dạng truy vấn nào có thể làm chậm phân tích?
Một số kiểu dữ liệu và dashboard cần xử lý nhiều hơn những kiểu khác. Hãy dùng các tiêu chí sau để tìm nguyên nhân có thể khiến truy vấn chậm.
- Quá nhiều hoạt động: Luồng quy trình có hơn 50 hoạt động riêng biệt có thể mất nhiều thời gian tính toán và khó diễn giải. Hãy nhóm các bước liên quan khi phù hợp.
- Nhiều biến thể khác nhau: Khi các trường hợp đi theo nhiều đường khác nhau, việc tính biến thể cần xử lý nhiều hơn. Mức độ biến thiên cao cũng có thể cho thấy hành vi quy trình cần được tìm hiểu thêm.
- Trường hợp dài: Trường hợp có nhiều sự kiện cần xử lý nhiều hơn trường hợp ngắn.
- Cột không cần thiết: Thuộc tính bổ sung làm tăng kích thước tệp và có thể tăng khối lượng xử lý khi được truy vấn. Chỉ giữ lại các trường phục vụ phân tích.
- Dashboard lớn, nhiều thành phần: Mỗi biểu đồ hoặc ô chạy một truy vấn riêng. Chỉ giữ các thành phần trả lời câu hỏi rõ ràng, và chuyển những chế độ xem khác sang dashboard riêng.
- Biểu đồ tốn nhiều tài nguyên: Với tập dữ liệu lớn, biểu đồ có nhiều danh mục có thể mất nhiều thời gian kết xuất hơn. Dùng chế độ xem tổng hợp nếu bạn không cần phân tích chi tiết.
- Hoạt ảnh có nhiều trường hợp đang chạy: Thời gian chạy hoạt ảnh phụ thuộc vào số trường hợp được hiển thị. Giảm tốc độ hoặc tắt đuôi và hiệu ứng nếu bạn chỉ cần xem luồng quy trình.
Nên chọn kích thước dữ liệu phù hợp như thế nào?
Bắt đầu với tập dữ liệu nhỏ nhất có thể trả lời câu hỏi của bạn. Tập dữ liệu tập trung tải lên nhanh hơn và dễ xác minh hơn. Hãy mở rộng khi cần phạm vi bao quát hơn, sự kiện hiếm hoặc xu hướng dài hạn.
Xây dựng và xác minh mô hình với tập dữ liệu nhỏ
Bắt đầu bằng một mẫu dữ liệu gần đây, cấu hình mô hình rồi kiểm tra dữ liệu trước khi mở rộng.
- Bắt đầu với một mẫu dữ liệu. Ví dụ, trích xuất 1M sự kiện trong giai đoạn ba tháng gần đây. Trong lần kiểm thử, tải lên mất 3 giây ở tốc độ 1 Gbps hoặc 22 giây ở 100 Mbps, sau đó tiền xử lý mất 55 giây.
- Xây dựng mô hình. Cấu hình hoạt động, bộ lọc và chế độ xem. Với các tập dữ liệu từ 1M đến 10M sự kiện được thử nghiệm, thay đổi mô hình mất khoảng 14–20 giây.
- Xác minh kết quả. Kiểm tra tên hoạt động và đường đi quy trình có hợp lý không, rồi xử lý các vấn đề về chất lượng dữ liệu.
- Bổ sung dữ liệu nếu cần. Tăng số sự kiện khi cần tìm hiểu trường hợp hiếm hoặc so sánh các giai đoạn dài hơn.
Bảng dưới đây so sánh thời gian chờ ban đầu với các số lượng sự kiện khác nhau qua kết nối 100 Mbps.
| Cách làm | Tải lên (100 Mbps) | Tiền xử lý | Tổng thời gian chờ | Tốc độ dashboard |
|---|---|---|---|---|
| Bắt đầu với 1M sự kiện | 22s | 55s | ~1.5 min | 1–2s |
| Bắt đầu với 5M sự kiện | 2 min | 1.5 min | ~3.5 min | 1–2.5s |
| Bắt đầu với 50M sự kiện | 18 min | 2 min | ~20 min | 1–6s |
Số lượng sự kiện phù hợp tùy thuộc vào câu hỏi của bạn. Tập dữ liệu nhỏ có thể đủ để tìm hiểu các kiểu quy trình phổ biến, nhưng bạn có thể cần thêm dữ liệu để nghiên cứu sự kiện hiếm hoặc đáp ứng yêu cầu bao quát toàn bộ đối tượng.
Chia dữ liệu thành phân khúc nếu câu hỏi có phạm vi cụ thể
Nếu đang tìm hiểu một quốc gia, phòng ban hoặc dòng sản phẩm, hãy bắt đầu với phân khúc đó thay vì gộp các nhóm không liên quan. Chia dữ liệu thành phân khúc giúp so sánh rõ hơn và giảm lượng dữ liệu cần xử lý.
Ví dụ, số liệu kiểm thử mô tả tập dữ liệu logistics ở châu Âu với 42M sự kiện giao hàng tại 8 quốc gia:
- Tất cả quốc gia: 42M sự kiện, 9,3 GB, mất 16 phút tải lên ở tốc độ 100 Mbps và 2 phút tiền xử lý.
- Đức: 8,5M sự kiện, 1,9 GB, mất 3 phút tải lên và 1,5 phút tiền xử lý.
- Hà Lan: 3,1M sự kiện, 690 MB, mất 1 phút tải lên và 1 phút tiền xử lý.
Bạn có thể so sánh các phân khúc sau khi xác minh từng phân khúc. Các chiều phân tích hữu ích gồm địa lý, tổ chức, sản phẩm, giai đoạn thời gian và nhóm khách hàng.
Lọc theo các trường hợp cần phân tích
Nếu đang tìm hiểu các trường hợp ngoại lệ, chỉ xuất những trường hợp liên quan có thể giúp giảm đáng kể tập dữ liệu. Ví dụ, số liệu kiểm thử mô tả quy trình mua hàng đến thanh toán với 1,2 triệu đơn đặt hàng và 8,4M sự kiện. Theo số liệu này, 96.000 đơn hàng, tương đương 8%, có ngoại lệ như bị từ chối, hàng trả lại, hóa đơn trùng hoặc thiếu phê duyệt.
Trong phân tích này, chỉ xuất các trường hợp ngoại lệ giúp giảm tập dữ liệu từ 8,4M xuống còn 670K sự kiện. Kích thước tệp giảm từ 1,9 GB xuống 150 MB, còn thời gian tải lên ở tốc độ 100 Mbps giảm từ 3 phút xuống 15 giây. Trong lần kiểm thử, xuất cùng dữ liệu đó thành tệp Parquet 15 MB chỉ mất chưa đến 2 giây để tải lên.
Hãy lọc theo trạng thái, hoạt động, thời lượng trường hợp, giai đoạn thời gian hoặc đơn vị kinh doanh nếu các trường này phù hợp với câu hỏi bạn đang tìm hiểu.
Chỉ chọn những cột bạn cần
Mỗi cột đều làm tăng kích thước tệp. Trường văn bản dài, mã định danh trùng lặp, trường kiểm toán và siêu dữ liệu kỹ thuật có thể không cần thiết cho phân tích.
Số liệu kiểm thử mô tả dữ liệu xuất từ SAP gồm 1,8M sự kiện đơn đặt hàng với 45 cột. Giảm xuống còn 12 cột thiết yếu giúp kích thước tệp giảm từ 2,1 GB xuống 380 MB. Xuất các cột đó thành Parquet giúp giảm thêm xuống 58 MB. Thời gian tải lên ở tốc độ 100 Mbps giảm từ 3,5 phút xuống còn 6 giây.
Giữ lại các trường phục vụ phân tích, gồm CaseId, Activity, Timestamp và thuộc tính nghiệp vụ liên quan như trạng thái, số tiền, danh mục hoặc khu vực. Xóa thông tin cá nhân nếu không cần cho việc phân tích.
Khi nào nên dùng tập dữ liệu lớn hơn?
Bạn có thể cần nhiều sự kiện hơn nếu câu hỏi phụ thuộc vào độ bao phủ hoặc khoảng thời gian.
- Sự kiện hiếm: Để tìm các ngoại lệ chỉ xảy ra 1 lần trong 100.000 trường hợp, bạn cần tập dữ liệu đủ lớn để có thể ghi nhận chúng. Nếu ngoại lệ xảy ra trong 0,01% trường hợp và bạn muốn nghiên cứu 50 ngoại lệ, bạn cần khoảng 500K trường hợp.
- Biến thể ít gặp: Biến thể xảy ra trong 0,1% trường hợp có thể không xuất hiện rõ trong mẫu 1M sự kiện, nhưng lại đo lường được trong tập dữ liệu 50M sự kiện.
- Tuân thủ và kiểm toán: Một số yêu cầu đòi hỏi bao phủ toàn bộ dữ liệu thay vì lấy mẫu.
- Xu hướng dài hạn: Để so sánh quý 1 năm 2024, quý 1 năm 2025 và quý 1 năm 2026, bạn cần dữ liệu của cả ba giai đoạn. Tải dữ liệu delta giúp mở rộng phạm vi dữ liệu theo từng đợt.
Với tập dữ liệu trên 50M sự kiện, kết quả kiểm thử cho thấy bạn nên dùng Parquet, tải dữ liệu qua API và chọn kết nối mạng nhanh nếu có. Tệp CSV 50M sự kiện trong bài kiểm thử có dung lượng 11,1 GB, trong khi tệp Parquet chỉ 1,7 GB.
Hiệu suất luôn đi kèm sự đánh đổi: xử lý nhiều dữ liệu hơn và nhanh hơn sẽ tốn kém hơn. Câu hỏi quan trọng không phải là công cụ làm được gì, mà là quy trình của bạn cần gì. ProcessMind xử lý được tập dữ liệu lớn, nhưng chúng tôi vẫn khuyên bạn cân nhắc kỹ trước khi dùng tập dữ liệu khổng lồ. Thường thì không cần đến mức đó, mà còn làm tăng độ phức tạp và khiến bạn mất tập trung vào việc cải tiến quy trình.
Làm thế nào để mô hình và giao diện luôn phản hồi nhanh?
Khối lượng dữ liệu chỉ là một phần. Cách thiết kế mô hình quy trình và dashboard cũng ảnh hưởng đến tốc độ làm việc của bạn.
- Giữ mô hình dễ đọc: Chia quy trình lớn thành các Subprocesses theo mô-đun. Canvas có quá nhiều phần tử hiển thị có thể tải chậm hơn và khó điều hướng. Dùng auto-layout sau khi thay đổi cấu trúc.
- Chọn thành phần dashboard phù hợp: Mỗi biểu đồ và ô thông tin đều cần tính toán. Chỉ giữ lại những chế độ xem trả lời được câu hỏi bạn đang cần.
- Dùng biểu đồ phù hợp với dữ liệu: Với tập dữ liệu lớn, biểu đồ có nhiều nhóm dữ liệu có thể mất nhiều thời gian tính toán hơn. Hãy dùng số liệu tổng hợp nếu bạn không cần xem chi tiết.
- Chỉ dùng bộ lọc cần thiết cho câu hỏi: Bộ lọc giúp thu hẹp phạm vi phân tích. Tránh kết hợp những bộ lọc không giúp trả lời câu hỏi bạn đang tìm hiểu.
- Điều chỉnh hoạt ảnh: Chi phí xử lý hoạt ảnh tăng theo số trường hợp đang hoạt động. Giảm tốc độ hoặc tắt đuôi và hiệu ứng nếu bạn chỉ cần xem luồng quy trình. Xem Process Animation.
- Chỉ tính toán lại phần đã thay đổi: Khi mô hình thay đổi, các phép tính phụ thuộc vào mô hình sẽ được cập nhật mà không cần chạy lại toàn bộ bước tiền xử lý. Trong bài kiểm thử, thời gian xử lý thay đổi dao động từ khoảng 14 giây với 1M sự kiện đến 52 giây với 100M sự kiện.
Tải dữ liệu delta giúp giảm thời gian tải lên như thế nào?
Tải dữ liệu delta cho phép bạn thêm sự kiện mới vào tập dữ liệu hiện có thay vì tải lại toàn bộ. Cách này giảm lượng dữ liệu cần truyền khi bạn cập nhật nhật ký sự kiện đang tăng dần.
| Tình huống | Tải lại toàn bộ | Tải delta | Thời gian tiết kiệm |
|---|---|---|---|
| 10M dữ liệu gốc + 500K sự kiện mới (100 Mbps) | Tải lên 4 phút | Tải lên 5 giây | ~4 phút |
| 20M dữ liệu gốc + 2M sự kiện mới (100 Mbps) | Tải lên 7 phút | Tải lên 44 giây | ~6 phút |
| 50M dữ liệu gốc + 5M sự kiện mới (100 Mbps) | Tải lên 18 phút | Tải lên 2 phút | ~16 phút |
Sau khi tải delta, hệ thống chạy lại bước tiền xử lý trên tập dữ liệu đã gộp. Trong bài kiểm thử, bước này mất từ 1 đến 2,5 phút. Thời gian tiết kiệm được là nhờ chỉ truyền các sự kiện mới.
Tệp delta phải dùng cùng định dạng và cấu trúc cột với tệp tải lên ban đầu. Xem hướng dẫn tải dữ liệu tăng dần để biết thêm chi tiết.
Khi nào nên tải dữ liệu qua API?
Nếu thường xuyên tải dữ liệu lên hoặc làm việc với tệp có dung lượng vài gigabyte, tải qua API có thể dễ quản lý hơn so với tải bằng trình duyệt. Bạn có thể tích hợp tập lệnh hoặc công cụ dòng lệnh vào quy trình ETL, lên lịch tải dữ liệu và theo dõi tiến độ truyền.
ProcessMind cung cấp URL ký trước để tải trực tiếp lên bộ nhớ đám mây. Bạn có thể sao chép URL tải lên trong menu cài đặt tập dữ liệu trên giao diện ProcessMind.
# Upload a Parquet file directly using a presigned URL
curl -X PUT "$PRESIGNED_URL" --upload-file data.parquet
Xem tài liệu API để tham khảo ví dụ bằng Bash, JavaScript và Python, bao gồm cách lấy URL ký trước và tải tệp delta lên.
Khi nào nên chia tập dữ liệu?
Hãy chia tập dữ liệu khi một phân tích cụ thể chỉ cần một phần dữ liệu hoặc khi bạn cần so sánh riêng từng nhóm. Bạn có thể phân chia theo khu vực địa lý, phòng ban, dòng sản phẩm, giai đoạn thời gian hoặc loại trường hợp, rồi phân tích từng tập riêng.
Hãy giữ dữ liệu chung một tập nếu câu hỏi của bạn cần so sánh các nhóm hoặc theo dõi toàn bộ quy trình giữa các nhóm. Trước khi chia, hãy kiểm tra xem việc này có làm thay đổi ý nghĩa của trường hợp hoặc loại bỏ sự kiện cần thiết để hiểu luồng xử lý hay không. Ví dụ, khi chia theo thời gian, cần tính đến các trường hợp bắt đầu ở giai đoạn này nhưng kết thúc ở giai đoạn khác.
Kiểm tra hiệu suất bằng dữ liệu của bạn
Kết quả kiểm thử giúp bạn lập kế hoạch, nhưng không thể dự đoán chính xác hiệu suất với mọi nhật ký sự kiện, mạng hay truy vấn. Hãy thử với tập dữ liệu bạn dự định sử dụng, rồi kiểm tra thời gian tải lên, tiền xử lý và phản hồi của những chế độ xem dashboard quan trọng với bạn.
Trước tiên, hãy xem hướng dẫn chuẩn bị dữ liệu nếu bạn cần trợ giúp định dạng nhật ký sự kiện. Bạn cũng có thể tìm hiểu cách phân tích quy trình và cách theo dõi quy trình liên tục.
Kiểm tra với khối lượng dữ liệu thực tế của bạn
Tải nhật ký sự kiện bạn dự định phân tích và đo hiệu suất với dữ liệu của mình.