プロセスマイニングのパフォーマンス:ベンチマークと改善のヒント
データ量やファイル形式、クエリの構造がプロセスマイニングの処理性能にどう影響するのか、10万件から1億件までのイベントを対象にした日付入りのベンチマークで紹介します。

プロセスマイニングの処理性能は、イベント数だけで決まるわけではありません。ファイルサイズ、ケース数、クエリの構成、ネットワークのスループットも待ち時間に影響します。以下のベンチマークでは、10万件から1億件までのイベントを含むデータセットを対象としています。2026年3月にAWSの本番環境で実施し、使用したファイル形式とテスト条件を記載しています。
主なポイント
- 大容量ファイルや低速な接続では、アップロード時間が待ち時間の大部分を占めることがあります。
- ParquetやORC形式のファイルは、生のCSVより大幅に小さいため、転送時間を短縮できます。
- ダッシュボードの応答時間はクエリによって異なります。統計情報はすばやく表示されますが、イベント数が増えるとプロセスフローの表示には時間がかかります。
- 差分読み込みでは、新しいイベントだけを転送するため、データセット全体を再度アップロードする必要はありません。
- 対象を絞ったデータセットは、アップロードが速く、分析もしやすくなります。
プロセスマイニングのパフォーマンスを左右する要因
パフォーマンスを左右する要因は4つあります。データ量、イベントログの構造、実行するクエリ、そしてデータの転送と処理に使う環境です。
- **イベント数とケース数:**イベント数が多いほど、アップロードや処理に必要なデータ量も増えます。ケース数によって、分析対象となるプロセスインスタンスの数が決まります。
- **クエリの種類:**集計値の算出とプロセスフローの表示では、必要な計算が異なります。アクティビティ間の遷移を計算するクエリは、事前に集計されたデータを使うクエリより時間がかかることがあります。
- **アクティビティ数とケースの長さ:**異なるアクティビティの数が多く、ケースが長いほど、フローやバリアントの計算に時間がかかります。
- **ファイルサイズとネットワーク速度:**この2つがアップロード時間を左右します。同じイベントを含むデータでも、テキスト項目の多い横長のCSVは、列指向形式のコンパクトなファイルより大幅に大きくなることがあります。
イベント数だけでは、データセットの処理時間を予測できません。ベンチマークを目安にしながら、実際に使うイベントログとクエリでテストしてください。ご利用環境におけるプロセスマイニングのパフォーマンスを把握するには、この方法が最も役立ちます。
データ処理の流れと所要時間
データセットは、アップロード、前処理、プロセスモデルの変更に伴う再計算という3つの段階を経ます。
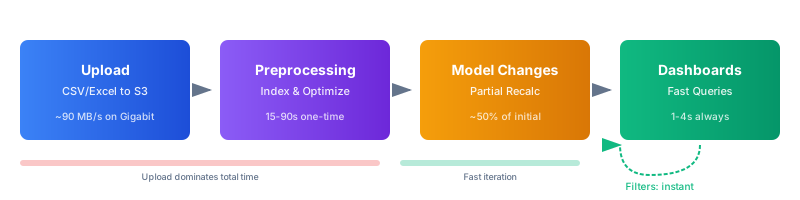
- **アップロード:**ファイルはインターネット経由でProcessMindのクラウド環境に転送されます。転送時間はネットワークの速度とファイルサイズによって決まります。たとえば、イベント数が5,000万件でファイルサイズが11GBのCSVの場合、1Gbpsでは約2分、100Mbpsでは18分、10Mbpsでは3時間以上かかります。同じデータを1.7GBのParquetファイルにすると、それぞれ約19秒、3分、28分です。
- **前処理:**アップロード後、システムはデータを最適化された列指向ストレージに変換し、イベントにインデックスを付け、アクティビティ間の遷移とプロセスのバリアントを計算して、集計統計を作成します。以下のベンチマークでは、イベント数10万件で35秒、1億件で最長2.5分かかりました。
- **モデルの変更:**アクティビティの対応関係を変更したり、アクティビティを追加・削除したりすると、ProcessMindはモデルに依存する計算を更新します。以下のベンチマークでは、イベント数100万件で約14秒、1億件で52秒かかりました。フィルターの変更はすぐに反映されます。
大規模なデータセットでは、ファイルサイズを小さくすることが、最初の待ち時間を短縮する最も効果的な方法となることがよくあります。前処理後のクエリの応答速度は、ダッシュボードで必要となる計算によって異なります。
クエリの種類による応答速度の違い
クエリの種類によって処理負荷は異なります。次の特徴を把握すると、応答速度の目安やデータの整え方がわかります。
- **アクティビティ数:**異なるアクティビティが10~20個のモデルは、分析や表示が比較的容易です。50個を超えると、プロセスフローの計算に時間がかかり、読み取りにくくなることがあります。プロセスの実態を正しく表せる場合は、関連するステップをまとめてください。
- **バリアントの多様性:**多くのケースが少数の経路をたどるプロセスは、ケースごとに経路が異なるプロセスより、一般に分析が速くなります。ばらつきが大きいこと自体に意味がある場合もありますが、クエリの処理時間が長くなることがあります。
- **列数:**プロセス分析には、CaseId、Activity、Timestampの各項目が必要です。追加の属性は絞り込みや分類に役立ちますが、転送・スキャンするデータ量が増えます。
- **ケースの長さ:**イベント数50件のケースは、5件のケースより処理に時間がかかります。数百件のイベントにまたがるケースを含むプロセスでは、クエリの処理時間が長くなることがあります。
ダッシュボードの応答時間
以下の数値は、複数回のベンチマーク実行で得られた中央値です。ダッシュボードの各コンポーネントは個別にクエリを実行し、並行して読み込まれます。
| データセット | 統計情報 | プロセスフロー | バリアント | カテゴリー | データブラウザー | アニメーション |
|---|---|---|---|---|---|---|
| 10万件 | 0.6秒 | 1.5秒 | 1.1秒 | 1.5秒 | 1.2秒 | 1.4秒 |
| 100万件 | 0.6秒 | 1.6秒 | 1.4秒 | 1.9秒 | 1.5秒 | 2.0秒 |
| 500万件 | 0.6秒 | 2.5秒 | 1.8秒 | 2.4秒 | 1.3秒 | 2.1秒 |
| 1,000万件 | 0.6秒 | 3.4秒 | 2.2秒 | 2.5秒 | 1.6秒 | 2.4秒 |
| 2,000万件 | 0.6秒 | 3.9秒 | 2.7秒 | 3.3秒 | 1.9秒 | 3.6秒 |
| 5,000万件 | 0.6秒 | 5.1秒 | 4.2秒 | 5.7秒 | 1.6秒 | 2.7秒 |
| 1億件 | 0.6秒 | 7.2秒 | 3.5秒 | 4.7秒 | 1.6秒 | 5.0秒 |
テストしたデータセットの規模にかかわらず、統計情報の表示は約0.6秒でした。プロセスフローはアクティビティ間の遷移を計算するため、イベント数が増えるほど時間がかかりました。バリアントとカテゴリーの処理時間は緩やかに増加しました。データブラウザーはページ分割によって応答性を保ちました。アニメーションの所要時間は、表示するアクティブなケース数によって変わりました。
イベント数が100万~1,000万件の場合、コンポーネントによって応答時間は0.6~3.4秒でした。イベント数が5,000万件の場合、プロセスフローとカテゴリーの表示には約5~6秒かかりました。これらはベンチマークの結果であり、すべてのデータセットや環境で同じ結果になることを保証するものではありません。
ベンチマークの条件
これらのベンチマークは、2026年3月にAWSの本番環境で実施しました。アップロード時間と前処理時間は、複数回のテストの平均値です。ダッシュボードの応答時間は、複数回の実行における中央値です。テストでは、データセットの各規模について50種類以上のクエリを実行しました。
以下のイベント数は、テストファイルに含まれる実際の件数です。ファイルサイズは、一般的なイベントログのスキーマ(CaseId、Activity、Timestamp、業務属性5~8項目)を使った、圧縮前のCSVの値です。実際のファイルサイズや結果は、列数や内容、ネットワーク状況、データセンターまでの距離、現在の負荷によって異なります。
アップロードと前処理の所要時間
| データセット | 実際のイベント数 | ファイルサイズ | アップロード(1Gbps) | アップロード(100Mbps) | アップロード(50Mbps) | アップロード(10Mbps) | 前処理 |
|---|---|---|---|---|---|---|---|
| 10万件 | 125,260 | 22MB | < 1秒 | 2秒 | 4秒 | 22秒 | 35秒 |
| 50万件 | 626,300 | 110MB | 1秒 | 11秒 | 22秒 | 2分 | 45秒 |
| 100万件 | 1,253,424 | 221MB | 3秒 | 22秒 | 44秒 | 4分 | 55秒 |
| 200万件 | 2,506,848 | 443MB | 5秒 | 44秒 | 1.5分 | 7分 | 1分 |
| 500万件 | 4,996,877 | 1.1GB | 13秒 | 2分 | 4分 | 18分 | 1.5分 |
| 1,000万件 | 12,511,867 | 2.2GB | 25秒 | 4分 | 7分 | 37分 | 1.5分 |
| 2,000万件 | 25,023,734 | 4.4GB | 50秒 | 7分 | 15分 | 1.2時間 | 2分 |
| 5,000万件 | 62,559,335 | 11.1GB | 2分 | 18分 | 37分 | 3時間 | 2分 |
| 1億件 | 125,118,670 | 22.3GB | 4分 | 37分 | 1.2時間 | 6時間 | 2.5分 |
AWS eu-central-1への転送速度は、実測で88MB/秒でした。その他の速度は、実際の転送速度をもとに推定しています。50Mbpsでは約5MB/秒、100Mbpsでは10MB/秒、10Mbpsでは1MB/秒です。実際の転送速度は、ネットワークや環境によって異なります。
このテストでは、前処理に35秒~2.5分かかりました。ファイルサイズが大きいほどアップロード時間も長くなり、大容量ファイルでは待ち時間の大部分を占めました。
ファイル形式:Parquet・ORCとCSVの比較
ProcessMindはCSV、Parquet、ORC、Excel、XESに対応しています。以下のファイルサイズ比較では、上記のベンチマークと同じイベント数とスキーマを使用しています。
| データセット | CSV | Parquet | ORC | CSV.GZ |
|---|---|---|---|---|
| イベント数100万件 | 221MB | 34MB | 39MB | 20MB |
| イベント数500万件 | 1.1GB | 151MB | 197MB | 107MB |
| イベント数1,000万件 | 2.2GB | 301MB | 395MB | 215MB |
| イベント数2,000万件 | 4.4GB | 603MB | 791MB | 430MB |
| イベント数5,000万件 | 11.1GB | 1.7GB | 1.9GB | 1.1GB |
| イベント数1億件 | 22.3GB | 3.4GB | 3.7GB | 2.2GB |
今回のテストでは、ParquetファイルはCSVより約85%小さく、ORCファイルは約82%小さくなりました。どちらも圧縮機能を備えた列指向形式です。Spark、Databricks、dbt、BigQueryなどのデータツールでは、これらの形式でエクスポートできる場合があります。
Parquet、ORC、CSVの前処理時間はほぼ同じでした。CSV.GZは、gzipファイルを並列解凍のために分割できないため、イベント数が多い場合に前処理時間が長くなりました。
| データセット | Parquet | ORC | CSV | CSV.GZ |
|---|---|---|---|---|
| イベント数100万件 | 55秒 | 55秒 | 55秒 | 55秒 |
| イベント数500万件 | 1.5分 | 1.5分 | 1.5分 | 1.5分 |
| イベント数1,000万件 | 1.5分 | 1.5分 | 1.5分 | 2分 |
| イベント数2,000万件 | 2分 | 2分 | 2分 | 2.5分 |
| イベント数5,000万件 | 2分 | 2分 | 2分 | 3分 |
| イベント数1億件 | 2.5分 | 2.5分 | 2.5分 | 4.5分 |
合計時間は、アップロード時間と前処理時間を合わせたものです。以下の例では、100Mbpsの接続を使用しています。
| イベント数1,000万件(100Mbps) | ファイルサイズ | アップロード | 前処理 | 合計 |
|---|---|---|---|---|
| Parquet | 301MB | 30秒 | 1.5分 | 約2分 |
| ORC | 395MB | 40秒 | 1.5分 | 約2.2分 |
| CSV | 2.2GB | 4分 | 1.5分 | 約5.5分 |
| CSV.GZ | 215MB | 21秒 | 2分 | 約2.5分 |
| イベント数5,000万件(100Mbps) | ファイルサイズ | アップロード | 前処理 | 合計 |
|---|---|---|---|---|
| Parquet | 1.7GB | 3分 | 2分 | 約5分 |
| ORC | 1.9GB | 3.2分 | 2分 | 約5.2分 |
| CSV | 11.1GB | 18分 | 2分 | 約20分 |
| CSV.GZ | 1.1GB | 2分 | 3分 | 約5分 |
大規模なデータセットでは、ParquetやORCはファイルサイズが小さいため、転送時間を短縮できます。小規模なデータセットや、エクスポート機能が列指向形式に対応していない場合は、扱いやすく広く使われているCSVが選択肢になります。CSV.GZは低速な接続で転送時間を短縮できますが、データセットが大きいほど解凍に時間がかかります。
ファイル形式の選び方
- **Parquet:**データ処理の流れが対応している場合、大規模なデータセットに適した標準的な選択肢です。今回のテストでは、最もファイルサイズを小さくできました。
- **ORC:**同様の選択肢で、データ処理の流れにHadoopやSparkを使っている場合に特に適しています。
- **CSV:**シンプルで幅広く対応されています。小規模なデータセットで使いやすい形式です。
- **CSV.GZ:**アップロード速度が主な制約となる場合に検討してください。特にイベント数が多い場合は、実際のデータを使って前処理時間を確認してください。
分析に時間がかかるクエリの特徴
データやダッシュボードの構成によって、処理に必要な時間は異なります。クエリが遅くなる原因を見つける際は、次の点を確認してください。
- **アクティビティが多すぎる:**異なるアクティビティが50個を超えるプロセスフローは、計算に時間がかかり、解釈も難しくなることがあります。適切な場合は、関連するステップをまとめてください。
- **バリアントが多い:**ケースが多様な経路をたどると、バリアントの計算量が増えます。ばらつきが大きい場合、調査すべきプロセスの特徴が見つかることもあります。
- **ケースが長い:**イベント数の多いケースは、短いケースより処理に時間がかかります。
- **不要な列:**属性を追加するとファイルサイズが大きくなり、クエリの処理負荷も増えることがあります。分析に必要な項目に絞ってください。
- **情報を詰め込みすぎたダッシュボード:**各グラフやタイルは個別にクエリを実行します。明確な問いに答えるコンポーネントに絞り、ほかのビューは別のダッシュボードに配置してください。
- **処理負荷の高い可視化:**大規模なデータセットでは、カテゴリー数の多いグラフの描画に時間がかかることがあります。詳細な内訳が不要な場合は、集計ビューを使ってください。
- **アクティブなケースが多いアニメーション:**アニメーションの所要時間は、表示するケース数によって異なります。フローの確認だけが目的なら、速度を下げるか、軌跡や効果をオフにしてください。
適切なデータ量の選び方
まず、調べたいことに答えられる最小限のデータセットから始めてください。対象を絞ると、アップロードが速く、データの検証も容易になります。より広い範囲を調べる場合や、まれなイベント、長期的な傾向を分析する場合は、データを追加してください。
小規模なデータセットで構築・検証
まず直近のサンプルデータを使ってモデルを設定し、データを確認してから規模を拡大してください。
- **サンプルから始める。**たとえば、直近3か月からイベントを100万件抽出します。ベンチマークでは、アップロードに1Gbpsで3秒、100Mbpsで22秒かかり、その後の前処理には55秒かかりました。
- **モデルを構築する。**アクティビティ、フィルター、ビューを設定します。テスト対象となったイベント数100万~1,000万件のデータセットでは、モデルの変更に約14~20秒かかりました。
- **分析結果を検証する。**アクティビティ名やプロセス経路が妥当か確認し、データ品質の問題を解消します。
- **必要に応じてデータを追加する。**まれなケースを調べたり、より長い期間を比較したりする場合は、イベント数を増やしてください。
以下の表は、100Mbpsの接続でイベント数ごとの初回の待ち時間を比較したものです。
| 方法 | アップロード(100Mbps) | 前処理 | 合計待ち時間 | ダッシュボードの応答時間 |
|---|---|---|---|---|
| イベント数100万件から開始 | 22秒 | 55秒 | 約1.5分 | 1~2秒 |
| イベント数500万件から開始 | 2分 | 1.5分 | 約3.5分 | 1~2.5秒 |
| イベント数5,000万件から開始 | 18分 | 2分 | 約20分 | 1~6秒 |
適切なイベント数は、調べたい内容によって異なります。一般的なプロセスのパターンを把握するだけなら、小規模なデータセットで足りる場合があります。一方、まれなイベントを調べる場合や、母集団全体を網羅する必要がある場合は、より多くのデータが必要です。
調査対象に合わせたデータの分割
特定の国、部門、製品ラインを調べる場合は、関係のないグループをまとめず、対象を絞って始めてください。データを分けると比較しやすくなり、処理するデータ量も減らせます。
たとえば、ベンチマークでは、8か国にまたがるイベント数4,200万件の欧州物流データセットを紹介しています。
- 全対象国:イベント数4,200万件、9.3GB。100Mbpsでのアップロードに16分、前処理に2分かかります。
- ドイツ:イベント数850万件、1.9GB。アップロードに3分、前処理に1.5分かかります。
- オランダ:イベント数310万件、690MB。アップロードに1分、前処理に1分かかります。
各セグメントを検証した後で比較できます。地域、組織、製品、期間、顧客セグメントなどの切り口が役立ちます。
必要なケースに絞り込む
例外を調べる場合は、関連するケースだけをエクスポートすると、データセットを大幅に小さくできます。たとえば、ベンチマークでは、発注書120万件、イベント数840万件の調達から支払いまでのプロセスを紹介しています。返品、差し戻し、請求書の重複、承認漏れなどの例外があったのは、注文の9万6,000件、全体の8%と報告されています。
この分析では、例外のあるケースだけをエクスポートすることで、イベント数を840万件から67万件に減らせます。報告されたファイルサイズは1.9GBから150MBに、100Mbpsでのアップロード時間は3分から15秒に短縮されます。同じデータを15MBのParquetファイルとしてエクスポートした場合、ベンチマークではアップロードに2秒もかかりませんでした。
調査内容に合う項目がある場合は、ステータス、アクティビティ、ケースの所要時間、期間、事業部門で絞り込んでください。
必要な列だけを選択
列が増えるほどファイルサイズも大きくなります。長いテキスト項目、重複する識別子、監査項目、技術メタデータは、分析に必要ない場合があります。
ベンチマークでは、発注書イベント180万件、45列を含むSAPのエクスポートデータを紹介しています。必要な12列に絞ると、ファイルサイズは2.1GBから380MBに減りました。さらにParquet形式でエクスポートすると58MBになりました。100Mbpsでのアップロード時間は、報告値で3.5分から6秒に短縮されました。
CaseId、Activity、Timestampに加え、ステータス、金額、カテゴリー、地域など、分析に必要な業務属性を残してください。分析に必要のない個人情報は削除してください。
大規模なデータセットが必要な場合
調査内容によっては、対象範囲や期間を確保するために、イベント数を増やす必要があります。
- **まれなイベント:**10万件に1件の例外を見つけるには、その例外を含むだけの十分な母集団が必要です。発生率が0.01%の例外を50件調べる場合、ケース数は約50万件必要です。
- **発生頻度の低いバリアント:**発生率が0.1%のバリアントは、イベント数100万件のサンプルでは確認できないことがありますが、5,000万件の母集団なら明確に測定できます。
- **コンプライアンスと監査:**要件によっては、サンプルではなく母集団全体を対象にする必要があります。
- **長期的な傾向:**2024年第1四半期、2025年第1四半期、2026年第1四半期を比較するには、3つの期間すべてのデータが必要です。差分読み込みを使えば、必要なデータを段階的に追加できます。
イベント数が5,000万件を超えるデータセットでは、Parquet形式を使い、API経由でアップロードし、可能であれば高速なネットワーク接続を利用する方法がベンチマークで推奨されています。テストに使ったイベント数5,000万件のCSVは11.1GBでしたが、Parquetでは1.7GBでした。
パフォーマンスには常にトレードオフがあり、データ量や速度を増やすにはコストがかかります。考えるべきなのは、ツールで何ができるかではなく、プロセスに何が必要かです。ProcessMindは大規模なデータにも対応しますが、膨大なデータセットが不要な場合も多く、複雑さが増して改善そのものに集中しにくくなるため、必要性を確認することをおすすめしています。
モデルとインターフェースの応答性を保つ方法
データ量だけが要因ではありません。プロセスモデルやダッシュボードの設計も、作業の速さに影響します。
- **モデルを読みやすく保つ:**大規模なプロセスは、モジュール化したSubprocessに分けてください。キャンバスに表示する要素が多いと、描画に時間がかかり、操作もしにくくなります。構造を変更した後は自動レイアウトを使ってください。
- **ダッシュボードのコンポーネントを慎重に選ぶ:**各グラフやタイルで計算が必要です。現在の問いに答えるビューを残してください。
- **データに合ったグラフを使う:**大規模なデータセットでは、カテゴリー数の多い可視化の計算に時間がかかることがあります。詳細な内訳が不要な場合は、集計ビューを使ってください。
- **問いに必要なフィルターに絞る:**フィルターを使うと分析対象を絞り込めます。調べたい内容に関係のないフィルターを組み合わせないでください。
- **アニメーションの設定を調整する:**アクティブなケース数が増えるほど、アニメーションの処理負荷も高くなります。フローの確認だけが目的なら、速度を下げるか、軌跡や効果をオフにしてください。詳しくはプロセスアニメーションをご覧ください。
- **変更箇所だけを再計算する:**モデルを変更すると、前処理全体をやり直すことなく、モデルに依存する計算が更新されます。ベンチマークでは、イベント数100万件で約14秒、1億件で52秒かかりました。
差分読み込みでアップロード時間を短縮する方法
差分読み込みでは、データセット全体を再アップロードせずに、新しいイベントを既存のデータセットに追加できます。イベントログが増えていく場合、更新時に転送するデータ量を減らせます。
| シナリオ | 全件再アップロード | 差分アップロード | 短縮時間 |
|---|---|---|---|
| 既存1,000万件+新規50万件(100Mbps) | アップロード4分 | アップロード5秒 | 約4分 |
| 既存2,000万件+新規200万件(100Mbps) | アップロード7分 | アップロード44秒 | 約6分 |
| 既存5,000万件+新規500万件(100Mbps) | アップロード18分 | アップロード2分 | 約16分 |
差分をアップロードした後は、結合後のデータセットを対象に前処理が再度実行されます。ベンチマークでは1~2.5分かかりました。アップロード時間を短縮できるのは、新しいイベントだけを転送するためです。
差分ファイルには、最初のアップロードと同じファイル形式と列構成を使用してください。詳しくはデータの増分読み込みガイドをご覧ください。
APIアップロードが適している場合
定期的なアップロードや数GBのファイルには、ブラウザー経由の転送よりAPIアップロードが適している場合があります。スクリプトやコマンドラインツールをETLパイプラインに組み込み、アップロードをスケジュールしたり、転送の進行状況を確認したりできます。
ProcessMindでは、クラウドストレージに直接アップロードするための署名付きURLを提供しています。ProcessMindのUIでデータセットの設定メニューを開くと、アップロードURLをコピーできます。
# Upload a Parquet file directly using a presigned URL
curl -X PUT "$PRESIGNED_URL" --upload-file data.parquet署名付きURLの取得方法や差分ファイルのアップロード方法を含む、Bash、JavaScript、Pythonの例については、APIの文書をご覧ください。
データセットを分割する場合
特定の分析にデータの一部だけが必要な場合や、グループごとに分けて比較する場合は、データセットを分割してください。地域、部門、製品ライン、期間、ケースの種類などで分け、それぞれを個別に分析できます。
グループ間の比較や、グループをまたいだプロセス全体の追跡が必要な場合は、データをまとめておいてください。分割する前に、ケースの意味が変わったり、経路の把握に必要なイベントが失われたりしないか確認してください。たとえば期間で分ける場合は、ある期間に始まり、別の期間に完了するケースを考慮する必要があります。
実際のデータでパフォーマンスを確認
ベンチマークは計画の参考になりますが、すべてのイベントログ、ネットワーク、クエリでの結果を予測することはできません。実際に使う予定のデータセットでテストし、アップロード時間、前処理時間、必要なダッシュボードビューの応答時間を確認してください。
イベントログの整え方については、まずデータ準備のガイドをご覧ください。また、プロセスの分析方法とプロセスの継続的なモニタリング方法もご確認いただけます。
実際のデータ量でテスト
分析する予定のイベントログを読み込み、手元のデータでどのように処理されるかを測定します。