Performance do Process Mining: referências e dicas
Veja como o volume de dados, o formato do arquivo e o tipo de consulta afetam a performance do Process Mining, com benchmarks datados que vão de 100 mil a 100 milhões de eventos.
A performance do Process Mining depende de mais do que a quantidade de eventos. O tamanho do arquivo, o número de casos, o formato da consulta e a velocidade da rede influenciam o tempo de espera. Os benchmarks abaixo abrangem conjuntos de dados com 100 mil a 100 milhões de eventos. Os testes foram realizados em uma infraestrutura de produção da AWS em março de 2026, usando os formatos de arquivo e as condições descritos aqui.
Principais conclusões
- O tempo de carregamento pode ser o principal fator de espera em arquivos grandes ou conexões lentas.
- Arquivos Parquet e ORC são bem menores que arquivos CSV brutos, o que reduz o tempo de transferência.
- O tempo de resposta do Dashboard depende da consulta. As estatísticas continuam rápidas, enquanto os fluxos de processo demoram mais à medida que aumenta o número de eventos.
- O carregamento incremental transfere novos eventos sem exigir que você carregue o conjunto de dados completo novamente.
- Um conjunto de dados mais focado pode ser carregado mais rapidamente e facilitar a análise.
O que influencia a performance do process mining?
Quatro fatores influenciam a performance: o volume de dados, a estrutura do Event Log, a consulta executada e o ambiente usado para transferir e processar os dados.
- Número de eventos e de casos: Em geral, mais eventos significam mais dados para carregar e processar. O número de casos determina quantas instâncias do processo entram na análise.
- Formato da consulta: Uma estatística resumida e um fluxo de processo exigem cálculos diferentes. Consultas que calculam transições entre atividades podem demorar mais que consultas sobre dados pré-agregados.
- Número de atividades e duração dos casos: Mais atividades distintas e casos mais longos aumentam o trabalho necessário para calcular fluxos e variantes.
- Tamanho do arquivo e velocidade da rede: Esses fatores determinam o tempo de upload. Um arquivo CSV com muitas colunas e campos de texto longos pode ser muito maior que um arquivo colunar compacto com os mesmos eventos.
O número de eventos, por si só, não permite prever quanto tempo o processamento de um conjunto de dados vai levar. Use os benchmarks como referência e teste o Event Log e as consultas que pretende usar. Essa é a forma mais útil de analisar a performance do process mining no seu ambiente.
O fluxo de dados: onde o tempo é gasto?
Um conjunto de dados passa por três etapas: upload, pré-processamento e recálculo quando você altera o modelo de processo.
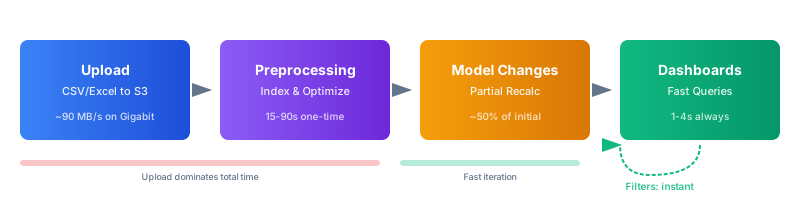
- Upload: Seu arquivo é transferido pela internet para a infraestrutura em nuvem da ProcessMind. A velocidade da rede e o tamanho do arquivo determinam o tempo de transferência. Por exemplo, um arquivo CSV de 11 GB com 50 milhões de eventos leva cerca de 2 minutos a 1 Gbps, 18 minutos a 100 Mbps ou mais de 3 horas a 10 Mbps. Os mesmos dados em um arquivo Parquet de 1,7 GB levam cerca de 19 segundos, 3 minutos ou 28 minutos nessas velocidades.
- Pré-processamento: Depois do upload, o sistema converte os dados em um armazenamento colunar otimizado, indexa os eventos, calcula as transições entre atividades e as variantes do processo e gera estatísticas resumidas. Nos benchmarks abaixo, essa etapa leva 35 segundos para 100 mil eventos e até 2,5 minutos para 100 milhões de eventos.
- Alterações no modelo: Quando você altera o mapeamento de atividades ou adiciona ou remove atividades, a ProcessMind atualiza os cálculos que dependem do modelo. Nos benchmarks abaixo, isso leva cerca de 14 segundos para 1 milhão de eventos e 52 segundos para 100 milhões de eventos. As alterações nos filtros são instantâneas.
Em conjuntos de dados grandes, reduzir o tamanho do arquivo costuma ser a maneira mais eficaz de diminuir a espera inicial. Depois do pré-processamento, a performance das consultas depende dos cálculos necessários para o seu Dashboard.
Como varia a performance das consultas?
Cada consulta tem um custo diferente. Estas características ajudam a entender o que esperar e como estruturar seus dados.
- Número de atividades: Modelos com 10 a 20 atividades distintas são mais fáceis de analisar e exibir. Acima de 50 atividades, os fluxos de processo demoram mais para calcular e podem ficar mais difíceis de interpretar. Agrupe etapas relacionadas quando isso representar o processo com precisão.
- Diversidade de variantes: Em geral, é mais rápido analisar um processo em que a maioria dos casos segue poucos caminhos do que um em que cada caso segue um caminho diferente. Uma variação alta pode ser relevante, mas também pode aumentar o tempo das consultas.
- Número de colunas: Os campos básicos CaseId, Activity e Timestamp são necessários para a análise do processo. Atributos adicionais ajudam a filtrar e categorizar, mas aumentam o volume de dados a transferir e consultar.
- Duração dos casos: Um caso com 50 eventos exige mais processamento que um com 5. Consultas sobre processos com casos de centenas de eventos podem demorar mais.
Tempos de resposta do Dashboard
Estas medianas foram calculadas com base em várias execuções de benchmark. Cada componente do Dashboard executa sua consulta de forma independente e carrega em paralelo.
| Conjunto de dados | Estatísticas | Fluxo do processo | Variantes | Categorias | Navegador de dados | Animação |
|---|---|---|---|---|---|---|
| 100 mil | 0,6s | 1,5s | 1,1s | 1,5s | 1,2s | 1,4s |
| 1 milhão | 0,6s | 1,6s | 1,4s | 1,9s | 1,5s | 2,0s |
| 5 milhões | 0,6s | 2,5s | 1,8s | 2,4s | 1,3s | 2,1s |
| 10 milhões | 0,6s | 3,4s | 2,2s | 2,5s | 1,6s | 2,4s |
| 20 milhões | 0,6s | 3,9s | 2,7s | 3,3s | 1,9s | 3,6s |
| 50 milhões | 0,6s | 5,1s | 4,2s | 5,7s | 1,6s | 2,7s |
| 100 milhões | 0,6s | 7,2s | 3,5s | 4,7s | 1,6s | 5,0s |
As estatísticas ficaram em torno de 0,6 segundo em todos os tamanhos testados. O Fluxo do processo demorou mais à medida que o número de eventos aumentou, pois calcula as transições entre atividades. Variantes e Categorias tiveram um aumento moderado no tempo, enquanto o Navegador de dados manteve a agilidade com a paginação. O tempo da Animação variou conforme o número de casos ativos exibidos.
Entre 1 milhão e 10 milhões de eventos, os tempos de resposta medidos variaram de 0,6 a 3,4 segundos, dependendo do componente. Com 50 milhões de eventos, o Fluxo do processo e as Categorias levaram cerca de 5 a 6 segundos. Esses são resultados de benchmark, não uma garantia para todos os conjuntos de dados ou ambientes.
Dados do benchmark: quais foram as condições do teste?
Os benchmarks foram executados na infraestrutura de produção da AWS em março de 2026. Os tempos de upload e pré-processamento são médias de várias execuções de teste. Os tempos de resposta do Dashboard são medianas de várias execuções. O teste abrangeu mais de 50 tipos de consulta para cada tamanho de conjunto de dados.
Os números de eventos abaixo correspondem às quantidades reais nos arquivos de teste. Os tamanhos dos arquivos são de CSV sem compactação, com um esquema típico de Event Log: CaseId, Activity, Timestamp e de 5 a 8 atributos de negócio. O tamanho do seu arquivo e os resultados podem variar conforme o número de colunas, o conteúdo, as condições da rede, a distância até o data center e a carga atual.
Tempos de upload e pré-processamento
| Conjunto de dados | Eventos reais | Tamanho do arquivo | Upload (1 Gbps) | Upload (100 Mbps) | Upload (50 Mbps) | Upload (10 Mbps) | Pré-processamento |
|---|---|---|---|---|---|---|---|
| 100 mil | 125.260 | 22 MB | < 1s | 2s | 4s | 22s | 35s |
| 500 mil | 626.300 | 110 MB | 1s | 11s | 22s | 2 min | 45s |
| 1 milhão | 1.253.424 | 221 MB | 3s | 22s | 44s | 4 min | 55s |
| 2 milhões | 2.506.848 | 443 MB | 5s | 44s | 1,5 min | 7 min | 1 min |
| 5 milhões | 4.996.877 | 1,1 GB | 13s | 2 min | 4 min | 18 min | 1,5 min |
| 10 milhões | 12.511.867 | 2,2 GB | 25s | 4 min | 7 min | 37 min | 1,5 min |
| 20 milhões | 25.023.734 | 4,4 GB | 50s | 7 min | 15 min | 1,2 h | 2 min |
| 50 milhões | 62.559.335 | 11,1 GB | 2 min | 18 min | 37 min | 3 h | 2 min |
| 100 milhões | 125.118.670 | 22,3 GB | 4 min | 37 min | 1,2 h | 6 h | 2,5 min |
A taxa de transferência medida a 1 Gbps foi de 88 MB/s para a AWS eu-central-1. As demais velocidades são estimativas baseadas em taxas práticas de transferência: cerca de 5 MB/s a 50 Mbps, 10 MB/s a 100 Mbps e 1 MB/s a 10 Mbps. A taxa real depende da sua rede e das condições de conexão.
Neste teste, o pré-processamento levou de 35 segundos a 2,5 minutos. O tempo de upload aumentou com o tamanho do arquivo e se tornou a maior parte da espera para arquivos grandes.
Formato de arquivo: Parquet e ORC em comparação com CSV
A ProcessMind aceita CSV, Parquet, ORC, Excel e XES. Esta comparação de tamanho de arquivo usa os mesmos números de eventos e o mesmo esquema do benchmark acima.
| Conjunto de dados | CSV | Parquet | ORC | CSV.GZ |
|---|---|---|---|---|
| 1 milhão de eventos | 221 MB | 34 MB | 39 MB | 20 MB |
| 5 milhões de eventos | 1,1 GB | 151 MB | 197 MB | 107 MB |
| 10 milhões de eventos | 2,2 GB | 301 MB | 395 MB | 215 MB |
| 20 milhões de eventos | 4,4 GB | 603 MB | 791 MB | 430 MB |
| 50 milhões de eventos | 11,1 GB | 1,7 GB | 1,9 GB | 1,1 GB |
| 100 milhões de eventos | 22,3 GB | 3,4 GB | 3,7 GB | 2,2 GB |
Nestes testes, os arquivos Parquet foram cerca de 85% menores que os CSV, e os arquivos ORC, cerca de 82% menores. Ambos são formatos colunares com compactação integrada. Ferramentas de dados como Spark, Databricks, dbt e BigQuery podem aceitar a exportação para esses formatos.
Os tempos de pré-processamento foram semelhantes para Parquet, ORC e CSV. O CSV.GZ demorou mais com números maiores de eventos, pois os arquivos gzip não podem ser divididos para descompactação em paralelo.
| Conjunto de dados | Parquet | ORC | CSV | CSV.GZ |
|---|---|---|---|---|
| 1 milhão de eventos | 55s | 55s | 55s | 55s |
| 5 milhões de eventos | 1,5 min | 1,5 min | 1,5 min | 1,5 min |
| 10 milhões de eventos | 1,5 min | 1,5 min | 1,5 min | 2 min |
| 20 milhões de eventos | 2 min | 2 min | 2 min | 2,5 min |
| 50 milhões de eventos | 2 min | 2 min | 2 min | 3 min |
| 100 milhões de eventos | 2,5 min | 2,5 min | 2,5 min | 4,5 min |
O tempo total soma o upload e o pré-processamento. Estes exemplos consideram uma conexão de 100 Mbps.
| 10 milhões de eventos (100 Mbps) | Tamanho do arquivo | Upload | Pré-processamento | Total |
|---|---|---|---|---|
| Parquet | 301 MB | 30s | 1,5 min | ~2 min |
| ORC | 395 MB | 40s | 1,5 min | ~2,2 min |
| CSV | 2,2 GB | 4 min | 1,5 min | ~5,5 min |
| CSV.GZ | 215 MB | 21s | 2 min | ~2,5 min |
| 50 milhões de eventos (100 Mbps) | Tamanho do arquivo | Upload | Pré-processamento | Total |
|---|---|---|---|---|
| Parquet | 1,7 GB | 3 min | 2 min | ~5 min |
| ORC | 1,9 GB | 3,2 min | 2 min | ~5,2 min |
| CSV | 11,1 GB | 18 min | 2 min | ~20 min |
| CSV.GZ | 1,1 GB | 2 min | 3 min | ~5 min |
Em conjuntos de dados grandes, Parquet e ORC reduzem o tempo de transferência porque geram arquivos menores. O CSV continua sendo uma opção simples para conjuntos menores ou quando o processo de exportação não aceita formatos colunares. O CSV.GZ pode reduzir o tempo de transferência em conexões lentas, mas o custo de descompactação aumenta com o tamanho do conjunto de dados.
Como escolher um formato de arquivo
- Parquet: Uma boa opção padrão para conjuntos de dados grandes quando o fluxo de dados aceita esse formato. Nos testes, gerou os menores arquivos.
- ORC: Uma opção semelhante, especialmente se o fluxo de dados usa Hadoop ou Spark.
- CSV: Simples e amplamente aceito. Pode ser uma opção prática para conjuntos de dados menores.
- CSV.GZ: Considere esse formato quando a velocidade de upload for o principal limitador. Teste o tempo de pré-processamento com seus próprios dados, especialmente quando houver muitos eventos.
Quais padrões de consulta podem deixar a análise mais lenta?
Alguns padrões de dados e de Dashboard exigem mais processamento que outros. Use estas verificações para identificar possíveis causas de consultas mais lentas.
- Atividades demais: Um fluxo de processo com mais de 50 atividades distintas pode demorar mais para ser calculado e ser difícil de interpretar. Agrupe etapas relacionadas quando fizer sentido.
- Muitas variantes diferentes: Quando os casos seguem muitos caminhos diferentes, o cálculo das variantes exige mais processamento. Uma variação alta também pode indicar comportamentos do processo que vale a pena investigar.
- Casos longos: Casos com muitos eventos exigem mais processamento que casos curtos.
- Colunas desnecessárias: Atributos extras aumentam o tamanho do arquivo e podem exigir mais processamento nas consultas. Mantenha os campos que contribuem para a análise.
- Dashboards grandes e carregados: Cada gráfico ou bloco executa sua própria consulta. Mantenha os componentes que respondem a uma pergunta clara e coloque as demais visualizações em outro Dashboard.
- Visualizações que exigem muito processamento: Em conjuntos de dados grandes, gráficos com muitas categorias podem demorar mais para carregar. Use uma visão resumida quando não precisar de uma análise detalhada.
- Animação com muitos casos ativos: O tempo da animação depende do número de casos exibidos. Reduza a velocidade ou desative os rastros e efeitos se quiser apenas inspecionar o fluxo.
Como escolher o tamanho certo do conjunto de dados?
Comece pelo menor conjunto de dados capaz de responder à sua pergunta. Um conjunto mais focado é carregado mais rapidamente e facilita a validação. Amplie-o quando precisar de uma cobertura maior, de eventos raros ou de tendências de longo prazo.
Desenvolva e valide com um conjunto de dados menor
Comece com uma amostra recente, configure seu modelo e confira os dados antes de ampliar o conjunto.
- Comece com uma amostra. Por exemplo, extraia 1 milhão de eventos de um período recente de três meses. No benchmark, o upload levou 3 segundos a 1 Gbps ou 22 segundos a 100 Mbps, seguido de 55 segundos de pré-processamento.
- Monte seu modelo. Configure atividades, filtros e visualizações. Nos conjuntos de dados testados, com 1 milhão a 10 milhões de eventos, as alterações no modelo levaram cerca de 14 a 20 segundos.
- Valide os resultados. Confira se os nomes das atividades e os caminhos do processo fazem sentido e resolva problemas de qualidade dos dados.
- Adicione mais dados, se necessário. Aumente o número de eventos quando precisar investigar casos raros ou comparar períodos mais longos.
A tabela compara a espera inicial para diferentes números de eventos em uma conexão de 100 Mbps.
| Estratégia | Upload (100 Mbps) | Pré-processamento | Espera total | Velocidade do Dashboard |
|---|---|---|---|---|
| Começar com 1 milhão de eventos | 22s | 55s | ~1,5 min | 1–2s |
| Começar com 5 milhões de eventos | 2 min | 1,5 min | ~3,5 min | 1–2,5s |
| Começar com 50 milhões de eventos | 18 min | 2 min | ~20 min | 1–6s |
O número ideal de eventos depende da sua pergunta. Um conjunto de dados menor pode ser suficiente para identificar padrões comuns do processo, mas talvez você precise de mais dados para estudar eventos raros ou atender a um requisito de cobertura completa da população.
Segmente os dados quando a pergunta for específica
Se você estiver investigando um país, departamento ou linha de produtos, comece por esse segmento em vez de combinar grupos sem relação entre si. A segmentação pode facilitar as comparações e reduzir o volume de dados que você precisa processar.
Por exemplo, o benchmark descreve um conjunto de dados de logística europeu com 42 milhões de eventos de remessa em 8 países:
- Todos os países: 42 milhões de eventos, 9,3 GB, 16 minutos de upload a 100 Mbps e 2 minutos de pré-processamento.
- Alemanha: 8,5 milhões de eventos, 1,9 GB, 3 minutos de upload e 1,5 minuto de pré-processamento.
- Países Baixos: 3,1 milhões de eventos, 690 MB, 1 minuto de upload e 1 minuto de pré-processamento.
Você pode comparar os segmentos depois de validar cada um. Entre as dimensões úteis estão a região, a organização, o produto, o período e o segmento de clientes.
Filtre os casos necessários
Se você estiver investigando exceções, exportar apenas os casos relevantes pode reduzir bastante o conjunto de dados. Por exemplo, o benchmark descreve um processo de compras a pagamentos com 1,2 milhão de pedidos de compra e 8,4 milhões de eventos. Segundo o relatório, 96 mil pedidos, ou 8%, tiveram exceções como rejeições, devoluções, faturas duplicadas ou aprovações pendentes.
Nessa análise, exportar os casos com exceções reduz o conjunto de dados de 8,4 milhões para 670 mil eventos. O tamanho informado do arquivo cai de 1,9 GB para 150 MB, e o tempo de upload a 100 Mbps passa de 3 minutos para 15 segundos. No benchmark, o upload dos mesmos dados em um arquivo Parquet de 15 MB leva menos de 2 segundos.
Filtre por status, atividade, duração do caso, período ou unidade de negócio quando esses campos forem relevantes para a pergunta investigada.
Selecione apenas as colunas necessárias
Cada coluna contribui para o tamanho do arquivo. Campos de texto longos, identificadores redundantes, campos de auditoria e metadados técnicos podem não ser úteis para sua análise.
O benchmark descreve uma exportação do SAP com 1,8 milhão de eventos de pedidos de compra e 45 colunas. Ao reduzir o arquivo para 12 colunas essenciais, o tamanho caiu de 2,1 GB para 380 MB. A exportação dessas colunas em Parquet reduziu o arquivo para 58 MB. O tempo de upload informado a 100 Mbps caiu de 3,5 minutos para 6 segundos.
Mantenha os campos que contribuem para sua análise, como CaseId, Activity, Timestamp e atributos de negócio relevantes, por exemplo, status, valor, categoria ou região. Remova informações pessoais quando elas não forem necessárias para a análise.
Quando usar um conjunto de dados maior?
Talvez seja necessário trabalhar com mais eventos quando sua pergunta depender da cobertura ou do período analisado.
- Eventos raros: Para encontrar exceções que ocorrem uma vez a cada 100 mil casos, você precisa de uma população grande o suficiente para incluí-las. Se uma exceção ocorrer em 0,01% dos casos e você quiser estudar 50 ocorrências, precisará de cerca de 500 mil casos.
- Variantes pouco frequentes: Variantes que ocorrem em 0,1% dos casos podem passar despercebidas em uma amostra de 1 milhão de eventos e ser claramente identificáveis em uma população de 50 milhões.
- Conformidade e auditoria: Alguns requisitos exigem a cobertura completa da população, em vez de uma amostra.
- Tendências de longo prazo: Para comparar o primeiro trimestre de 2024 com o primeiro trimestre de 2025 e o primeiro trimestre de 2026, você precisa de dados dos três períodos. O carregamento incremental permite ampliar essa cobertura aos poucos.
Para conjuntos de dados com mais de 50 milhões de eventos, o benchmark recomenda usar Parquet, fazer o upload pela API e, quando possível, usar uma conexão de rede rápida. No teste, o arquivo CSV com 50 milhões de eventos tinha 11,1 GB, em comparação com 1,7 GB no formato Parquet.
A performance sempre envolve uma troca: mais dados e mais velocidade custam mais. A questão não é o que uma ferramenta consegue fazer, mas do que seu processo precisa. A ProcessMind comporta volumes grandes, mas ainda recomendamos evitar conjuntos de dados enormes, pois muitas vezes eles são desnecessários e acrescentam complexidade que pode tirar o foco da melhoria em si.
Como manter o modelo e a interface ágeis?
O volume de dados é apenas parte da questão. O modelo de processo e o design do Dashboard também afetam a agilidade do seu trabalho.
- Mantenha o modelo legível: Divida processos grandes em Subprocessos modulares. Uma tela com muitos elementos visíveis pode demorar mais para carregar e ser mais difícil de navegar. Use auto-layout depois de alterações estruturais.
- Escolha os componentes do Dashboard com cuidado: Cada gráfico e bloco exige um cálculo. Mantenha as visualizações que respondem às perguntas atuais.
- Use gráficos adequados aos dados: Em conjuntos de dados grandes, uma visualização com muitas categorias pode demorar mais para ser calculada. Use um resumo quando não precisar de uma análise detalhada.
- Limite os filtros à pergunta: Os filtros ajudam a direcionar a análise. Evite combinar filtros que não contribuem para responder à pergunta.
- Ajuste as configurações da animação: O processamento da animação aumenta com o número de casos ativos. Reduza a velocidade ou desative os rastros e efeitos quando quiser apenas inspecionar o fluxo. Consulte Animação do processo.
- Recalcule apenas o que mudou: As alterações no modelo atualizam os cálculos que dependem dele sem repetir todo o pré-processamento. No benchmark, as alterações levaram de cerca de 14 segundos para 1 milhão de eventos a 52 segundos para 100 milhões de eventos.
Como o carregamento incremental reduz o tempo de upload?
O carregamento incremental permite adicionar novos eventos a um conjunto de dados existente, sem carregar o conjunto completo novamente. Assim, você transfere menos dados ao atualizar um Event Log que continua crescendo.
| Cenário | Upload completo novamente | Upload incremental | Tempo economizado |
|---|---|---|---|
| Base de 10 milhões + 500 mil novos eventos (100 Mbps) | 4 min de upload | 5s de upload | ~4 min |
| Base de 20 milhões + 2 milhões de novos eventos (100 Mbps) | 7 min de upload | 44s de upload | ~6 min |
| Base de 50 milhões + 5 milhões de novos eventos (100 Mbps) | 18 min de upload | 2 min de upload | ~16 min |
Depois de um upload incremental, o pré-processamento é executado novamente no conjunto de dados combinado. No benchmark, essa etapa levou de 1 a 2,5 minutos. A economia no upload vem da transferência apenas dos novos eventos.
O arquivo incremental precisa usar o mesmo formato e a mesma estrutura de colunas do upload original. Consulte o guia de carregamento incremental de dados para saber mais.
Quando usar o upload pela API?
Para uploads recorrentes ou arquivos de vários gigabytes, pode ser mais fácil gerenciar o upload pela API do que transferir os dados pelo navegador. Um script ou uma ferramenta de linha de comando pode ser integrado a um fluxo de ETL, permitir uploads programados e mostrar o andamento da transferência.
A ProcessMind fornece URLs pré-assinadas para uploads diretos no armazenamento em nuvem. Você pode copiar a URL de upload no menu de configurações do conjunto de dados na interface da ProcessMind.
# Upload a Parquet file directly using a presigned URL
curl -X PUT "$PRESIGNED_URL" --upload-file data.parquet
Consulte a documentação da API para ver exemplos em Bash, JavaScript e Python, incluindo como obter URLs pré-assinadas e carregar arquivos incrementais.
Quando dividir um conjunto de dados?
Divida um conjunto de dados quando uma análise específica exigir apenas parte dos dados ou quando grupos diferentes precisarem ser comparados separadamente. Você pode segmentar por região, departamento, linha de produtos, período ou tipo de caso e, depois, analisar cada conjunto de dados individualmente.
Mantenha os dados juntos quando sua pergunta depender da comparação entre grupos ou do acompanhamento de todo o processo. Antes de dividir, confira se isso muda o significado do caso ou remove eventos necessários para entender seu caminho. Por exemplo, uma divisão por período deve considerar os casos que começam em um período e terminam em outro.
Teste a performance com seus próprios dados
Os benchmarks ajudam no planejamento, mas não permitem prever os resultados de todos os Event Logs, redes ou consultas. Teste o conjunto de dados que pretende usar e confira o tempo de upload, o tempo de pré-processamento e os tempos de resposta das visualizações do Dashboard mais importantes para você.
Leia primeiro as orientações para preparar os dados se precisar de ajuda para estruturar seu Event Log. Você também pode consultar como analisar seu processo e como monitorar seu processo continuamente.