Performances du Process Mining : repères et conseils
Découvrez l’effet du volume de données, du format des fichiers et de la structure des requêtes sur les performances du Process Mining, à travers des tests datés portant sur 100 000 à 100 millions d’événements.

Les performances du Process Mining ne dépendent pas uniquement du nombre d’événements. La taille des fichiers, le nombre de dossiers, la forme des requêtes et le débit du réseau influent aussi sur le temps d’attente. Les tests ci-dessous portent sur des jeux de données de 100 000 à 100 millions d’événements. Ils ont été réalisés en mars 2026 sur une infrastructure AWS de production, avec les formats de fichiers et les conditions de test décrits ici.
À retenir
- Pour les fichiers volumineux ou les connexions lentes, le temps d’import peut représenter l’essentiel de l’attente.
- Les fichiers Parquet et ORC sont bien plus légers que les fichiers CSV bruts, ce qui réduit le temps de transfert.
- Le temps de réponse des Dashboards dépend de la requête. Les statistiques s’affichent rapidement, tandis que les flux de processus prennent plus de temps à mesure que le nombre d’événements augmente.
- Le chargement Delta transfère les nouveaux événements sans vous obliger à importer de nouveau l’ensemble du jeu de données.
- Un jeu de données ciblé peut être plus rapide à importer et plus facile à analyser.
Quels facteurs influent sur les performances du Process Mining ?
Quatre facteurs déterminent les performances : le volume de données, la structure du journal d’événements, la requête exécutée et l’environnement utilisé pour le transfert et le traitement.
- Nombre d’événements et de cas : En règle générale, plus le nombre d’événements est élevé, plus le volume de données à importer et à traiter augmente. Le nombre de cas détermine combien d’instances de processus votre analyse couvre.
- Type de requête : Une statistique récapitulative et un flux de processus ne nécessitent pas les mêmes calculs. Les requêtes qui calculent les transitions entre les activités peuvent prendre plus de temps que celles qui portent sur des données déjà agrégées.
- Nombre d’activités et longueur des cas : Un plus grand nombre d’activités distinctes et des cas plus longs demandent davantage de calculs pour établir les flux et les variantes.
- Taille du fichier et débit réseau : Ces facteurs déterminent le temps d’importation. Un fichier CSV volumineux comportant de longs champs texte peut être bien plus lourd qu’un fichier compact en colonnes contenant les mêmes événements.
Le nombre d’événements ne suffit pas à prévoir le temps de traitement d’un jeu de données. Servez-vous des résultats de référence pour vous orienter, puis testez le journal d’événements et les requêtes que vous comptez utiliser. C’est la meilleure façon d’évaluer les performances du Process Mining dans votre environnement.
Le pipeline de données : où passe le temps ?
Un jeu de données passe par trois étapes : l’importation, le prétraitement et le recalcul lorsque vous modifiez le modèle de processus.
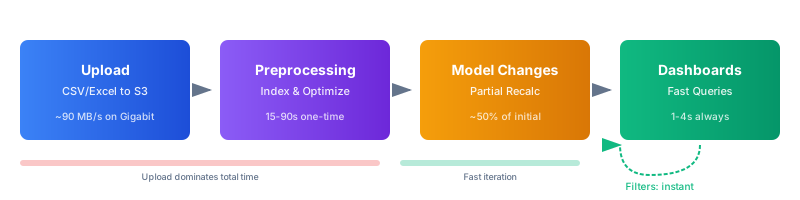
- Importation : Votre fichier transite par Internet jusqu’à l’infrastructure cloud de ProcessMind. Le débit réseau et la taille du fichier déterminent le temps de transfert. Par exemple, un fichier CSV de 50 millions d’événements pesant 11 Go prend environ 2 minutes à 1 Gbit/s, 18 minutes à 100 Mbit/s et plus de 3 heures à 10 Mbit/s. Les mêmes données dans un fichier Parquet de 1,7 Go prennent environ 19 secondes, 3 minutes ou 28 minutes à ces débits.
- Prétraitement : Après l’importation, le système convertit les données en un stockage en colonnes optimisé, indexe les événements, calcule les transitions entre les activités et les variantes de processus, puis génère des statistiques récapitulatives. Dans les tests de référence ci-dessous, cette étape prend 35 secondes pour 100 000 événements et jusqu’à 2,5 minutes pour 100 millions d’événements.
- Modifications du modèle : Lorsque vous modifiez les associations d’activités ou ajoutez ou supprimez des activités, ProcessMind met à jour les calculs liés au modèle. Dans les tests de référence ci-dessous, cette étape prend environ 14 secondes pour 1 million d’événements et 52 secondes pour 100 millions d’événements. Les modifications des filtres sont instantanées.
Pour les grands jeux de données, réduire la taille du fichier est souvent le moyen le plus efficace de raccourcir l’attente initiale. Une fois le prétraitement terminé, les performances des requêtes dépendent des calculs nécessaires à votre Dashboard.
Comment les performances des requêtes varient-elles ?
Les requêtes n’ont pas toutes le même coût de calcul. Les caractéristiques suivantes vous aideront à comprendre à quoi vous attendre et comment préparer vos données.
- Nombre d’activités : Les modèles comportant 10 à 20 activités distinctes sont plus faciles à analyser et à afficher. Au-delà de 50 activités, le calcul des flux de processus prend plus de temps et les résultats peuvent être plus difficiles à lire. Regroupez les étapes apparentées lorsque cela reflète fidèlement le processus.
- Diversité des variantes : Un processus où la plupart des cas suivent un petit nombre de chemins est généralement plus rapide à analyser qu’un processus où chaque cas suit un chemin différent. Une forte variation peut être significative, mais elle risque d’allonger le temps de requête.
- Nombre de colonnes : Les champs essentiels, CaseId, Activity et Timestamp, sont nécessaires à l’analyse des processus. Les attributs supplémentaires permettent de filtrer et de catégoriser les données, mais augmentent le volume à transférer et à parcourir.
- Longueur des cas : Un cas comportant 50 événements demande plus de calculs qu’un cas en comportant 5. Les requêtes peuvent prendre plus de temps pour les processus dont les cas s’étendent sur des centaines d’événements.
Temps de réponse du Dashboard
Ces valeurs médianes proviennent de plusieurs tests de référence. Chaque composant du Dashboard exécute sa propre requête et se charge en parallèle.
| Jeu de données | Statistiques | Flux de processus | Variantes | Catégories | Explorateur de données | Animation |
|---|---|---|---|---|---|---|
| 100 000 | 0,6 s | 1,5 s | 1,1 s | 1,5 s | 1,2 s | 1,4 s |
| 1 million | 0,6 s | 1,6 s | 1,4 s | 1,9 s | 1,5 s | 2,0 s |
| 5 millions | 0,6 s | 2,5 s | 1,8 s | 2,4 s | 1,3 s | 2,1 s |
| 10 millions | 0,6 s | 3,4 s | 2,2 s | 2,5 s | 1,6 s | 2,4 s |
| 20 millions | 0,6 s | 3,9 s | 2,7 s | 3,3 s | 1,9 s | 3,6 s |
| 50 millions | 0,6 s | 5,1 s | 4,2 s | 5,7 s | 1,6 s | 2,7 s |
| 100 millions | 0,6 s | 7,2 s | 3,5 s | 4,7 s | 1,6 s | 5,0 s |
Les statistiques sont restées autour de 0,6 seconde pour toutes les tailles testées. Le calcul du flux de processus a pris plus de temps à mesure que le nombre d’événements augmentait, car il détermine les transitions entre les activités. Les variantes et les catégories ont évolué de façon modérée, tandis que l’explorateur de données est resté réactif grâce à la pagination. Le temps d’animation variait selon le nombre de cas actifs affichés.
Pour un volume de 1 à 10 millions d’événements, les temps de réponse mesurés allaient de 0,6 à 3,4 secondes, selon le composant. À 50 millions d’événements, le flux de processus et les catégories prenaient environ 5 à 6 secondes. Ces résultats proviennent de tests de référence et ne garantissent pas les mêmes performances pour tous les jeux de données ou environnements.
Données de référence : dans quelles conditions les tests ont-ils été réalisés ?
Ces tests de référence ont été réalisés sur l’infrastructure AWS de production en mars 2026. Les temps d’importation et de prétraitement correspondent à des moyennes calculées sur plusieurs essais. Les temps de réponse du Dashboard sont des médianes obtenues sur plusieurs essais. Les tests ont porté sur plus de 50 types de requêtes pour chaque taille de jeu de données.
Les nombres d’événements ci-dessous correspondent aux quantités réelles présentes dans les fichiers de test. Les tailles indiquées sont celles de fichiers CSV non compressés, avec un schéma de journal d’événements courant : CaseId, Activity, Timestamp et 5 à 8 attributs métier. La taille de votre fichier et les résultats varieront selon le nombre de colonnes, leur contenu, les conditions réseau, la distance au centre de données et la charge du système.
Temps d’importation et de prétraitement
| Jeu de données | Événements réels | Taille du fichier | Importation (1 Gbit/s) | Importation (100 Mbit/s) | Importation (50 Mbit/s) | Importation (10 Mbit/s) | Prétraitement |
|---|---|---|---|---|---|---|---|
| 100 000 | 125 260 | 22 Mo | < 1 s | 2 s | 4 s | 22 s | 35 s |
| 500 000 | 626 300 | 110 Mo | 1 s | 11 s | 22 s | 2 min | 45 s |
| 1 million | 1 253 424 | 221 Mo | 3 s | 22 s | 44 s | 4 min | 55 s |
| 2 millions | 2 506 848 | 443 Mo | 5 s | 44 s | 1,5 min | 7 min | 1 min |
| 5 millions | 4 996 877 | 1,1 Go | 13 s | 2 min | 4 min | 18 min | 1,5 min |
| 10 millions | 12 511 867 | 2,2 Go | 25 s | 4 min | 7 min | 37 min | 1,5 min |
| 20 millions | 25 023 734 | 4,4 Go | 50 s | 7 min | 15 min | 1,2 h | 2 min |
| 50 millions | 62 559 335 | 11,1 Go | 2 min | 18 min | 37 min | 3 h | 2 min |
| 100 millions | 125 118 670 | 22,3 Go | 4 min | 37 min | 1,2 h | 6 h | 2,5 min |
Le débit mesuré à 1 Gbit/s était de 88 Mo/s vers AWS eu-central-1. Les autres débits sont extrapolés à partir de débits pratiques : environ 5 Mo/s à 50 Mbit/s, 10 Mo/s à 100 Mbit/s et 1 Mo/s à 10 Mbit/s. Le débit réel dépend de votre réseau et des conditions de transfert.
Dans ce test, le prétraitement a pris entre 35 secondes et 2,5 minutes. Le temps d’importation augmentait avec la taille du fichier et représentait la plus grande partie de l’attente pour les fichiers volumineux.
Formats de fichier : Parquet et ORC face au CSV
ProcessMind prend en charge les formats CSV, Parquet, ORC, Excel et XES. Cette comparaison des tailles de fichiers porte sur les mêmes nombres d’événements et le même schéma que le test de référence ci-dessus.
| Jeu de données | CSV | Parquet | ORC | CSV.GZ |
|---|---|---|---|---|
| 1 million d’événements | 221 Mo | 34 Mo | 39 Mo | 20 Mo |
| 5 millions d’événements | 1,1 Go | 151 Mo | 197 Mo | 107 Mo |
| 10 millions d’événements | 2,2 Go | 301 Mo | 395 Mo | 215 Mo |
| 20 millions d’événements | 4,4 Go | 603 Mo | 791 Mo | 430 Mo |
| 50 millions d’événements | 11,1 Go | 1,7 Go | 1,9 Go | 1,1 Go |
| 100 millions d’événements | 22,3 Go | 3,4 Go | 3,7 Go | 2,2 Go |
Dans ces tests, les fichiers Parquet étaient environ 85 % plus légers que les fichiers CSV, et les fichiers ORC, environ 82 % plus légers. Ces deux formats en colonnes intègrent la compression. Des outils de traitement des données comme Spark, Databricks, dbt et BigQuery peuvent permettre l’export dans ces formats.
Les temps de prétraitement étaient similaires pour Parquet, ORC et CSV. Le traitement des fichiers CSV.GZ prenait plus de temps lorsque le nombre d’événements augmentait, car les fichiers gzip ne peuvent pas être divisés pour une décompression parallèle.
| Jeu de données | Parquet | ORC | CSV | CSV.GZ |
|---|---|---|---|---|
| 1 million d’événements | 55 s | 55 s | 55 s | 55 s |
| 5 millions d’événements | 1,5 min | 1,5 min | 1,5 min | 1,5 min |
| 10 millions d’événements | 1,5 min | 1,5 min | 1,5 min | 2 min |
| 20 millions d’événements | 2 min | 2 min | 2 min | 2,5 min |
| 50 millions d’événements | 2 min | 2 min | 2 min | 3 min |
| 100 millions d’événements | 2,5 min | 2,5 min | 2,5 min | 4,5 min |
Le temps total comprend l’importation et le prétraitement. Ces exemples sont basés sur une connexion de 100 Mbit/s.
| 10 millions d’événements (100 Mbit/s) | Taille du fichier | Importation | Prétraitement | Total |
|---|---|---|---|---|
| Parquet | 301 Mo | 30 s | 1,5 min | ~2 min |
| ORC | 395 Mo | 40 s | 1,5 min | ~2,2 min |
| CSV | 2,2 Go | 4 min | 1,5 min | ~5,5 min |
| CSV.GZ | 215 Mo | 21 s | 2 min | ~2,5 min |
| 50 millions d’événements (100 Mbit/s) | Taille du fichier | Importation | Prétraitement | Total |
|---|---|---|---|---|
| Parquet | 1,7 Go | 3 min | 2 min | ~5 min |
| ORC | 1,9 Go | 3,2 min | 2 min | ~5,2 min |
| CSV | 11,1 Go | 18 min | 2 min | ~20 min |
| CSV.GZ | 1,1 Go | 2 min | 3 min | ~5 min |
Pour les grands jeux de données, Parquet et ORC réduisent le temps de transfert grâce à des fichiers plus légers. Le CSV reste une solution simple pour les jeux de données plus petits ou lorsque votre processus d’export ne prend pas en charge les formats en colonnes. CSV.GZ peut réduire le temps de transfert sur une connexion lente, mais le temps de décompression augmente avec la taille du jeu de données.
Choisir un format de fichier
- Parquet : Un bon choix par défaut pour les grands jeux de données si votre pipeline de données le prend en charge. Dans ces tests, il a produit les fichiers les plus légers.
- ORC : Une solution comparable, particulièrement adaptée si votre pipeline de données utilise Hadoop ou Spark.
- CSV : Simple et largement pris en charge. Il peut convenir aux jeux de données plus petits.
- CSV.GZ : À envisager lorsque la vitesse d’importation est votre principale contrainte. Testez le temps de prétraitement avec vos propres données, surtout si le nombre d’événements est élevé.
Quels types de requêtes peuvent ralentir l’analyse ?
Certaines structures de données et configurations de Dashboard demandent plus de calculs que d’autres. Ces points de contrôle vous aideront à repérer les causes possibles de ralentissement des requêtes.
- Trop d’activités : Le calcul d’un flux de processus comportant plus de 50 activités distinctes peut prendre plus de temps, et le résultat peut être difficile à interpréter. Regroupez les étapes apparentées lorsque cela est pertinent.
- De nombreuses variantes uniques : Lorsque les cas suivent de nombreux chemins différents, le calcul des variantes demande davantage de travail. Une forte variation peut aussi révéler des comportements de processus qui méritent d’être étudiés.
- Des cas longs : Les cas comportant de nombreux événements demandent plus de traitement que les cas courts.
- Des colonnes superflues : Les attributs supplémentaires augmentent la taille du fichier et peuvent alourdir les requêtes. Conservez les champs utiles à votre analyse.
- Des Dashboards trop chargés : Chaque graphique ou vignette exécute sa propre requête. Gardez les éléments qui répondent à une question précise et placez les autres vues dans un Dashboard distinct.
- Des visualisations coûteuses : Sur les grands jeux de données, les graphiques comportant de nombreuses catégories peuvent mettre plus de temps à s’afficher. Utilisez une vue récapitulative si vous n’avez pas besoin d’une ventilation détaillée.
- Une animation avec de nombreux cas actifs : Le temps d’animation dépend du nombre de cas affichés. Réduisez la vitesse ou désactivez les traînées et les effets si vous souhaitez simplement examiner le flux.
Comment choisir la bonne taille de jeu de données ?
Commencez par le plus petit jeu de données qui permet de répondre à votre question. Un jeu ciblé est plus rapide à importer et plus facile à valider. Élargissez-le si vous devez couvrir davantage de cas, repérer des événements rares ou étudier des tendances à long terme.
Construire et valider le modèle avec un jeu de données plus petit
Commencez par un échantillon récent, configurez votre modèle et vérifiez les données avant de passer à une plus grande échelle.
- Commencez par un échantillon. Par exemple, extrayez 1 million d’événements sur une période récente de trois mois. Dans le test de référence, l’importation a pris 3 secondes à 1 Gbit/s ou 22 secondes à 100 Mbit/s, puis le prétraitement a duré 55 secondes.
- Construisez votre modèle. Configurez les activités, les filtres et les vues. Pour les jeux de données testés, de 1 à 10 millions d’événements, les modifications du modèle ont pris environ 14 à 20 secondes.
- Validez les résultats. Vérifiez que les noms d’activités et les chemins de processus sont cohérents, puis corrigez les problèmes de qualité des données.
- Ajoutez des données si nécessaire. Augmentez le nombre d’événements si vous devez étudier des cas rares ou comparer des périodes plus longues.
Le tableau compare le temps d’attente initial pour différents nombres d’événements, avec une connexion de 100 Mbit/s.
| Approche | Importation (100 Mbit/s) | Prétraitement | Attente totale | Vitesse du Dashboard |
|---|---|---|---|---|
| Commencer avec 1 million d’événements | 22 s | 55 s | ~1,5 min | 1 à 2 s |
| Commencer avec 5 millions d’événements | 2 min | 1,5 min | ~3,5 min | 1 à 2,5 s |
| Commencer avec 50 millions d’événements | 18 min | 2 min | ~20 min | 1 à 6 s |
Le nombre d’événements nécessaire dépend de votre question. Un jeu de données plus petit peut suffire pour étudier les schémas de processus courants, mais il vous faudra peut-être davantage de données pour examiner des événements rares ou couvrir l’ensemble de la population.
Segmentez les données lorsque votre question est précise
Si votre analyse porte sur un pays, un service ou une gamme de produits, commencez par ce segment au lieu de regrouper des ensembles sans lien entre eux. La segmentation peut clarifier les comparaisons et réduire le volume de données à traiter.
Par exemple, le test de référence décrit un jeu de données logistiques européen comprenant 42 millions d’événements d’expédition dans 8 pays :
- Tous les pays : 42 millions d’événements, 9,3 Go, 16 minutes d’importation à 100 Mbit/s et 2 minutes de prétraitement.
- Allemagne : 8,5 millions d’événements, 1,9 Go, 3 minutes d’importation et 1,5 minute de prétraitement.
- Pays-Bas : 3,1 millions d’événements, 690 Mo, 1 minute d’importation et 1 minute de prétraitement.
Vous pouvez comparer les segments après avoir validé chacun d’eux. Parmi les dimensions utiles figurent la zone géographique, l’organisation, le produit, la période et le segment de clientèle.
Filtrez les cas dont vous avez besoin
Si vous étudiez des exceptions, l’exportation des seuls cas pertinents peut réduire considérablement le jeu de données. Par exemple, le test de référence décrit un processus d’approvisionnement et de paiement comprenant 1,2 million de commandes et 8,4 millions d’événements. Selon ce test, 96 000 commandes, soit 8 %, comportaient des exceptions telles que des rejets, des retours, des factures en double ou des approbations manquantes.
Pour cette analyse, l’exportation des cas avec exception réduit le jeu de données de 8,4 millions à 670 000 événements. La taille du fichier passe, selon les résultats, de 1,9 Go à 150 Mo, et le temps d’importation à 100 Mbit/s, de 3 minutes à 15 secondes. Dans le test de référence, l’importation des mêmes données dans un fichier Parquet de 15 Mo prend moins de 2 secondes.
Filtrez par statut, activité, durée du cas, période ou unité opérationnelle lorsque ces champs correspondent à la question étudiée.
Ne sélectionnez que les colonnes nécessaires
Chaque colonne augmente la taille du fichier. Les champs texte longs, les identifiants redondants, les champs d’audit et les métadonnées techniques peuvent être inutiles à votre analyse.
Le test de référence décrit un export SAP de 1,8 million d’événements de commande comportant 45 colonnes. En ramenant ce nombre à 12 colonnes essentielles, la taille du fichier est passée de 2,1 Go à 380 Mo. L’exportation de ces colonnes au format Parquet l’a encore réduite à 58 Mo. Le temps d’importation à 100 Mbit/s est ainsi passé, selon les résultats, de 3,5 minutes à 6 secondes.
Conservez les champs utiles à votre analyse, notamment CaseId, Activity, Timestamp et les attributs métier pertinents, tels que le statut, le montant, la catégorie ou la région. Supprimez les informations personnelles lorsqu’elles ne sont pas nécessaires à l’analyse.
Quand faut-il utiliser un jeu de données plus volumineux ?
Un plus grand nombre d’événements peut être nécessaire si votre question dépend de l’étendue de la couverture ou de la période étudiée.
- Événements rares : Pour repérer des exceptions qui surviennent dans un cas sur 100 000, il faut une population suffisamment importante pour en contenir. Si une exception survient dans 0,01 % des cas et que vous souhaitez en étudier 50, il vous faut environ 500 000 cas.
- Variantes peu fréquentes : Des variantes qui surviennent dans 0,1 % des cas peuvent passer inaperçues dans un échantillon d’un million d’événements, mais être clairement mesurables dans une population de 50 millions d’événements.
- Conformité et audit : Certaines exigences imposent de couvrir l’ensemble de la population plutôt que de travailler sur un échantillon.
- Tendances à long terme : Pour comparer le premier trimestre 2024, le premier trimestre 2025 et le premier trimestre 2026, il faut disposer des données de ces trois périodes. Le chargement différentiel permet de constituer cette couverture progressivement.
Pour les jeux de données de plus de 50 millions d’événements, le test de référence recommande d’utiliser Parquet, d’importer les fichiers via l’API et, si possible, de disposer d’une connexion réseau rapide. Dans le test, le fichier CSV de 50 millions d’événements pesait 11,1 Go, contre 1,7 Go au format Parquet.
Les performances impliquent toujours un compromis : davantage de données et de vitesse entraînent un coût supérieur. La vraie question n’est pas ce qu’un outil peut faire, mais ce dont votre processus a besoin. ProcessMind peut traiter des volumes importants, mais nous déconseillons les jeux de données démesurés, souvent inutiles et assez complexes pour détourner l’attention de l’amélioration elle-même.
Comment garder un modèle et une interface réactifs ?
Le volume de données n’est qu’un facteur parmi d’autres. La conception du modèle de processus et du Dashboard influe également sur votre rapidité de travail.
- Gardez un modèle lisible : Divisez les processus volumineux en sous-processus modulaires. Un canevas contenant de nombreux éléments visibles peut prendre plus de temps à s’afficher et être plus difficile à parcourir. Utilisez auto-layout après toute modification structurelle.
- Choisissez soigneusement les composants du Dashboard : Chaque graphique et vignette nécessite un calcul. Gardez les vues qui répondent à vos questions du moment.
- Choisissez des graphiques adaptés aux données : Sur les grands jeux de données, une visualisation comportant de nombreuses catégories peut prendre plus de temps à calculer. Utilisez une vue récapitulative si vous n’avez pas besoin d’une ventilation détaillée.
- Limitez les filtres à la question étudiée : Les filtres peuvent aider à cibler une analyse. Évitez de combiner des filtres qui ne contribuent pas à la question à laquelle vous cherchez à répondre.
- Réglez les paramètres d’animation : Le coût de l’animation augmente avec le nombre de cas actifs. Réduisez la vitesse ou désactivez les traînées et les effets si vous souhaitez simplement examiner le flux. Consultez la page Animation du processus.
- Ne recalculez que les éléments modifiés : Les modifications du modèle mettent à jour les calculs qui en dépendent sans relancer l’ensemble du prétraitement. Dans le test de référence, ces modifications ont pris environ 14 secondes pour 1 million d’événements et 52 secondes pour 100 millions.
Comment le chargement différentiel réduit-il le temps d’importation ?
Le chargement différentiel vous permet d’ajouter de nouveaux événements à un jeu de données existant, sans devoir importer à nouveau l’ensemble des données. Il réduit le volume transféré lors de la mise à jour d’un journal d’événements qui s’enrichit au fil du temps.
| Scénario | Réimportation complète | Importation différentielle | Temps gagné |
|---|---|---|---|
| 10 millions d’événements initiaux + 500 000 nouveaux (100 Mbit/s) | 4 min d’importation | 5 s d’importation | ~4 min |
| 20 millions d’événements initiaux + 2 millions de nouveaux (100 Mbit/s) | 7 min d’importation | 44 s d’importation | ~6 min |
| 50 millions d’événements initiaux + 5 millions de nouveaux (100 Mbit/s) | 18 min d’importation | 2 min d’importation | ~16 min |
Après une importation différentielle, le prétraitement est relancé sur le jeu de données complet. Dans le test de référence, cette étape a pris entre 1 et 2,5 minutes. Le gain de temps à l’importation vient du transfert des seuls nouveaux événements.
Le fichier différentiel doit utiliser le même format et la même structure de colonnes que le fichier importé initialement. Consultez le guide du chargement incrémentiel des données pour en savoir plus.
Quand importer un fichier via l’API ?
Pour les importations récurrentes ou les fichiers de plusieurs gigaoctets, l’importation via une API peut être plus facile à gérer qu’un transfert par navigateur. Un script ou un outil en ligne de commande peut s’intégrer à un pipeline ETL, prendre en charge les importations planifiées et afficher la progression du transfert.
ProcessMind fournit des URL pré-signées pour importer directement des fichiers dans un espace de stockage cloud. Vous pouvez copier l’URL d’importation depuis le menu des paramètres du jeu de données dans l’interface ProcessMind.
# Upload a Parquet file directly using a presigned URL
curl -X PUT "$PRESIGNED_URL" --upload-file data.parquet
Consultez la documentation de l’API pour découvrir des exemples en Bash, JavaScript et Python, notamment pour obtenir des URL pré-signées et importer des fichiers différentiels.
Quand faut-il scinder un jeu de données ?
Scindez un jeu de données lorsqu’une analyse précise ne nécessite qu’un sous-ensemble des données ou lorsque vous devez comparer séparément des groupes distincts. Vous pouvez segmenter les données par zone géographique, service, gamme de produits, période ou type de cas, puis analyser chaque jeu séparément.
Conservez les données ensemble si votre analyse repose sur la comparaison de groupes ou le suivi de l’ensemble du processus entre ces groupes. Avant de scinder les données, vérifiez que cette opération ne modifie pas le sens du cas et ne supprime pas des événements nécessaires à la compréhension de son parcours. Par exemple, une séparation par période doit tenir compte des cas qui commencent sur une période et se terminent sur une autre.
Testez les performances avec vos propres données
Les tests de référence vous aident à planifier, mais ne permettent pas de prévoir les résultats pour tous les journaux d’événements, réseaux ou types de requêtes. Testez le jeu de données que vous comptez utiliser, puis vérifiez le temps d’importation, le temps de prétraitement et les temps de réponse des vues du Dashboard qui vous intéressent.
Consultez d’abord les recommandations relatives à la préparation des données si vous avez besoin d’aide pour structurer votre journal d’événements. Vous pouvez également découvrir comment analyser votre processus et comment suivre votre processus en continu.
Testez avec votre propre volume de données
Importez le journal d’événements que vous prévoyez d’analyser et mesurez les performances avec vos données.