Công cụ ETL cho process mining: bạn cần gì
Khi nào process mining cần ETL, dữ liệu trích xuất cần có gì và vì sao ProcessMind tải được đầu ra từ pipeline hiện có của bạn.

Bạn có cần ETL cho process mining không?
Công cụ ETL trích xuất dữ liệu từ hệ thống nguồn, chuyển đổi dữ liệu sang định dạng có thể sử dụng rồi tải lên để phân tích. Bài viết này nói về phần ETL mà một dự án process mining thực sự cần và những trường hợp có thể bỏ qua. Đây không phải hướng dẫn chọn mua pipeline. Nếu một hệ thống có thể xuất dữ liệu và tệp có mã hồ sơ, hoạt động cùng dấu thời gian, bạn thường có thể bỏ qua pipeline trong lần phân tích đầu tiên và tải thẳng tệp xuất lên.
Câu trả lời tùy thuộc vào quy trình, các hệ thống liên quan và tần suất cần làm mới kết quả phân tích. Hãy bắt đầu với lượng dữ liệu nhỏ nhất có thể trả lời câu hỏi, rồi bổ sung bước chuẩn bị và tự động hóa khi kết quả ban đầu cho thấy cần thiết.
Có ba trường hợp nên đầu tư công sức cho ETL:
- Quy trình trải rộng trên nhiều hệ thống. Bạn cần kết hợp các bản ghi và đồng bộ mã định danh trước khi theo dõi một hồ sơ từ đầu đến cuối.
- Không thể đọc dữ liệu nguồn ở dạng hiện tại. Bạn cần chuẩn hóa tên hoạt động, dấu thời gian hoặc mã hồ sơ trước khi phân tích.
- Cần xuất dữ liệu định kỳ. Khi dữ liệu thay đổi mỗi ngày và phân tích cần cập nhật theo, việc xuất thủ công sẽ không còn phù hợp.
Đây là lý do để chuẩn bị dữ liệu, chứ không phải lý do xây pipeline trước khi trả lời câu hỏi đầu tiên. Hãy tải lên những gì bạn có, xem còn thiếu gì rồi quyết định bước tiếp theo.
Trước đây, chúng tôi nghĩ ETL phải được tích hợp vào sản phẩm. Sau đó, chúng tôi xem khách hàng đã có những gì. Làn sóng kho dữ liệu kéo dài khoảng 20 năm, với nhiều tên gọi như data mart và data lake. Kết quả là hiện nay, hầu hết công ty đều đã có dữ liệu dùng được. Vì vậy, chúng tôi không xây pipeline riêng nữa. Hãy tải tệp xuất từ các hệ thống bạn đang dùng, hoặc kết nối pipeline mà nhóm bạn đã duy trì với API của chúng tôi, rồi bắt đầu từ dữ liệu sẵn có.
Bạn cũng có thể bỏ qua pipeline riêng nếu:
- Quy trình chủ yếu được ghi nhận trong một hệ thống.
- Có thể xuất các bản ghi cần thiết.
- Tệp xuất có mã hồ sơ, hoạt động và dấu thời gian.
- Tệp đủ nhỏ để chuẩn bị thủ công.
- Bạn vẫn đang kiểm tra xem dữ liệu có trả lời được câu hỏi hay không.
Bạn có thể dùng bảng tính để đổi tên cột, sửa những điểm không nhất quán dễ thấy và bỏ các trường không cần thiết. Việc chuẩn bị thủ công không nhất thiết phải kéo dài mãi. Khi phân tích cho thấy có ích và dữ liệu cần được làm mới thường xuyên, hãy tự động hóa những bước bạn phải lặp đi lặp lại.
Tệp dữ liệu xuất cần có những gì
Nhật ký sự kiện dùng cho process mining cần ba trường và mỗi hàng tương ứng với một sự kiện.
| Trường | Ý nghĩa | Cần kiểm tra |
|---|---|---|
| Mã hồ sơ | Phiên bản quy trình, chẳng hạn một đơn hàng hoặc yêu cầu dịch vụ | Mã hồ sơ phải giống nhau ở mọi sự kiện thuộc cùng một phiên bản |
| Hoạt động | Một bước đã diễn ra trong quy trình | Tên gọi phân biệt được các bước thực tế và được dùng nhất quán |
| Dấu thời gian | Thời điểm bước đó diễn ra | Ngày giờ hợp lệ, cùng múi giờ trên các nguồn được kết hợp |
Các thuộc tính như chi phí, người dùng, nhóm, phân khúc khách hàng hoặc lượng CO2 là tùy chọn. Nhưng chính những thuộc tính này giúp bạn chuyển từ xem quy trình sang phân tích: mỗi thuộc tính được giữ lại có thể trở thành bộ lọc, tiêu chí phân nhóm hoặc thước đo. Tham khảo tài liệu về thuộc tính bộ dữ liệu để biết mỗi trường có thể giúp bạn làm gì.
Một trường có trong hệ thống nguồn chưa chắc đã dùng được. Mã hồ sơ thay đổi giữa các hệ thống sẽ không thể kết nối sự kiện. Tên hoạt động thiếu nhất quán có thể khiến một bước thực tế bị chia thành ba bước. Dấu thời gian lưu dưới dạng văn bản có thể làm sai thứ tự sự kiện. Hãy kiểm tra tệp xuất trước khi ánh xạ và xem kỹ ba trường bắt buộc. Để biết nhật ký cần có những gì, hãy đọc process mining cần dữ liệu gì.
Truy vấn nhật ký sự kiện tối thiểu có thể dùng
Nếu hệ thống nguồn đã lưu mỗi hoạt động trên một hàng riêng, bạn chỉ cần truy vấn select. Ví dụ này giả định có bảng tên là process_events với mã hồ sơ, hoạt động và thời điểm sự kiện:
SELECT
  case_id        AS case_id,
  activity_name  AS activity,
  event_time     AS timestamp
FROM process_events
WHERE case_id IS NOT NULL
  AND activity_name IS NOT NULL
  AND event_time IS NOT NULL
ORDER BY case_id, event_time;
Truy vấn đặt tên cho ba trường, loại bỏ các hàng không dùng được và sắp xếp sự kiện trong từng hồ sơ. Hãy thay tên bảng và tên cột cho khớp với nguồn dữ liệu, rồi kiểm tra một số hồ sơ mẫu trước khi tải lên. Mỗi hồ sơ cần có đúng các sự kiện bạn mong đợi, theo thứ tự mà người trực tiếp làm việc có thể xác nhận.
Những bước chuyển đổi nào là cần thiết
Chỉ nên chuyển đổi dữ liệu để tránh làm sai lệch kết quả phân tích. Bốn bước sau thường là đủ.
-
Chuẩn hóa sự kiện
Đưa mỗi lần hoạt động diễn ra vào một hàng riêng, kèm mã hồ sơ và dấu thời gian, kể cả khi hệ thống nguồn lưu các bước quy trình ở những cột riêng. -
Đưa dấu thời gian về định dạng có thể dùng
Kiểm tra giá trị có phải ngày giờ hợp lệ không, và đó là giờ địa phương hay UTC. Đồng bộ múi giờ của các nguồn được kết hợp, nếu không thứ tự sự kiện sẽ sai. -
Chuẩn hóa tên hoạt động
Dùng một tên nhất quán, cùng ngôn ngữ và cách viết cho mỗi bước thực tế. Đừng gộp các bước chỉ vì tên gọi trông giống nhau để rút ngắn danh sách. -
Chỉ kết hợp nguồn khi cần
Tìm khóa liên kết các bản ghi và kiểm tra xem khóa có khớp không. Nếu phép nối làm trùng sự kiện hoặc bỏ sót hồ sơ, góc nhìn quy trình sẽ thay đổi. Hãy so sánh số lượng bản ghi trước và sau khi nối.
Nếu tệp xuất đã có mỗi sự kiện trên một hàng cùng đủ ba trường, bạn không cần chuyển đổi gì cả. Đây là kết quả bình thường, không phải lối tắt. Cách tạo nhật ký sự kiện cho process mining hướng dẫn các bước tương tự với ví dụ bằng Excel và SQL.
Nên tải nhật ký sự kiện lên đâu?
Tải dữ liệu đã chuẩn bị lên nền tảng bạn sẽ dùng để phân tích. Để xem thử lần đầu, chỉ cần một tệp: chuẩn bị tệp, tải lên, xem góc nhìn quy trình rồi điều chỉnh dữ liệu xuất khi biết dữ liệu có thể cho thấy điều gì. Đừng dựng thêm một lớp lưu trữ chỉ để dùng cho process mining. Nếu nhóm bạn đã duy trì kho dữ liệu hoặc data lake, hãy giữ dữ liệu ở đó và tải lên từ dữ liệu mà hệ thống hiện có tạo ra.
Trang các định dạng dữ liệu được hỗ trợ có thông tin chi tiết. Nếu không muốn tải thủ công, bạn có thể dùng tác vụ theo lịch để gửi các định dạng này qua data API.
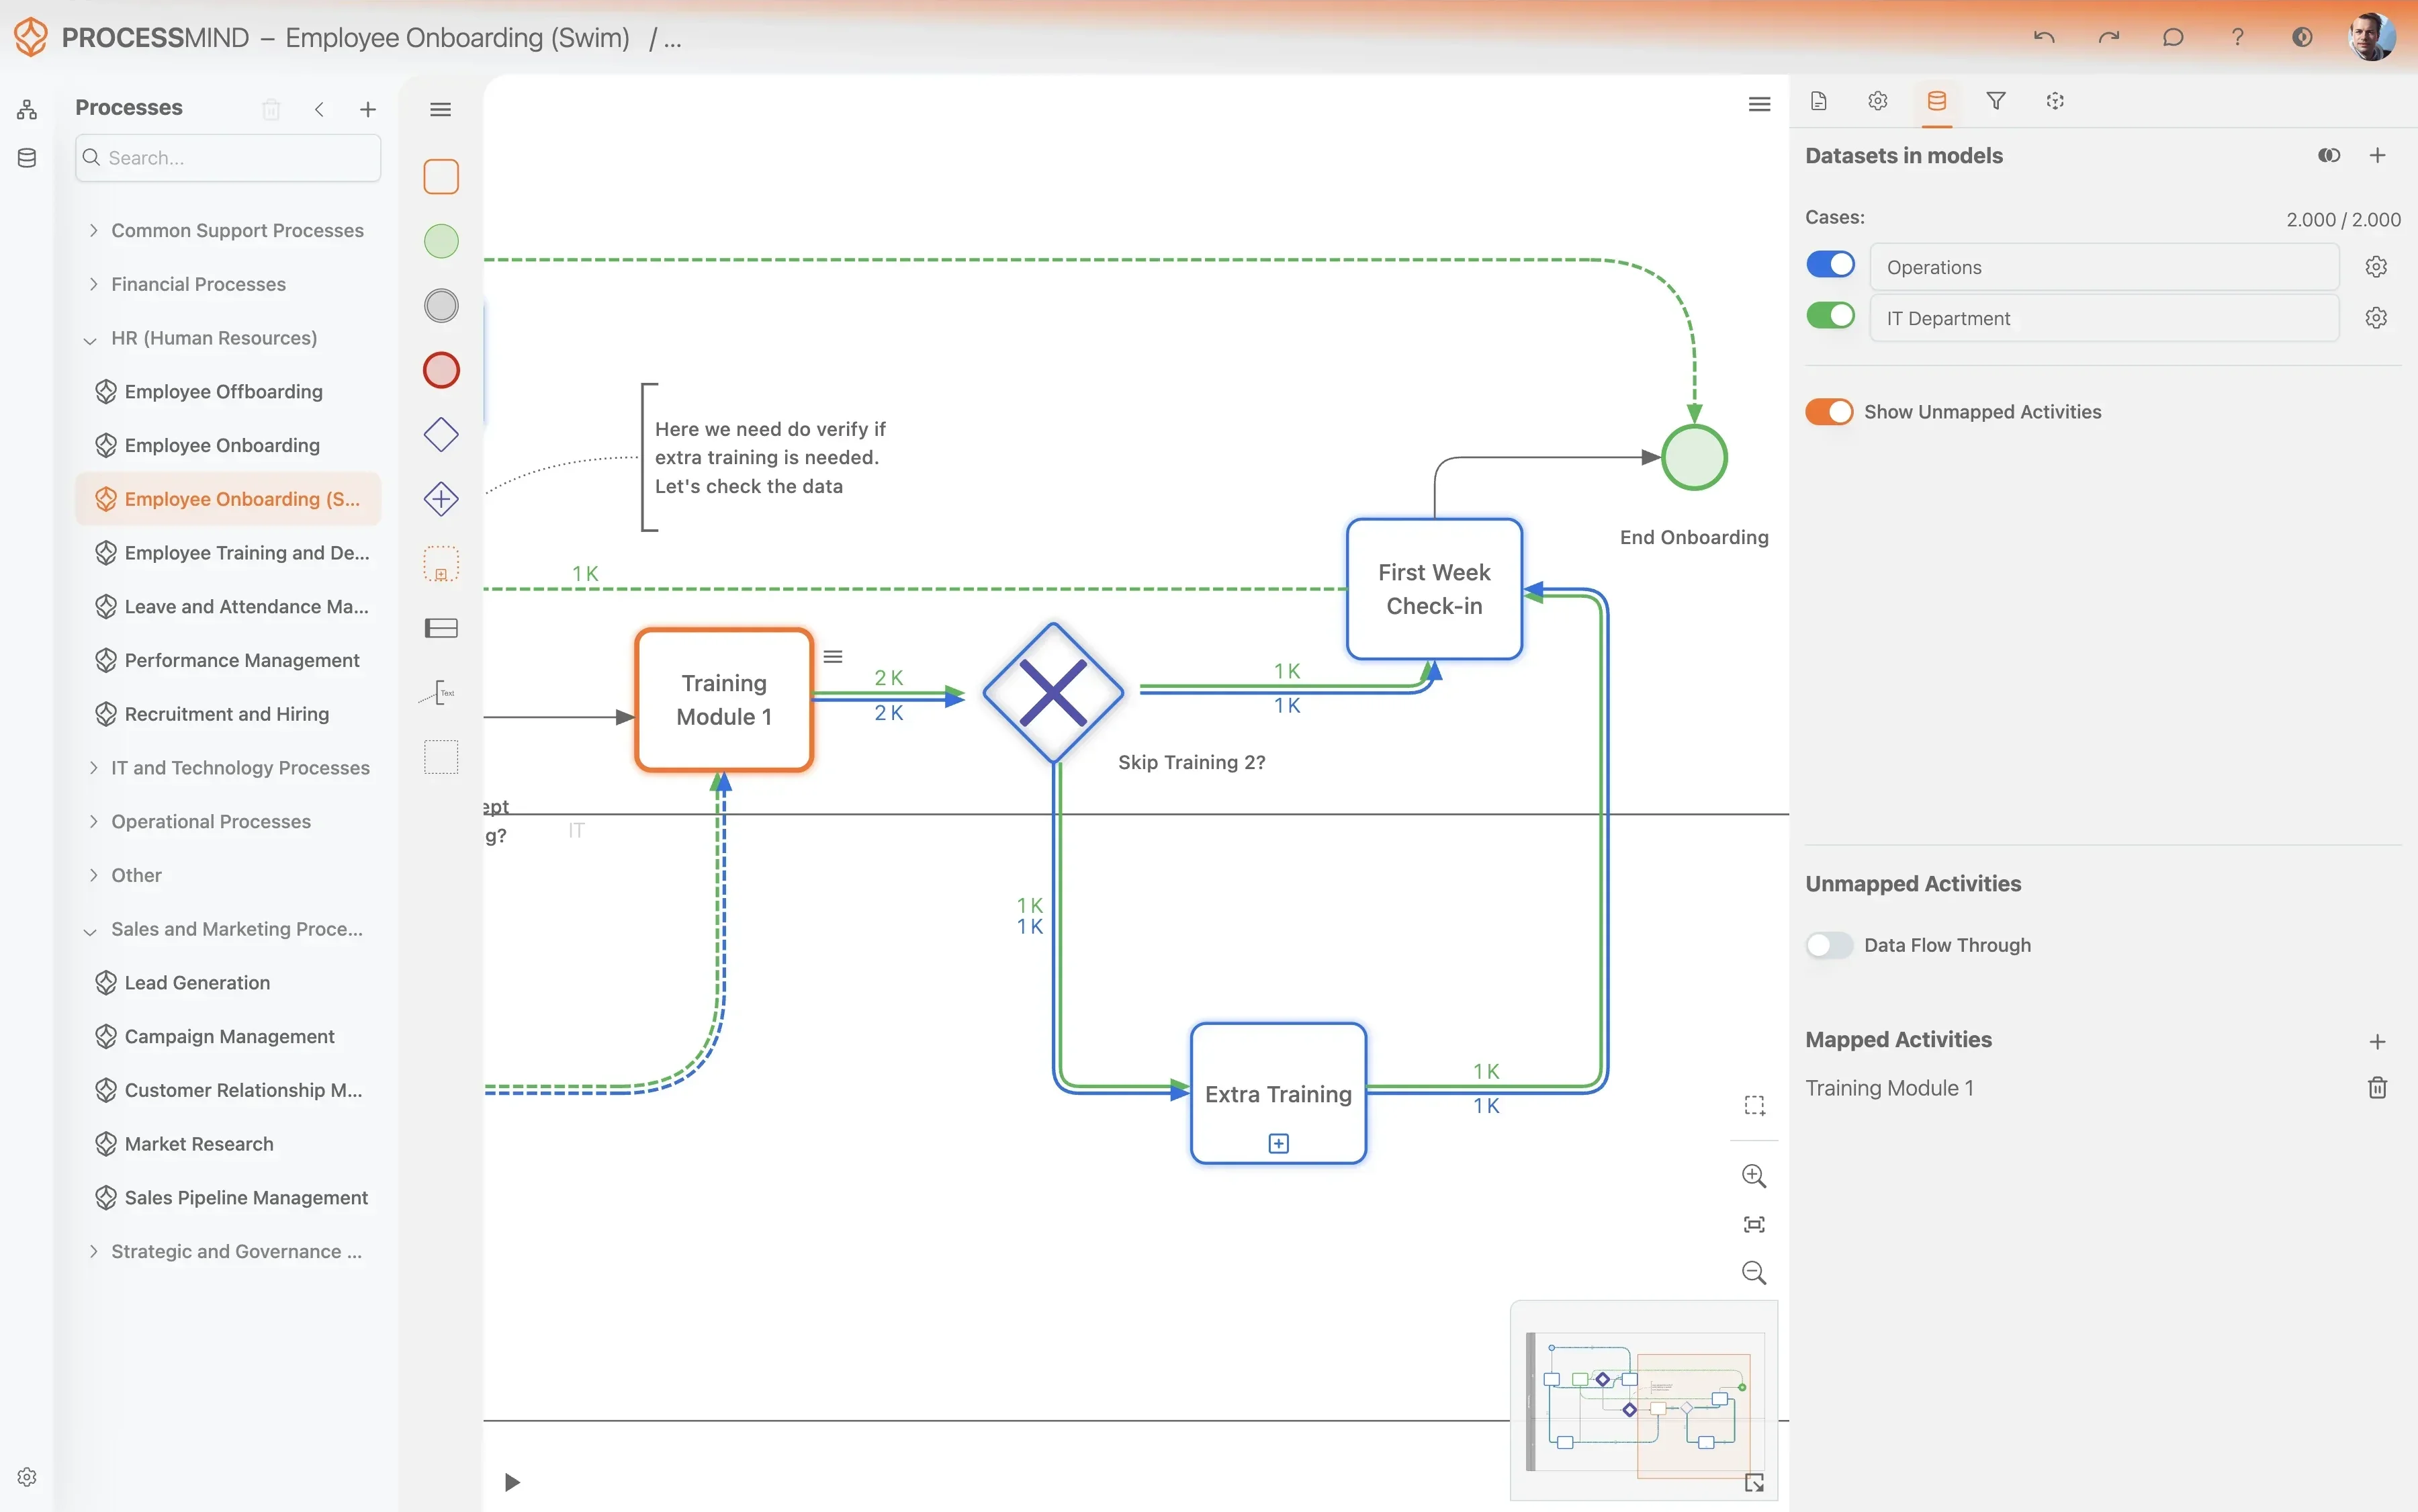
Dù chọn cách nào, dữ liệu sau khi tải lên cũng cần đến được nơi bạn phân tích. Một tệp nằm trong thư mục không ai theo dõi không phải là chiến lược dữ liệu. Một bộ dữ liệu được người dùng ánh xạ và kiểm tra thì có.
Công cụ ETL nào phù hợp với process mining?
Không có danh sách công cụ ETL nào phù hợp với mọi dự án. Hãy chọn dựa trên nơi lưu dữ liệu, những công cụ nhóm bạn đang dùng và mức độ cần chuẩn bị nhật ký. Công việc này về cơ bản là kỹ thuật dữ liệu thông thường. Yêu cầu riêng của process mining chỉ là dữ liệu đầu ra phải giữ được mã hồ sơ, hoạt động và dấu thời gian.
| Cách làm | Phù hợp khi | Đánh đổi |
|---|---|---|
| Xuất và chuẩn bị thủ công | Bạn đang thử nghiệm một quy trình với bộ dữ liệu nhỏ, ổn định | Bắt đầu nhanh nhất, nhưng mỗi lần làm mới đều cần thao tác thủ công |
| Dùng công cụ nhóm bạn đang vận hành | Nhóm đã có SQL, dbt, kho dữ liệu hoặc data lake | Tận dụng kỹ năng và hạ tầng sẵn có, đồng thời có thể tái sử dụng logic ngoài process mining |
| Dùng công cụ ETL của bên thứ ba | Cần trích xuất dữ liệu định kỳ từ nhiều hệ thống | Cần thiết lập và duy trì thêm nhiều thành phần |
| Dùng ETL tích hợp trong nền tảng khai phá quy trình | Nền tảng hỗ trợ các bước chuyển đổi bạn cần | Tiện lợi, nhưng hãy kiểm tra khả năng chuyển logic sang nơi khác và tái sử dụng dữ liệu |
Một số tên thường gặp trong các dự án process mining: CData và dbt để trích xuất dữ liệu và chuyển đổi bằng SQL; BigQuery, Snowflake và Databricks cho kho dữ liệu; Talend, Apache NiFi và Airbyte khi khó khăn chính là chuyển dữ liệu giữa các hệ thống. Công cụ mã nguồn mở cũng là lựa chọn thực tế. NiFi và Airbyte thường là điểm khởi đầu. Một số nhà cung cấp như Evidant và Konekti có bán ETL dành cho process mining, kèm mẫu cho các hệ thống phổ biến.
Đây chỉ là ví dụ, không phải lời chứng thực hay quan hệ đối tác. Hãy ưu tiên công cụ và định dạng mà nhóm bạn có thể duy trì sau dự án. Nếu có thể, hãy giữ logic chuyển đổi bên ngoài sản phẩm khai phá quy trình. Cần cân nhắc kỹ ETL tích hợp: cách này tiện lợi khi bạn tiếp tục dùng nền tảng đó, nhưng logic chuẩn bị dữ liệu sẽ khó tái sử dụng hơn cho dự án phân tích hoặc AI tiếp theo.
Quản lý dữ liệu thế nào sau khi tải lên?
Trích xuất mới chỉ là một nửa công việc. Cách bạn quản lý bộ dữ liệu sau đó sẽ quyết định liệu kết quả phân tích còn đáng tin sau ba tháng hay không.
- Đặt tên bộ dữ liệu theo nội dung.
Q1_2025_Sales_DatahoặcCustomer_Support_Logstốt hơnexport_final_v3. - Chọn định dạng phù hợp. CSV hoặc Excel phù hợp với tệp nhỏ được tải thủ công. Parquet hoặc ORC hữu ích với bộ dữ liệu lớn và dữ liệu do pipeline tạo ra.
- Xem trước trước khi ánh xạ. Kiểm tra cấu trúc, kiểu dữ liệu của các cột và một vài hàng. Xác nhận mã hồ sơ, hoạt động và dấu thời gian trong cấu hình bộ dữ liệu.
- Kiểm tra ánh xạ hoạt động. Để tính năng tự động ánh xạ thực hiện lượt đầu, sau đó xử lý các hoạt động chưa được ánh xạ. Bạn có thể đánh dấu các bước đã diễn ra nhưng không để lại dấu vết trong dữ liệu là data flow through. Nhờ đó, các bước vẫn hiển thị mà không làm thay đổi số liệu.
- Làm mới, không dựng lại. Với dữ liệu xuất định kỳ, hãy thay bộ dữ liệu bằng tệp mới theo tần suất phân tích thực sự cần, hằng ngày hoặc hằng tuần, và giữ nguyên ánh xạ.
- Ghi rõ dữ liệu không bao quát những gì. Ghi chú phân tích cần nêu các khoảng thời gian, hệ thống và bước còn thiếu, vì chúng quyết định bạn có thể kết luận điều gì.
- Kiểm soát quyền truy cập rồi lưu trữ. Chỉ cấp quyền truy cập bộ dữ liệu cho người cần dùng và lưu trữ những dữ liệu không còn được dự án đã hoàn tất sử dụng.
Tóm lại
ETL là phương tiện, không phải mục tiêu của dự án process mining. Hãy thiết lập ETL sao cho không làm chậm lần phân tích đầu tiên:
- Bắt đầu với dữ liệu bạn có thể lấy trong tuần này.
- Dù bỏ trường nào, hãy giữ nguyên ba trường bắt buộc.
- Tải tệp xuất lên trước, chỉ tự động hóa khi kết quả phân tích cho thấy việc đó đáng làm.
- Dùng công cụ và định dạng mà nhóm bạn đang duy trì.
Nhiều dự án thất bại vì pipeline được xây trước khi có ai biết nó cần trả lời câu hỏi nào, chứ không phải vì pipeline quá đơn giản.
Where to Go From Here
Bạn đã có tệp xuất hoặc pipeline có thể tạo tệp đó. Bước tiếp theo là tải dữ liệu lên và kiểm tra xem tệp xuất có trả lời được câu hỏi của bạn không.