Prestazioni del Process Mining: benchmark e consigli
Scopra come il volume dei dati, il formato dei file e la struttura delle query incidono sulle prestazioni del process mining, con benchmark datati da 100.000 a 100 milioni di eventi.
Le prestazioni del Process Mining dipendono da più fattori del semplice numero di eventi. Dimensione del file, numero di casi, struttura delle query e velocità della rete incidono tutti sui tempi di attesa. I benchmark riportati di seguito riguardano insiemi di dati da 100K a 100M di eventi. Sono stati eseguiti a marzo 2026 su infrastruttura AWS di produzione, con i formati di file e le condizioni di test descritti qui.
Punti chiave
- Con file di grandi dimensioni o connessioni lente, il caricamento può rappresentare la parte più lunga dell’attesa.
- I file Parquet e ORC sono molto più leggeri dei file CSV non elaborati e riducono i tempi di trasferimento.
- I tempi di risposta delle Dashboard dipendono dalla query. Le statistiche vengono elaborate rapidamente, mentre i flussi di processo richiedono più tempo all’aumentare del numero di eventi.
- Il caricamento incrementale trasferisce i nuovi eventi senza dover caricare di nuovo l’intero insieme di dati.
- Un insieme di dati mirato può essere più rapido da caricare e più semplice da analizzare.
Da cosa dipendono le prestazioni del Process Mining?
Le prestazioni dipendono da quattro fattori: la quantità di dati, la struttura dell’Event Log, la query eseguita e l’ambiente utilizzato per trasferire ed elaborare i dati.
- Numero di eventi e di casi: In genere, più eventi significano più dati da caricare ed elaborare. Il numero di casi determina quante istanze del processo comprende l’analisi.
- Struttura della query: Una statistica riepilogativa e un flusso di processo richiedono calcoli diversi. Le query che calcolano le transizioni tra le attività possono richiedere più tempo di quelle basate su dati già aggregati.
- Numero di attività e durata dei casi: Un numero maggiore di attività distinte e casi più lunghi aumentano il lavoro necessario per calcolare i flussi e le varianti.
- Dimensione del file e velocità della rete: Da questi fattori dipende il tempo di caricamento. Un CSV con molte colonne e campi di testo lunghi può essere molto più grande di un file colonnare compatto con gli stessi eventi.
Il solo numero di eventi non basta per prevedere quanto tempo richiederà l’elaborazione di un insieme di dati. Utilizzi i benchmark come riferimento, quindi provi l’Event Log e le query che intende usare. È il modo più utile per valutare le prestazioni del Process Mining nel Suo ambiente.
La pipeline dei dati: dove si impiega il tempo?
Un insieme di dati attraversa tre fasi: caricamento, preelaborazione e ricalcolo quando si modifica il modello di processo.
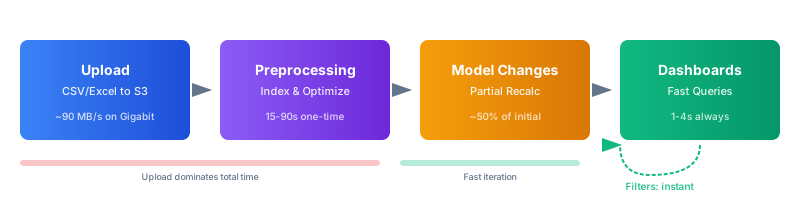
- Caricamento: Il file viene trasferito via Internet all’infrastruttura cloud di ProcessMind. Il tempo necessario dipende dalla velocità della rete e dalle dimensioni del file. Per esempio, un CSV da 11 GB con 50 milioni di eventi richiede circa 2 minuti a 1 Gbps, 18 minuti a 100 Mbps o più di 3 ore a 10 Mbps. Gli stessi dati in un file Parquet da 1,7 GB richiedono circa 19 secondi, 3 minuti o 28 minuti alle stesse velocità.
- Preelaborazione: Dopo il caricamento, il sistema converte i dati in un formato colonnare ottimizzato, indicizza gli eventi, calcola le transizioni tra le attività e le varianti di processo e genera statistiche riepilogative. Nei benchmark riportati di seguito, questa fase richiede 35 secondi per 100.000 eventi e fino a 2,5 minuti per 100 milioni di eventi.
- Modifiche al modello: Quando modifica le mappature delle attività o ne aggiunge o rimuove, ProcessMind aggiorna i calcoli che dipendono dal modello. Nei benchmark riportati di seguito, l’operazione richiede circa 14 secondi per 1 milione di eventi e 52 secondi per 100 milioni di eventi. Le modifiche ai filtri sono immediate.
Con gli insiemi di dati più grandi, ridurre le dimensioni del file è spesso il modo più efficace per abbreviare l’attesa iniziale. Una volta completata la preelaborazione, le prestazioni delle query dipendono dai calcoli richiesti dalla Dashboard.
Come variano le prestazioni delle query?
Le query hanno costi diversi. Queste caratteristiche aiutano a capire cosa aspettarsi e come strutturare i dati.
- Numero di attività: I modelli con 10–20 attività distinte sono più semplici da analizzare e visualizzare. Oltre 50 attività, il calcolo dei flussi di processo richiede più tempo e la lettura può risultare più difficile. Raggruppi i passaggi correlati quando ciò rispecchia fedelmente il processo.
- Varietà delle varianti: In genere, un processo in cui la maggior parte dei casi segue pochi percorsi è più rapido da analizzare rispetto a uno in cui ogni caso segue un percorso diverso. Un’elevata variabilità può essere significativa, ma può allungare i tempi delle query.
- Numero di colonne: Per analizzare il processo servono i campi principali CaseId, Activity e Timestamp. Gli attributi aggiuntivi consentono di filtrare e classificare i dati, ma aumentano la quantità di dati da trasferire e analizzare.
- Durata dei casi: Un caso con 50 eventi richiede più elaborazione di uno con 5. Le query possono richiedere più tempo nei processi in cui i casi comprendono centinaia di eventi.
Tempi di risposta delle Dashboard
Questi valori mediani derivano da più esecuzioni dei benchmark. Ogni componente della Dashboard esegue la propria query e viene caricato in parallelo.
| Insieme di dati | Statistiche | Flusso di processo | Varianti | Categorie | Esplorazione dei dati | Animazione |
|---|---|---|---|---|---|---|
| 100K | 0.6s | 1.5s | 1.1s | 1.5s | 1.2s | 1.4s |
| 1M | 0.6s | 1.6s | 1.4s | 1.9s | 1.5s | 2.0s |
| 5M | 0.6s | 2.5s | 1.8s | 2.4s | 1.3s | 2.1s |
| 10M | 0.6s | 3.4s | 2.2s | 2.5s | 1.6s | 2.4s |
| 20M | 0.6s | 3.9s | 2.7s | 3.3s | 1.9s | 3.6s |
| 50M | 0.6s | 5.1s | 4.2s | 5.7s | 1.6s | 2.7s |
| 100M | 0.6s | 7.2s | 3.5s | 4.7s | 1.6s | 5.0s |
Le statistiche hanno richiesto circa 0,6 secondi per tutte le dimensioni testate. Il Flusso di processo ha impiegato più tempo all’aumentare degli eventi, perché calcola le transizioni tra le attività. Le Varianti e le Categorie hanno avuto una crescita moderata dei tempi, mentre l’Esplorazione dei dati è rimasta reattiva grazie alla paginazione. I tempi dell’Animazione sono variati in base al numero di casi attivi visualizzati.
Per un numero di eventi compreso tra 1 e 10 milioni, i tempi di risposta misurati sono andati da 0,6 a 3,4 secondi, a seconda del componente. Con 50 milioni di eventi, il Flusso di processo e le Categorie hanno richiesto circa 5–6 secondi. Si tratta di risultati dei benchmark, non di una garanzia valida per ogni insieme di dati o ambiente.
Dati dei benchmark: quali condizioni sono state testate?
I benchmark sono stati eseguiti sull’infrastruttura AWS di produzione a marzo 2026. I tempi di caricamento e preelaborazione sono medie calcolate su più prove. I tempi di risposta delle Dashboard sono mediane di più esecuzioni. Per ogni dimensione dell’insieme di dati sono stati testati oltre 50 tipi di query.
Il numero di eventi riportato di seguito corrisponde ai conteggi effettivi nei file di prova. Le dimensioni si riferiscono a file CSV non compressi con uno schema tipico di Event Log: CaseId, Activity, Timestamp e 5–8 attributi aziendali. Le dimensioni dei file e i risultati variano in base al numero di colonne, ai contenuti, alle condizioni della rete, alla distanza dal centro dati e al carico del momento.
Tempi di caricamento e preelaborazione
| Insieme di dati | Eventi effettivi | Dimensione del file | Caricamento (1 Gbps) | Caricamento (100 Mbps) | Caricamento (50 Mbps) | Caricamento (10 Mbps) | Preelaborazione |
|---|---|---|---|---|---|---|---|
| 100K | 125,260 | 22 MB | < 1s | 2s | 4s | 22s | 35s |
| 500K | 626,300 | 110 MB | 1s | 11s | 22s | 2 min | 45s |
| 1M | 1,253,424 | 221 MB | 3s | 22s | 44s | 4 min | 55s |
| 2M | 2,506,848 | 443 MB | 5s | 44s | 1.5 min | 7 min | 1 min |
| 5M | 4,996,877 | 1.1 GB | 13s | 2 min | 4 min | 18 min | 1.5 min |
| 10M | 12,511,867 | 2.2 GB | 25s | 4 min | 7 min | 37 min | 1.5 min |
| 20M | 25,023,734 | 4.4 GB | 50s | 7 min | 15 min | 1.2 hr | 2 min |
| 50M | 62,559,335 | 11.1 GB | 2 min | 18 min | 37 min | 3 hr | 2 min |
| 100M | 125,118,670 | 22.3 GB | 4 min | 37 min | 1.2 hr | 6 hr | 2.5 min |
La velocità di trasferimento misurata a 1 Gbps è stata di 88 MB/s verso AWS eu-central-1. Le altre velocità sono stime basate su velocità di trasferimento effettive: circa 5 MB/s a 50 Mbps, 10 MB/s a 100 Mbps e 1 MB/s a 10 Mbps. La velocità effettiva dipende dalla rete e dalle condizioni di connessione.
In questa prova, la preelaborazione ha richiesto da 35 secondi a 2,5 minuti. Il tempo di caricamento è aumentato con le dimensioni del file, diventando la componente più lunga dell’attesa per i file di grandi dimensioni.
Formato dei file: Parquet e ORC a confronto con CSV
ProcessMind supporta CSV, Parquet, ORC, Excel e XES. Il confronto delle dimensioni dei file utilizza gli stessi conteggi di eventi e lo stesso schema del benchmark precedente.
| Insieme di dati | CSV | Parquet | ORC | CSV.GZ |
|---|---|---|---|---|
| 1M eventi | 221 MB | 34 MB | 39 MB | 20 MB |
| 5M eventi | 1.1 GB | 151 MB | 197 MB | 107 MB |
| 10M eventi | 2.2 GB | 301 MB | 395 MB | 215 MB |
| 20M eventi | 4.4 GB | 603 MB | 791 MB | 430 MB |
| 50M eventi | 11.1 GB | 1.7 GB | 1.9 GB | 1.1 GB |
| 100M eventi | 22.3 GB | 3.4 GB | 3.7 GB | 2.2 GB |
In queste prove, i file Parquet erano circa l’85% più piccoli dei CSV e i file ORC circa l’82% più piccoli. Entrambi sono formati colonnari con compressione integrata. Strumenti per i dati come Spark, Databricks, dbt e BigQuery potrebbero consentire l’esportazione in questi formati.
I tempi di preelaborazione sono stati simili per Parquet, ORC e CSV. Con un numero elevato di eventi, CSV.GZ ha richiesto più tempo perché i file gzip non possono essere suddivisi per la decompressione parallela.
| Insieme di dati | Parquet | ORC | CSV | CSV.GZ |
|---|---|---|---|---|
| 1M eventi | 55s | 55s | 55s | 55s |
| 5M eventi | 1.5 min | 1.5 min | 1.5 min | 1.5 min |
| 10M eventi | 1.5 min | 1.5 min | 1.5 min | 2 min |
| 20M eventi | 2 min | 2 min | 2 min | 2.5 min |
| 50M eventi | 2 min | 2 min | 2 min | 3 min |
| 100M eventi | 2.5 min | 2.5 min | 2.5 min | 4.5 min |
Il tempo totale comprende caricamento e preelaborazione. Gli esempi utilizzano una connessione a 100 Mbps.
| 10M eventi (100 Mbps) | Dimensione del file | Caricamento | Preelaborazione | Totale |
|---|---|---|---|---|
| Parquet | 301 MB | 30s | 1.5 min | ~2 min |
| ORC | 395 MB | 40s | 1.5 min | ~2.2 min |
| CSV | 2.2 GB | 4 min | 1.5 min | ~5.5 min |
| CSV.GZ | 215 MB | 21s | 2 min | ~2.5 min |
| 50M eventi (100 Mbps) | Dimensione del file | Caricamento | Preelaborazione | Totale |
|---|---|---|---|---|
| Parquet | 1.7 GB | 3 min | 2 min | ~5 min |
| ORC | 1.9 GB | 3.2 min | 2 min | ~5.2 min |
| CSV | 11.1 GB | 18 min | 2 min | ~20 min |
| CSV.GZ | 1.1 GB | 2 min | 3 min | ~5 min |
Per gli insiemi di dati di grandi dimensioni, Parquet e ORC riducono i tempi di trasferimento grazie alle dimensioni più contenute dei file. CSV resta una soluzione semplice per gli insiemi di dati più piccoli o quando il processo di esportazione non supporta i formati colonnari. CSV.GZ può ridurre i tempi di trasferimento con una connessione lenta, ma il costo della decompressione aumenta con le dimensioni dell’insieme di dati.
Scelta del formato dei file
- Parquet: Una buona scelta predefinita per gli insiemi di dati di grandi dimensioni, se la pipeline dei dati lo supporta. In queste prove ha prodotto i file più piccoli.
- ORC: Un’alternativa simile, particolarmente adatta se la pipeline dei dati utilizza Hadoop o Spark.
- CSV: Semplice e ampiamente supportato, può essere pratico per gli insiemi di dati più piccoli.
- CSV.GZ: Lo consideri se la velocità di caricamento è il principale limite. Verifichi i tempi di preelaborazione con i Suoi dati, soprattutto quando il numero di eventi è elevato.
Quali schemi di query possono rallentare l’analisi?
Alcune strutture dei dati e delle Dashboard richiedono più elaborazione di altre. Questi controlli aiutano a individuare le possibili cause di query più lente.
- Troppe attività: Un flusso di processo con più di 50 attività distinte può richiedere più tempo per il calcolo e risultare difficile da interpretare. Raggruppi i passaggi correlati, se opportuno.
- Molte varianti diverse: Quando i casi seguono molti percorsi diversi, il calcolo delle varianti richiede più lavoro. Un’elevata variabilità può anche indicare comportamenti del processo da approfondire.
- Casi lunghi: I casi con molti eventi richiedono più elaborazione di quelli brevi.
- Colonne non necessarie: Gli attributi aggiuntivi aumentano le dimensioni del file e possono richiedere più elaborazione quando vengono interrogati. Mantenga solo i campi utili all’analisi.
- Dashboard troppo affollate: Ogni grafico o riquadro esegue una propria query. Mantenga i componenti che rispondono a una domanda precisa e sposti le altre viste in una Dashboard separata.
- Visualizzazioni che richiedono molta elaborazione: Con insiemi di dati di grandi dimensioni, i grafici con molte categorie possono richiedere più tempo per essere visualizzati. Utilizzi una vista riepilogativa quando non serve una suddivisione dettagliata.
- Animazione con molti casi attivi: Il tempo dell’animazione dipende dal numero di casi visualizzati. Riduca la velocità o disattivi le scie e gli effetti se desidera solo osservare il flusso.
Come scegliere la dimensione giusta dell’insieme di dati?
Inizi con l’insieme di dati più piccolo che consente di rispondere alla Sua domanda. Un insieme mirato si carica più rapidamente ed è più semplice da convalidare. Lo ampli quando servono una copertura più ampia, eventi rari o tendenze di lungo periodo.
Sviluppi e convalidi il modello con un insieme di dati più piccolo
Inizi con un campione recente, configuri il modello e controlli i dati prima di aumentare le dimensioni dell’insieme.
- Inizi con un campione. Per esempio, estragga 1 milione di eventi da un periodo recente di tre mesi. Nel benchmark, il caricamento ha richiesto 3 secondi a 1 Gbps o 22 secondi a 100 Mbps, seguiti da 55 secondi di preelaborazione.
- Crei il modello. Configuri le attività, i filtri e le viste. Nei test, le modifiche al modello hanno richiesto circa 14–20 secondi per insiemi da 1 a 10 milioni di eventi.
- Convalidi i risultati. Verifichi che i nomi delle attività e i percorsi del processo siano corretti e risolva eventuali problemi di qualità dei dati.
- Aggiunga altri dati, se necessario. Aumenti il numero di eventi quando deve analizzare casi rari o confrontare periodi più lunghi.
La tabella confronta l’attesa iniziale per diversi numeri di eventi con una connessione a 100 Mbps.
| Approccio | Caricamento (100 Mbps) | Preelaborazione | Attesa totale | Velocità della Dashboard |
|---|---|---|---|---|
| Inizio con 1M eventi | 22s | 55s | ~1.5 min | 1–2s |
| Inizio con 5M eventi | 2 min | 1.5 min | ~3.5 min | 1–2.5s |
| Inizio con 50M eventi | 18 min | 2 min | ~20 min | 1–6s |
Il numero di eventi più adatto dipende dalla domanda. Un insieme di dati più piccolo può bastare per analizzare i modelli di processo più comuni, ma potrebbe servire una quantità maggiore di dati per studiare eventi rari o garantire la copertura dell’intera popolazione.
Segmenti i dati quando la domanda è specifica
Se sta analizzando un Paese, un reparto o una linea di prodotti specifici, inizi da quel segmento anziché combinare gruppi non correlati. La segmentazione può rendere più chiari i confronti e ridurre la quantità di dati da elaborare.
Per esempio, il benchmark descrive un insieme di dati logistici europei con 42 milioni di eventi di spedizione distribuiti in 8 Paesi:
- Tutti i Paesi: 42 milioni di eventi, 9,3 GB, 16 minuti per il caricamento a 100 Mbps e 2 minuti per la preelaborazione.
- Germania: 8,5 milioni di eventi, 1,9 GB, 3 minuti per il caricamento e 1,5 minuti per la preelaborazione.
- Paesi Bassi: 3,1 milioni di eventi, 690 MB, 1 minuto per il caricamento e 1 minuto per la preelaborazione.
Dopo aver convalidato ciascun segmento, può confrontarli. Tra le dimensioni utili rientrano area geografica, organizzazione, prodotto, periodo e segmento di clientela.
Filtri i casi che Le servono
Se sta analizzando le eccezioni, esportare solo i casi pertinenti può ridurre notevolmente l’insieme di dati. Per esempio, il benchmark descrive un processo di acquisto-pagamento con 1,2 milioni di ordini di acquisto e 8,4 milioni di eventi. Secondo i dati riportati, 96.000 ordini, pari all’8%, presentavano eccezioni come rifiuti, resi, fatture duplicate o approvazioni mancanti.
Per questa analisi, esportare i casi con eccezioni riduce l’insieme di dati da 8,4 milioni a 670.000 eventi. La dimensione del file scende da 1,9 GB a 150 MB e il tempo di caricamento a 100 Mbps passa da 3 minuti a 15 secondi. Nel benchmark, il caricamento degli stessi dati in un file Parquet da 15 MB richiede meno di 2 secondi.
Filtri i dati per stato, attività, durata del caso, periodo o unità aziendale, quando questi campi sono pertinenti alla domanda che sta analizzando.
Selezioni solo le colonne necessarie
Ogni colonna contribuisce alle dimensioni del file. I campi di testo lunghi, gli identificativi ridondanti, i campi di audit e i metadati tecnici potrebbero non essere utili all’analisi.
Il benchmark descrive un’esportazione SAP di 1,8 milioni di eventi relativi a ordini di acquisto, con 45 colonne. Riducendo il file a 12 colonne essenziali, le dimensioni sono passate da 2,1 GB a 380 MB. Esportando queste colonne in formato Parquet, si sono ridotte ulteriormente a 58 MB. Il tempo di caricamento a 100 Mbps è sceso, secondo i dati riportati, da 3,5 minuti a 6 secondi.
Mantenga i campi utili all’analisi, tra cui CaseId, Activity, Timestamp e gli attributi aziendali pertinenti, come stato, importo, categoria o area geografica. Rimuova le informazioni personali quando non sono necessarie per l’analisi.
Quando è opportuno utilizzare un insieme di dati più grande?
Un numero maggiore di eventi può essere necessario quando la domanda dipende dall’ampiezza della copertura o dal periodo analizzato.
- Eventi rari: Per individuare eccezioni che si verificano una volta ogni 100.000 casi, serve una popolazione abbastanza ampia da includerle. Se un’eccezione si verifica nello 0,01% dei casi e desidera analizzarne 50, occorrono circa 500.000 casi.
- Varianti poco frequenti: Le varianti che si verificano nello 0,1% dei casi possono non emergere in un campione di 1 milione di eventi, ma risultare chiaramente misurabili in una popolazione di 50 milioni di eventi.
- Conformità e audit: Alcuni requisiti richiedono la copertura dell’intera popolazione anziché un campione.
- Tendenze di lungo periodo: Per confrontare il primo trimestre del 2024 con lo stesso periodo del 2025 e del 2026, servono i dati di tutti e tre i periodi. Il caricamento incrementale consente di ampliare gradualmente la copertura.
Per gli insiemi di dati con oltre 50 milioni di eventi, il benchmark consiglia di utilizzare Parquet, caricare i dati tramite API e, se disponibile, usare una connessione di rete veloce. Nel test, il file CSV con 50 milioni di eventi era di 11,1 GB, rispetto a 1,7 GB per il file Parquet.
Le prestazioni comportano sempre un compromesso: più dati e maggiore velocità hanno un costo. La domanda giusta non è cosa può fare uno strumento, ma di cosa ha bisogno il Suo processo. ProcessMind può gestire volumi molto elevati, ma sconsigliamo comunque di utilizzare insiemi di dati enormi, spesso non necessari e abbastanza complessi da distogliere l’attenzione dal miglioramento stesso.
Come mantenere reattivi il modello e l’interfaccia?
Il volume dei dati è solo una parte del quadro. Anche il modello di processo e la struttura della Dashboard incidono sulla rapidità del lavoro.
- Mantenga il modello leggibile: Suddivida i processi più ampi in Subprocesses modulari. Una tela con molti elementi visibili può richiedere più tempo per il rendering ed essere più difficile da esplorare. Utilizzi auto-layout dopo le modifiche strutturali.
- Scelga con cura i componenti della Dashboard: Ogni grafico e riquadro richiede un calcolo. Mantenga le viste che rispondono alle domande che si sta ponendo.
- Utilizzi grafici adatti ai dati: Con insiemi di dati di grandi dimensioni, una visualizzazione con molte categorie può richiedere più tempo per il calcolo. Utilizzi un riepilogo quando non serve una suddivisione dettagliata.
- Limiti i filtri alla domanda: I filtri aiutano a circoscrivere l’analisi. Eviti di combinare filtri che non contribuiscono a rispondere alla domanda.
- Regoli le impostazioni dell’animazione: Il costo dell’animazione aumenta con il numero di casi attivi. Riduca la velocità o disattivi le scie e gli effetti se desidera solo osservare il flusso. Consulti Animazione del processo.
- Ricalcoli solo ciò che è cambiato: Le modifiche al modello aggiornano i calcoli che ne dipendono senza ripetere l’intera fase di preelaborazione. Nel benchmark, le modifiche hanno richiesto da circa 14 secondi per 1 milione di eventi a 52 secondi per 100 milioni di eventi.
In che modo il caricamento incrementale riduce i tempi di caricamento?
Il caricamento incrementale consente di aggiungere nuovi eventi a un insieme di dati esistente, senza doverlo caricare di nuovo per intero. Quando aggiorna un Event Log in crescita, riduce la quantità di dati trasferiti.
| Scenario | Nuovo caricamento completo | Caricamento incrementale | Tempo risparmiato |
|---|---|---|---|
| 10M di base + 500K nuovi eventi (100 Mbps) | 4 min di caricamento | 5s di caricamento | ~4 min |
| 20M di base + 2M nuovi eventi (100 Mbps) | 7 min di caricamento | 44s di caricamento | ~6 min |
| 50M di base + 5M nuovi eventi (100 Mbps) | 18 min di caricamento | 2 min di caricamento | ~16 min |
Dopo un caricamento incrementale, la preelaborazione viene eseguita di nuovo sull’insieme di dati combinato. Nel benchmark ha richiesto da 1 a 2,5 minuti. Il risparmio sui tempi di caricamento deriva dal trasferimento dei soli nuovi eventi.
Il file incrementale deve utilizzare lo stesso formato e la stessa struttura di colonne del caricamento originale. Per maggiori dettagli, consulti la guida al caricamento incrementale dei dati.
Quando è opportuno caricare i dati tramite API?
Per i caricamenti ricorrenti o per i file di diversi gigabyte, il caricamento tramite API può essere più semplice da gestire rispetto al trasferimento dal browser. Uno script o uno strumento da riga di comando può integrarsi in una pipeline ETL, consentire caricamenti pianificati e mostrare l’avanzamento del trasferimento.
ProcessMind fornisce URL presigned per caricare i dati direttamente nell’archiviazione cloud. Può copiare l’URL di caricamento dal menu delle impostazioni dell’insieme di dati nell’interfaccia di ProcessMind.
# Upload a Parquet file directly using a presigned URL
curl -X PUT "$PRESIGNED_URL" --upload-file data.parquet
Consulti la documentazione dell’API per esempi in Bash, JavaScript e Python, anche per ottenere URL presigned e caricare file incrementali.
Quando è opportuno suddividere un insieme di dati?
Suddivida un insieme di dati quando un’analisi specifica richiede solo una parte dei dati o quando è necessario confrontare gruppi distinti separatamente. Può segmentare i dati per area geografica, reparto, linea di prodotti, periodo o tipo di caso, quindi analizzare ciascun insieme separatamente.
Mantenga i dati insieme quando la domanda richiede di confrontare i gruppi o seguire l’intero processo attraverso di essi. Prima di suddividerli, verifichi che la separazione non alteri il significato del caso né escluda eventi necessari per comprenderne il percorso. Per esempio, una suddivisione temporale dovrebbe tenere conto dei casi che iniziano in un periodo e terminano in un altro.
Verifichi le prestazioni con i Suoi dati
I benchmark aiutano a pianificare, ma non consentono di prevedere i risultati per ogni Event Log, rete o query. Provi l’insieme di dati che prevede di utilizzare, quindi controlli i tempi di caricamento e preelaborazione e i tempi di risposta delle viste della Dashboard che Le interessano.
Consulti prima le indicazioni sulla preparazione dei dati se ha bisogno di aiuto per strutturare l’Event Log. Può anche rivedere come analizzare il processo e come monitorare continuamente il processo.