Výkon process mining: srovnávací testy a doporučení
Zjistěte, jak objem dat, formát souboru a typ dotazu ovlivňují výkon process mining. Článek uvádí výsledky testů z března 2026 pro 100 tisíc až 100 milionů událostí.

Výkon process mining nezávisí jen na počtu událostí. Dobu čekání ovlivňuje také velikost souboru, počet případů, typ dotazu a rychlost připojení. Níže uvedené testy zahrnují datové sady se 100 tisíci až 100 miliony událostí. Proběhly v březnu 2026 na produkční infrastruktuře AWS. Použité formáty souborů a podmínky testování popisujeme níže.
Hlavní poznatky
- U velkých souborů nebo pomalého připojení může dobu čekání nejvíce prodloužit nahrávání.
- Soubory Parquet a ORC jsou mnohem menší než nekomprimované CSV, takže se přenášejí rychleji.
- Doba odezvy dashboardu závisí na dotazu. Statistiky se načítají rychle, zatímco výpočet toků procesu se s rostoucím počtem událostí prodlužuje.
- Přírůstkové načítání přenese nové události bez nutnosti znovu nahrávat celou datovou sadu.
- Menší, cílená datová sada se rychleji nahrává a snáze analyzuje.
Co ovlivňuje výkon process mining?
Výkon ovlivňují čtyři faktory: množství dat, struktura záznamu událostí, spouštěný dotaz a prostředí, ve kterém se data přenášejí a zpracovávají.
- Počet událostí a případů: Více událostí obvykle znamená více dat k nahrání a zpracování. Počet případů určuje, kolik instancí procesu analýza zahrnuje.
- Typ dotazu: Souhrnná statistika a tok procesu vyžadují odlišné výpočty. Dotazy, které počítají přechody mezi aktivitami, mohou trvat déle než dotazy nad předem agregovanými daty.
- Počet aktivit a délka případů: Více různých aktivit a delší případy zvyšují náročnost výpočtu toků a variant.
- Velikost souboru a rychlost sítě: Tyto faktory určují dobu nahrávání. Rozsáhlý soubor CSV s dlouhými textovými poli může být mnohem větší než kompaktní sloupcový soubor se stejnými událostmi.
Samotný počet událostí nestačí k odhadu doby zpracování datové sady. Berte výsledky testů jako orientační hodnoty a vyzkoušejte vlastní záznam událostí i dotazy, které plánujete používat. Právě tak nejlépe zjistíte, jaký výkon process mining očekávat ve vašem prostředí.
Datová pipeline: kde se ztrácí čas?
Datová sada prochází třemi fázemi: nahráním, předzpracováním a přepočtem při změně modelu procesu.
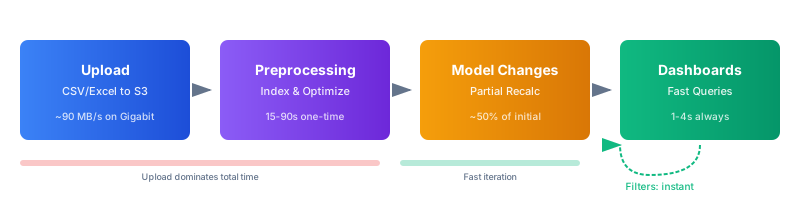
- Nahrávání: Soubor se přes internet přenese do cloudové infrastruktury ProcessMind. Dobu přenosu určuje rychlost sítě a velikost souboru. Například nahrání souboru CSV s 50 miliony událostí o velikosti 11 GB trvá při rychlosti 1 Gb/s přibližně 2 minuty, při 100 Mb/s 18 minut a při 10 Mb/s více než 3 hodiny. Stejná data v souboru Parquet o velikosti 1,7 GB se při těchto rychlostech nahrají přibližně za 19 sekund, 3 minuty, respektive 28 minut.
- Předzpracování: Po nahrání systém převede data do optimalizovaného sloupcového úložiště, vytvoří index událostí, vypočítá přechody mezi aktivitami a varianty procesu a vygeneruje souhrnné statistiky. V níže uvedených testech trvalo předzpracování 35 sekund u 100 tisíc událostí a až 2,5 minuty u 100 milionů událostí.
- Změny modelu: Když změníte mapování aktivit nebo aktivity přidáte či odeberete, ProcessMind aktualizuje výpočty závislé na modelu. V níže uvedených testech to trvalo přibližně 14 sekund u 1 milionu událostí a 52 sekund u 100 milionů událostí. Změny filtrů se projeví okamžitě.
U velkých datových sad bývá nejúčinnějším způsobem, jak zkrátit počáteční čekání, zmenšení souboru. Po předzpracování závisí rychlost dotazů na tom, co musí dashboard vypočítat.
Jak se liší rychlost dotazů?
Různé dotazy mají různou výpočetní náročnost. Následující faktory vám pomohou odhadnout, co čekat a jak připravit data.
- Počet aktivit: Modely s 10–20 různými aktivitami se snáze analyzují a zobrazují. Při více než 50 aktivitách trvá výpočet procesních toků déle a hůře se čtou. Související kroky seskupujte jen tehdy, pokud to odpovídá skutečnému průběhu procesu.
- Rozmanitost variant: Proces, v němž většina případů sleduje jen několik málo cest, se obvykle analyzuje rychleji než proces, kde má každý případ jiný průběh. Velké rozdíly mohou být důležité, ale mohou prodloužit dobu zpracování dotazu.
- Počet sloupců: Pro analýzu procesu jsou potřeba základní pole CaseId, Activity a Timestamp. Další atributy umožňují filtrování a kategorizaci, zvyšují však objem dat, která je třeba přenést a prohledat.
- Délka případu: Případ s 50 událostmi vyžaduje více zpracování než případ s 5 událostmi. Dotazy mohou trvat déle u procesů, jejichž případy obsahují stovky událostí.
Doba odezvy dashboardu
Uvedené mediány vycházejí z několika běhů testů. Každá součást dashboardu spouští vlastní dotaz a načítá se souběžně s ostatními.
| Datová sada | Statistiky | Tok procesu | Varianty | Kategorie | Prohlížeč dat | Animace |
|---|---|---|---|---|---|---|
| 100K | 0.6s | 1.5s | 1.1s | 1.5s | 1.2s | 1.4s |
| 1M | 0.6s | 1.6s | 1.4s | 1.9s | 1.5s | 2.0s |
| 5M | 0.6s | 2.5s | 1.8s | 2.4s | 1.3s | 2.1s |
| 10M | 0.6s | 3.4s | 2.2s | 2.5s | 1.6s | 2.4s |
| 20M | 0.6s | 3.9s | 2.7s | 3.3s | 1.9s | 3.6s |
| 50M | 0.6s | 5.1s | 4.2s | 5.7s | 1.6s | 2.7s |
| 100M | 0.6s | 7.2s | 3.5s | 4.7s | 1.6s | 5.0s |
Statistiky se u všech testovaných velikostí načítaly přibližně za 0,6 sekundy. Tok procesu se s rostoucím počtem událostí zpomaloval, protože počítá přechody mezi aktivitami. Výpočty variant a kategorií se prodlužovaly mírně, zatímco Prohlížeč dat zůstal díky stránkování svižný. Doba animace se měnila podle počtu zobrazených aktivních případů.
U 1 až 10 milionů událostí se naměřená doba odezvy podle součásti dashboardu pohybovala od 0,6 do 3,4 sekundy. U 50 milionů událostí trvaly Tok procesu a Kategorie přibližně 5 až 6 sekund. Jde o výsledky testů, nikoli o záruku pro každou datovou sadu nebo prostředí.
Výsledky testů: za jakých podmínek probíhaly?
Testy proběhly v březnu 2026 na produkční infrastruktuře AWS. Doby nahrávání a předzpracování jsou průměry z několika testů. Doby odezvy dashboardu jsou mediány z několika běhů. Testování zahrnovalo více než 50 typů dotazů pro každou velikost datové sady.
Níže uvedené počty událostí odpovídají skutečným počtům v testovacích souborech. Velikosti souborů se vztahují k nekomprimovaným souborům CSV s obvyklou strukturou záznamu událostí: CaseId, Activity, Timestamp a 5–8 obchodních atributů. Velikost vašeho souboru i výsledky se budou lišit podle počtu sloupců, obsahu, podmínek sítě, vzdálenosti od datového centra a aktuálního vytížení.
Doba nahrávání a předzpracování
| Datová sada | Skutečný počet událostí | Velikost souboru | Nahrávání (1 Gb/s) | Nahrávání (100 Mb/s) | Nahrávání (50 Mb/s) | Nahrávání (10 Mb/s) | Předzpracování |
|---|---|---|---|---|---|---|---|
| 100K | 125,260 | 22 MB | < 1s | 2s | 4s | 22s | 35s |
| 500K | 626,300 | 110 MB | 1s | 11s | 22s | 2 min | 45s |
| 1M | 1,253,424 | 221 MB | 3s | 22s | 44s | 4 min | 55s |
| 2M | 2,506,848 | 443 MB | 5s | 44s | 1.5 min | 7 min | 1 min |
| 5M | 4,996,877 | 1.1 GB | 13s | 2 min | 4 min | 18 min | 1.5 min |
| 10M | 12,511,867 | 2.2 GB | 25s | 4 min | 7 min | 37 min | 1.5 min |
| 20M | 25,023,734 | 4.4 GB | 50s | 7 min | 15 min | 1.2 hr | 2 min |
| 50M | 62,559,335 | 11.1 GB | 2 min | 18 min | 37 min | 3 hr | 2 min |
| 100M | 125,118,670 | 22.3 GB | 4 min | 37 min | 1.2 hr | 6 hr | 2.5 min |
Při měření dosáhla rychlost přenosu do AWS eu-central-1 hodnoty 88 MB/s při připojení 1 Gb/s. Ostatní rychlosti jsou odhadnuté podle praktických přenosových rychlostí: přibližně 5 MB/s při 50 Mb/s, 10 MB/s při 100 Mb/s a 1 MB/s při 10 Mb/s. Skutečná rychlost závisí na vaší síti a podmínkách přenosu.
V tomto testu trvalo předzpracování 35 sekund až 2,5 minuty. Doba nahrávání rostla s velikostí souboru, takže u velkých souborů tvořila největší část čekání.
Formáty souborů: Parquet a ORC oproti CSV
ProcessMind podporuje formáty CSV, Parquet, ORC, Excel a XES. Toto porovnání velikostí souborů používá stejné počty událostí a stejné schéma jako výše uvedené testy.
| Datová sada | CSV | Parquet | ORC | CSV.GZ |
|---|---|---|---|---|
| 1M událostí | 221 MB | 34 MB | 39 MB | 20 MB |
| 5M událostí | 1.1 GB | 151 MB | 197 MB | 107 MB |
| 10M událostí | 2.2 GB | 301 MB | 395 MB | 215 MB |
| 20M událostí | 4.4 GB | 603 MB | 791 MB | 430 MB |
| 50M událostí | 11.1 GB | 1.7 GB | 1.9 GB | 1.1 GB |
| 100M událostí | 22.3 GB | 3.4 GB | 3.7 GB | 2.2 GB |
V těchto testech byly soubory Parquet přibližně o 85 % menší než CSV a soubory ORC přibližně o 82 %. Oba formáty ukládají data po sloupcích a mají vestavěnou kompresi. Datové nástroje, jako jsou Spark, Databricks, dbt a BigQuery, mohou podporovat export do těchto formátů.
Doba předzpracování byla u formátů Parquet, ORC a CSV podobná. U CSV.GZ trvala u většího počtu událostí déle, protože soubory gzip nelze rozdělit pro paralelní dekompresi.
| Datová sada | Parquet | ORC | CSV | CSV.GZ |
|---|---|---|---|---|
| 1M událostí | 55s | 55s | 55s | 55s |
| 5M událostí | 1.5 min | 1.5 min | 1.5 min | 1.5 min |
| 10M událostí | 1.5 min | 1.5 min | 1.5 min | 2 min |
| 20M událostí | 2 min | 2 min | 2 min | 2.5 min |
| 50M událostí | 2 min | 2 min | 2 min | 3 min |
| 100M událostí | 2.5 min | 2.5 min | 2.5 min | 4.5 min |
Celková doba zahrnuje nahrávání i předzpracování. Následující příklady počítají s připojením o rychlosti 100 Mb/s.
| 10M událostí (100 Mb/s) | Velikost souboru | Nahrávání | Předzpracování | Celkem |
|---|---|---|---|---|
| Parquet | 301 MB | 30s | 1.5 min | ~2 min |
| ORC | 395 MB | 40s | 1.5 min | ~2.2 min |
| CSV | 2.2 GB | 4 min | 1.5 min | ~5.5 min |
| CSV.GZ | 215 MB | 21s | 2 min | ~2.5 min |
| 50M událostí (100 Mb/s) | Velikost souboru | Nahrávání | Předzpracování | Celkem |
|---|---|---|---|---|
| Parquet | 1.7 GB | 3 min | 2 min | ~5 min |
| ORC | 1.9 GB | 3.2 min | 2 min | ~5.2 min |
| CSV | 11.1 GB | 18 min | 2 min | ~20 min |
| CSV.GZ | 1.1 GB | 2 min | 3 min | ~5 min |
U velkých datových sad zkracují Parquet a ORC dobu přenosu díky menší velikosti souborů. CSV je stále jednoduchou volbou pro menší datové sady nebo v případě, že váš export nepodporuje sloupcové formáty. CSV.GZ může při pomalém připojení zkrátit dobu přenosu, jeho dekomprese však s rostoucím objemem dat trvá déle.
Výběr formátu souboru
- Parquet: Dobrá výchozí volba pro velké datové sady, pokud ho vaše datová pipeline podporuje. V těchto testech vytvořil nejmenší soubory.
- ORC: Podobná možnost, zejména pokud vaše datová pipeline využívá Hadoop nebo Spark.
- CSV: Jednoduchý a široce podporovaný formát, který se hodí pro menší datové sady.
- CSV.GZ: Zvažte ho, pokud vás nejvíc omezuje rychlost nahrávání. U vlastních dat si ověřte dobu předzpracování, zejména u většího počtu událostí.
Které typy dotazů mohou zpomalit analýzu?
Některé typy dat a uspořádání dashboardu vyžadují více výpočtů než jiné. Pomocí následujících bodů můžete určit pravděpodobné příčiny pomalejších dotazů.
- Příliš mnoho aktivit: Výpočet toku procesu s více než 50 různými aktivitami může trvat déle a výsledek se může hůře interpretovat. Vhodně seskupte související kroky.
- Mnoho jedinečných variant: Pokud případy sledují mnoho různých tras, výpočet variant vyžaduje více práce. Velká variabilita může zároveň ukazovat na chování procesu, které stojí za prozkoumání.
- Dlouhé případy: Zpracování případů s mnoha událostmi vyžaduje více času než u krátkých případů.
- Nepotřebné sloupce: Další atributy zvětšují soubor a mohou přidat práci při zpracování dotazů. Ponechte jen pole potřebná pro analýzu.
- Rozsáhlé a přeplněné dashboardy: Každý graf nebo dlaždice spouští vlastní dotaz. Ponechte jen součásti, které odpovídají na konkrétní otázku, a ostatní pohledy přesuňte na samostatný dashboard.
- Výpočetně náročné vizualizace: U velkých datových sad se grafy s mnoha kategoriemi mohou vykreslovat déle. Pokud nepotřebujete podrobný rozpis, použijte souhrnný pohled.
- Animace s mnoha aktivními případy: Doba animace závisí na počtu zobrazených případů. Pokud potřebujete jen zkontrolovat tok, snižte rychlost nebo vypněte stopy a efekty.
Jak zvolit správný objem dat?
Začněte s nejmenší datovou sadou, která vám pomůže odpovědět na otázku. Cílená datová sada se rychleji nahrává a snáze ověřuje. Rozšiřte ji, pokud potřebujete širší pokrytí, vzácné události nebo dlouhodobější trendy.
Vytvořte a ověřte model na menší datové sadě
Začněte s nedávným vzorkem, nakonfigurujte model a zkontrolujte data, než jejich objem zvětšíte.
- Začněte se vzorkem. Například vyberte 1 milion událostí z posledních tří měsíců. V testu trvalo nahrání při rychlosti 1 Gb/s 3 sekundy a při 100 Mb/s 22 sekund. Předzpracování pak zabralo 55 sekund.
- Vytvořte model. Nakonfigurujte aktivity, filtry a pohledy. Změny modelu u testovaných datových sad s 1 až 10 miliony událostí trvaly přibližně 14 až 20 sekund.
- Ověřte výsledky. Zkontrolujte, zda názvy aktivit a trasy procesu dávají smysl, a vyřešte případné problémy s kvalitou dat.
- Podle potřeby přidejte další data. Zvyšte počet událostí, pokud potřebujete zkoumat vzácné případy nebo porovnávat delší časová období.
Tabulka porovnává počáteční dobu čekání při různém počtu událostí a připojení o rychlosti 100 Mb/s.
| Postup | Nahrávání (100 Mb/s) | Předzpracování | Celková doba čekání | Rychlost dashboardu |
|---|---|---|---|---|
| Začít s 1M událostí | 22s | 55s | ~1.5 min | 1–2s |
| Začít s 5M událostí | 2 min | 1.5 min | ~3.5 min | 1–2.5s |
| Začít s 50M událostí | 18 min | 2 min | ~20 min | 1–6s |
Vhodný počet událostí závisí na vaší otázce. Pro běžné vzorce v procesu může stačit menší datová sada. Ke zkoumání vzácných událostí nebo splnění požadavku na pokrytí celé populace ale možná budete potřebovat více dat.
Pokud řešíte konkrétní otázku, rozdělte data do segmentů
Pokud zkoumáte jednu zemi, oddělení nebo produktovou řadu, začněte s tímto segmentem místo spojování nesouvisejících skupin. Rozdělení na segmenty zpřehlední porovnání a sníží objem dat, která je třeba zpracovat.
Například srovnávací test popisuje evropskou datovou sadu z logistiky s 42 miliony událostí zásilek v 8 zemích:
- Všechny země: 42 milionů událostí, 9,3 GB, nahrání při 100 Mb/s trvá 16 minut a předzpracování 2 minuty.
- Německo: 8,5 milionu událostí, 1,9 GB, nahrání trvá 3 minuty a předzpracování 1,5 minuty.
- Nizozemsko: 3,1 milionu událostí, 690 MB, nahrání trvá 1 minutu a předzpracování 1 minutu.
Po ověření jednotlivých segmentů je můžete porovnat. Vhodnými kritérii jsou například zeměpisná oblast, organizace, produkt, období a skupina zákazníků.
Vyberte jen potřebné případy
Pokud zkoumáte výjimky, export pouze relevantních případů může datovou sadu výrazně zmenšit. Srovnávací test například popisuje proces nákupu a platby s 1,2 milionu objednávek a 8,4 milionu událostí. Podle výsledků se u 96 000 objednávek, tedy 8 %, vyskytly výjimky, například zamítnutí, vrácení, duplicitní faktury nebo chybějící schválení.
V této analýze se exportem případů s výjimkami zmenší datová sada z 8,4 milionu na 670 tisíc událostí. Uvedená velikost souboru klesne z 1,9 GB na 150 MB a doba nahrávání při 100 Mb/s z 3 minut na 15 sekund. Export stejných dat do souboru Parquet o velikosti 15 MB se podle testu nahraje za méně než 2 sekundy.
Filtrujte podle stavu, aktivity, délky případu, období nebo obchodní jednotky, pokud tato pole odpovídají otázce, kterou řešíte.
Vyberte jen potřebné sloupce
Každý sloupec zvětšuje soubor. Dlouhá textová pole, nadbytečné identifikátory, auditní pole a technická metadata nemusí být pro analýzu užitečné.
Srovnávací test popisuje export ze SAP s 1,8 milionu událostí nákupních objednávek a 45 sloupci. Počet sloupců se zredukoval na 12 potřebných a velikost souboru klesla z 2,1 GB na 380 MB. Export těchto sloupců do formátu Parquet ji snížil ještě více, na 58 MB. Uvedená doba nahrávání při 100 Mb/s se zkrátila z 3,5 minuty na 6 sekund.
Ponechte pole potřebná pro analýzu, například CaseId, Activity, Timestamp a relevantní obchodní atributy, jako jsou stav, částka, kategorie nebo region. Osobní údaje odstraňte, pokud je k analýze nepotřebujete.
Kdy použít větší datovou sadu?
Větší počet událostí může být potřeba, pokud vaše otázka závisí na pokrytí dat nebo délce sledovaného období.
- Vzácné události: Chcete-li najít výjimky, které nastanou jednou ze 100 000 případů, potřebujete dostatečně velký soubor dat, aby je obsahoval. Pokud k výjimce dochází v 0,01 % případů a chcete jich prozkoumat 50, potřebujete přibližně 500 tisíc případů.
- Málo časté varianty: Varianty, které se vyskytují v 0,1 % případů, nemusí být ve vzorku s 1 milionem událostí vůbec viditelné, ale v souboru s 50 miliony událostí je lze spolehlivě měřit.
- Shoda a audit: Některé požadavky vyžadují úplné pokrytí dat, nikoli výběrový vzorek.
- Dlouhodobé trendy: Porovnání 1. čtvrtletí 2024, 2025 a 2026 vyžaduje data ze všech tří období. Při postupném načítání se potřebné pokrytí buduje průběžně.
U datových sad s více než 50 miliony událostí benchmark doporučuje použít Parquet, nahrávat data přes API a pokud možno využít rychlé síťové připojení. Soubor CSV s 50 miliony událostí použitý v testu měl 11,1 GB, zatímco soubor Parquet měl 1,7 GB.
Výkon vždy znamená kompromis: více dat a vyšší rychlost stojí víc. Podstatná otázka není, co nástroj zvládne, ale co potřebuje váš proces. ProcessMind zvládá i velmi rozsáhlá data, přesto nedoporučujeme pracovat s obrovskými datovými sadami, pokud to není nutné. Zbytečně zvyšují složitost a odvádějí pozornost od samotného zlepšování procesů.
Jak udržet model a rozhraní svižné?
Objem dat je jen jedna část. Rychlost práce ovlivňuje také návrh procesního modelu a dashboardu.
- Udržujte model přehledný: Rozdělte rozsáhlé procesy do modulárních Subprocesses. Plátno s mnoha viditelnými prvky se může vykreslovat déle a hůře se v něm orientuje. Po změnách struktury použijte auto-layout.
- Pečlivě vybírejte komponenty dashboardu: Každý graf a dlaždice vyžadují výpočet. Ponechte si pohledy, které odpovídají na vaše aktuální otázky.
- Používejte grafy vhodné pro daná data: U rozsáhlých datových sad může výpočet vizualizace s mnoha kategoriemi trvat déle. Pokud nepotřebujete podrobný rozpad, použijte souhrn.
- Omezte filtry na to, co potřebujete zjistit: Filtry pomáhají zúžit analýzu. Nekombinujte filtry, které nepřispívají k zodpovězení vaší otázky.
- Upravte nastavení animace: Nároky na animaci rostou s počtem aktivních případů. Pokud potřebujete pouze prohlédnout tok, snižte rychlost nebo vypněte stopy a efekty. Další informace najdete v části Process Animation.
- Přepočítávejte jen to, co se změnilo: Změny modelu aktualizují výpočty, které na něm závisejí, aniž by bylo nutné opakovat celé předzpracování. V benchmarku trvaly změny přibližně 14 sekund u 1 milionu událostí a 52 sekund u 100 milionů událostí.
Jak postupné načítání zkracuje dobu nahrávání?
Postupné načítání přidá nové události do existující datové sady, takže nemusíte znovu nahrávat celý soubor. Při aktualizaci rostoucího záznamu událostí se tak přenáší méně dat.
| Scénář | Opětovné nahrání celého souboru | Nahrání přírůstku | Ušetřený čas |
|---|---|---|---|
| 10 milionů původních + 500 tisíc nových událostí (100 Mbps) | nahrávání 4 min | nahrávání 5 s | ~4 min |
| 20 milionů původních + 2 miliony nových událostí (100 Mbps) | nahrávání 7 min | nahrávání 44 s | ~6 min |
| 50 milionů původních + 5 milionů nových událostí (100 Mbps) | nahrávání 18 min | nahrávání 2 min | ~16 min |
Po nahrání přírůstku se předzpracování znovu spustí nad spojenou datovou sadou. V benchmarku trvalo 1 až 2,5 minuty. Čas se ušetří tím, že se přenášejí pouze nové události.
Soubor s přírůstkem musí mít stejný formát a strukturu sloupců jako původní nahraný soubor. Podrobnosti najdete v příručce k postupnému načítání dat.
Kdy nahrávat data přes API?
Při pravidelném nahrávání nebo práci se soubory o velikosti několika gigabajtů se nahrávání přes API spravuje snáz než přenos přes prohlížeč. Skript nebo nástroj příkazového řádku lze začlenit do ETL pipeline, plánovat jeho spouštění a sledovat průběh přenosu.
ProcessMind poskytuje předem podepsané URL pro přímé nahrávání do cloudového úložiště. URL pro nahrání můžete zkopírovat z nabídky nastavení datové sady v uživatelském rozhraní ProcessMind.
# Upload a Parquet file directly using a presigned URL
curl -X PUT "$PRESIGNED_URL" --upload-file data.parquet
Příklady pro Bash, JavaScript a Python najdete v dokumentaci k API. Obsahuje také postup, jak získat předem podepsané URL a nahrát soubory s přírůstky.
Kdy rozdělit datovou sadu?
Datovou sadu rozdělte, pokud konkrétní analýza potřebuje jen její část nebo pokud chcete samostatně porovnat různé skupiny. Data můžete rozdělit podle zeměpisné oblasti, oddělení, produktové řady, období nebo typu případu a každou část analyzovat zvlášť.
Data ponechte pohromadě, pokud potřebujete porovnávat skupiny nebo sledovat celý proces napříč nimi. Před rozdělením ověřte, zda se tím nezmění význam případu nebo neodstraní události potřebné k pochopení jeho průběhu. Při rozdělení podle času například zohledněte případy, které začínají v jednom období a končí v jiném.
Otestujte výkon na vlastních datech
Benchmarky vám pomohou s plánováním, ale nedokážou předpovědět výsledky pro každý záznam událostí, síť ani dotaz. Otestujte datovou sadu, kterou chcete používat, a změřte dobu nahrávání a předzpracování i dobu odezvy důležitých pohledů dashboardu.
Pokud potřebujete upravit záznam událostí, nejprve si přečtěte pokyny k přípravě dat. Podívat se můžete také na analýzu procesu a průběžné monitorování procesu.
Otestujte výkon při objemu dat, který používáte
Načtěte záznam událostí, který chcete analyzovat, a změřte výkon na vlastních datech.