Narzędzia ETL do process mining: co jest potrzebne
Kiedy process mining wymaga ETL, jakie dane powinien zawierać eksport i dlaczego ProcessMind wczytuje wyniki z istniejącego potoku danych.

Czy do process mining potrzebny jest ETL?
Narzędzia ETL pobierają dane z systemów źródłowych, przekształcają je do użytecznej postaci i ładują do analizy. W tym artykule omawiamy, jakich prac ETL naprawdę wymaga projekt process mining i czego można uniknąć. To nie jest poradnik zakupowy dotyczący potoków danych. Jeśli jeden system pozwala wyeksportować dane, a plik zawiera identyfikator sprawy, czynność i znacznik czasu, pierwszą analizę często można przeprowadzić bez potoku, wczytując eksport w obecnej postaci.
To zależy od procesu, obsługujących go systemów i częstotliwości odświeżania analizy. Zacznij od najmniejszego eksportu, który pozwoli odpowiedzieć na konkretne pytanie. Przygotowanie danych i automatyzację dodaj dopiero wtedy, gdy pierwsza analiza pokaże, że są potrzebne.
Są trzy sytuacje, w których warto wykonać prace ETL:
- Proces obejmuje kilka systemów. Trzeba połączyć rekordy i ujednolicić identyfikatory, aby prześledzić sprawę od początku do końca.
- Danych źródłowych nie można od razu wykorzystać. Przed analizą trzeba ujednolicić nazwy czynności, znaczniki czasu lub identyfikatory spraw.
- Eksport trzeba regularnie powtarzać. Jeśli dane zmieniają się codziennie, a analiza musi za nimi nadążać, ręczny eksport przestaje być praktyczny.
To powody, by przygotować dane, a nie by budować potok, zanim padnie pierwsze pytanie. Wczytaj dostępne dane, sprawdź, czego brakuje, i dopiero wtedy zdecyduj o kolejnych krokach.
Przez pewien czas zakładaliśmy, że ETL powinien być częścią produktu. Potem przyjrzeliśmy się temu, z czego już korzystają nasi klienci. Rozwój hurtowni danych trwał około dwudziestu lat i przebiegał pod różnymi nazwami, między innymi data martów i data lake’ów. W efekcie większość firm ma już dostęp do danych, które można wykorzystać. Dlatego zrezygnowaliśmy z budowy własnego potoku. Można przesłać eksport z używanych systemów albo skierować do naszego API potok utrzymywany już przez zespół i zacząć od dostępnych danych.
Osobny potok danych można też pominąć, gdy:
- Proces jest rejestrowany głównie w jednym systemie.
- Można wyeksportować potrzebne rekordy.
- Eksport zawiera identyfikator sprawy, czynność i znacznik czasu.
- Plik jest na tyle mały, że można przygotować go ręcznie.
- Dopiero sprawdzają Państwo, czy dane pozwolą odpowiedzieć na postawione pytanie.
Arkusz kalkulacyjny wystarczy, by zmienić nazwy kolumn, poprawić oczywiste niespójności i usunąć niepotrzebne pola. Ręczne przygotowanie danych nie musi być rozwiązaniem na stałe. Gdy analiza okaże się przydatna, a dane będą wymagały częstego odświeżania, można zautomatyzować powtarzane czynności.
Co powinien zawierać eksport
Dziennik zdarzeń na potrzeby process mining wymaga trzech pól i osobnego wiersza dla każdego zdarzenia.
| Pole | Co oznacza | Co sprawdzić |
|---|---|---|
| Identyfikator sprawy | Instancja procesu, na przykład zamówienie lub zgłoszenie serwisowe | Ten sam identyfikator musi łączyć wszystkie zdarzenia danej instancji |
| Czynność | Krok, który wystąpił w procesie | Nazwy powinny odróżniać rzeczywiste kroki i być stosowane konsekwentnie |
| Znacznik czasu | Kiedy wystąpił dany krok | Prawidłowa data i godzina, z jedną strefą czasową dla łączonych źródeł |
Atrybuty takie jak koszt, użytkownik, zespół, segment klienta czy ślad węglowy CO2 są opcjonalne. To one pozwalają przejść od widoku procesu do jego analizy: każdy zachowany atrybut może później służyć jako filtr, podział lub miara. Opis atrybutów zbioru danych wyjaśnia, do czego można wykorzystać poszczególne pola.
Pole może występować w systemie źródłowym, a mimo to nie nadawać się do użycia. Identyfikator sprawy, który zmienia się między systemami, nie połączy zdarzeń. Niespójne nazwy czynności sprawią, że jeden rzeczywisty krok będzie wyglądał jak trzy różne. Znacznik czasu zapisany jako tekst może zaburzyć kolejność zdarzeń. Przed mapowaniem sprawdź eksport, zaczynając od trzech wymaganych pól. Więcej informacji o tym, co powinien zawierać dziennik, znajdą Państwo w artykule Jakich danych potrzebuje process mining.
Minimalne zapytanie SQL do utworzenia dziennika zdarzeń
Jeśli w systemie źródłowym każdy wiersz odpowiada jednej czynności, wystarczy zapytanie SELECT. Poniższy przykład zakłada tabelę o nazwie process_events, która zawiera sprawę, czynność i czas zdarzenia:
SELECT
  case_id        AS case_id,
  activity_name  AS activity,
  event_time     AS timestamp
FROM process_events
WHERE case_id IS NOT NULL
  AND activity_name IS NOT NULL
  AND event_time IS NOT NULL
ORDER BY case_id, event_time;
Zapytanie nadaje nazwy trzem polom, pomija wiersze, których nie można wykorzystać, i porządkuje zdarzenia w ramach każdej sprawy. Dostosuj nazwy tabel i kolumn do systemu źródłowego, a przed wczytaniem sprawdź próbkę spraw. Każda powinna zawierać oczekiwane zdarzenia w kolejności zgodnej z tym, jak pracują osoby obsługujące proces.
Które przekształcenia danych są potrzebne
Przekształcenia powinny eliminować problemy, które mogłyby zniekształcić analizę. W większości przypadków wystarczą cztery kroki.
-
Ujednolicenie zdarzeń
Zapisz każde wystąpienie czynności w osobnym wierszu, razem z identyfikatorem sprawy i znacznikiem czasu, nawet jeśli system źródłowy przechowuje kroki procesu w osobnych kolumnach. -
Przygotowanie znaczników czasu do analizy
Sprawdź, czy wartości oznaczają prawidłowe daty i godziny oraz czy dotyczą czasu lokalnego, czy UTC. Ujednolić strefy czasowe łączonych źródeł, bo w przeciwnym razie kolejność zdarzeń będzie błędna. -
Ujednolicenie nazw czynności
Każdy rzeczywisty krok powinien mieć jedną nazwę, w jednym języku i z jednolitą pisownią. Nie łącz kroków tylko dlatego, że wyglądają podobnie i pozwoliłoby to skrócić listę. -
Łączenie źródeł tylko wtedy, gdy jest potrzebne
Znajdź klucz łączący rekordy i sprawdź, czy działa prawidłowo. Łączenie, które powiela zdarzenia lub pomija sprawy, zmienia obraz procesu. Porównaj liczbę rekordów przed połączeniem i po nim.
Jeśli eksport zawiera już po jednym wierszu na zdarzenie i wszystkie trzy wymagane pola, nie trzeba niczego przekształcać. To normalna sytuacja, a nie droga na skróty. Jak utworzyć dziennik zdarzeń na potrzeby process mining omawia te same zagadnienia na przykładach z Excela i SQL.
Gdzie wczytać dziennik zdarzeń?
Wczytaj przygotowane dane do platformy, w której będzie prowadzona analiza. Na początek wystarczy jeden plik: przygotuj go, wczytaj, przejrzyj widok procesu i dopracuj eksport, gdy zobaczysz, na co pozwalają dane. Nie twórz nowej warstwy przechowywania wyłącznie na potrzeby process mining. Jeśli zespół już utrzymuje hurtownię lub data lake, pozostaw tam dane i wczytaj plik, który generuje to środowisko.
Szczegóły znajdą Państwo na stronie Obsługiwane formaty danych. Te same formaty można przesyłać zgodnie z harmonogramem przez data API, jeśli pliki nie mają być wczytywane ręcznie.
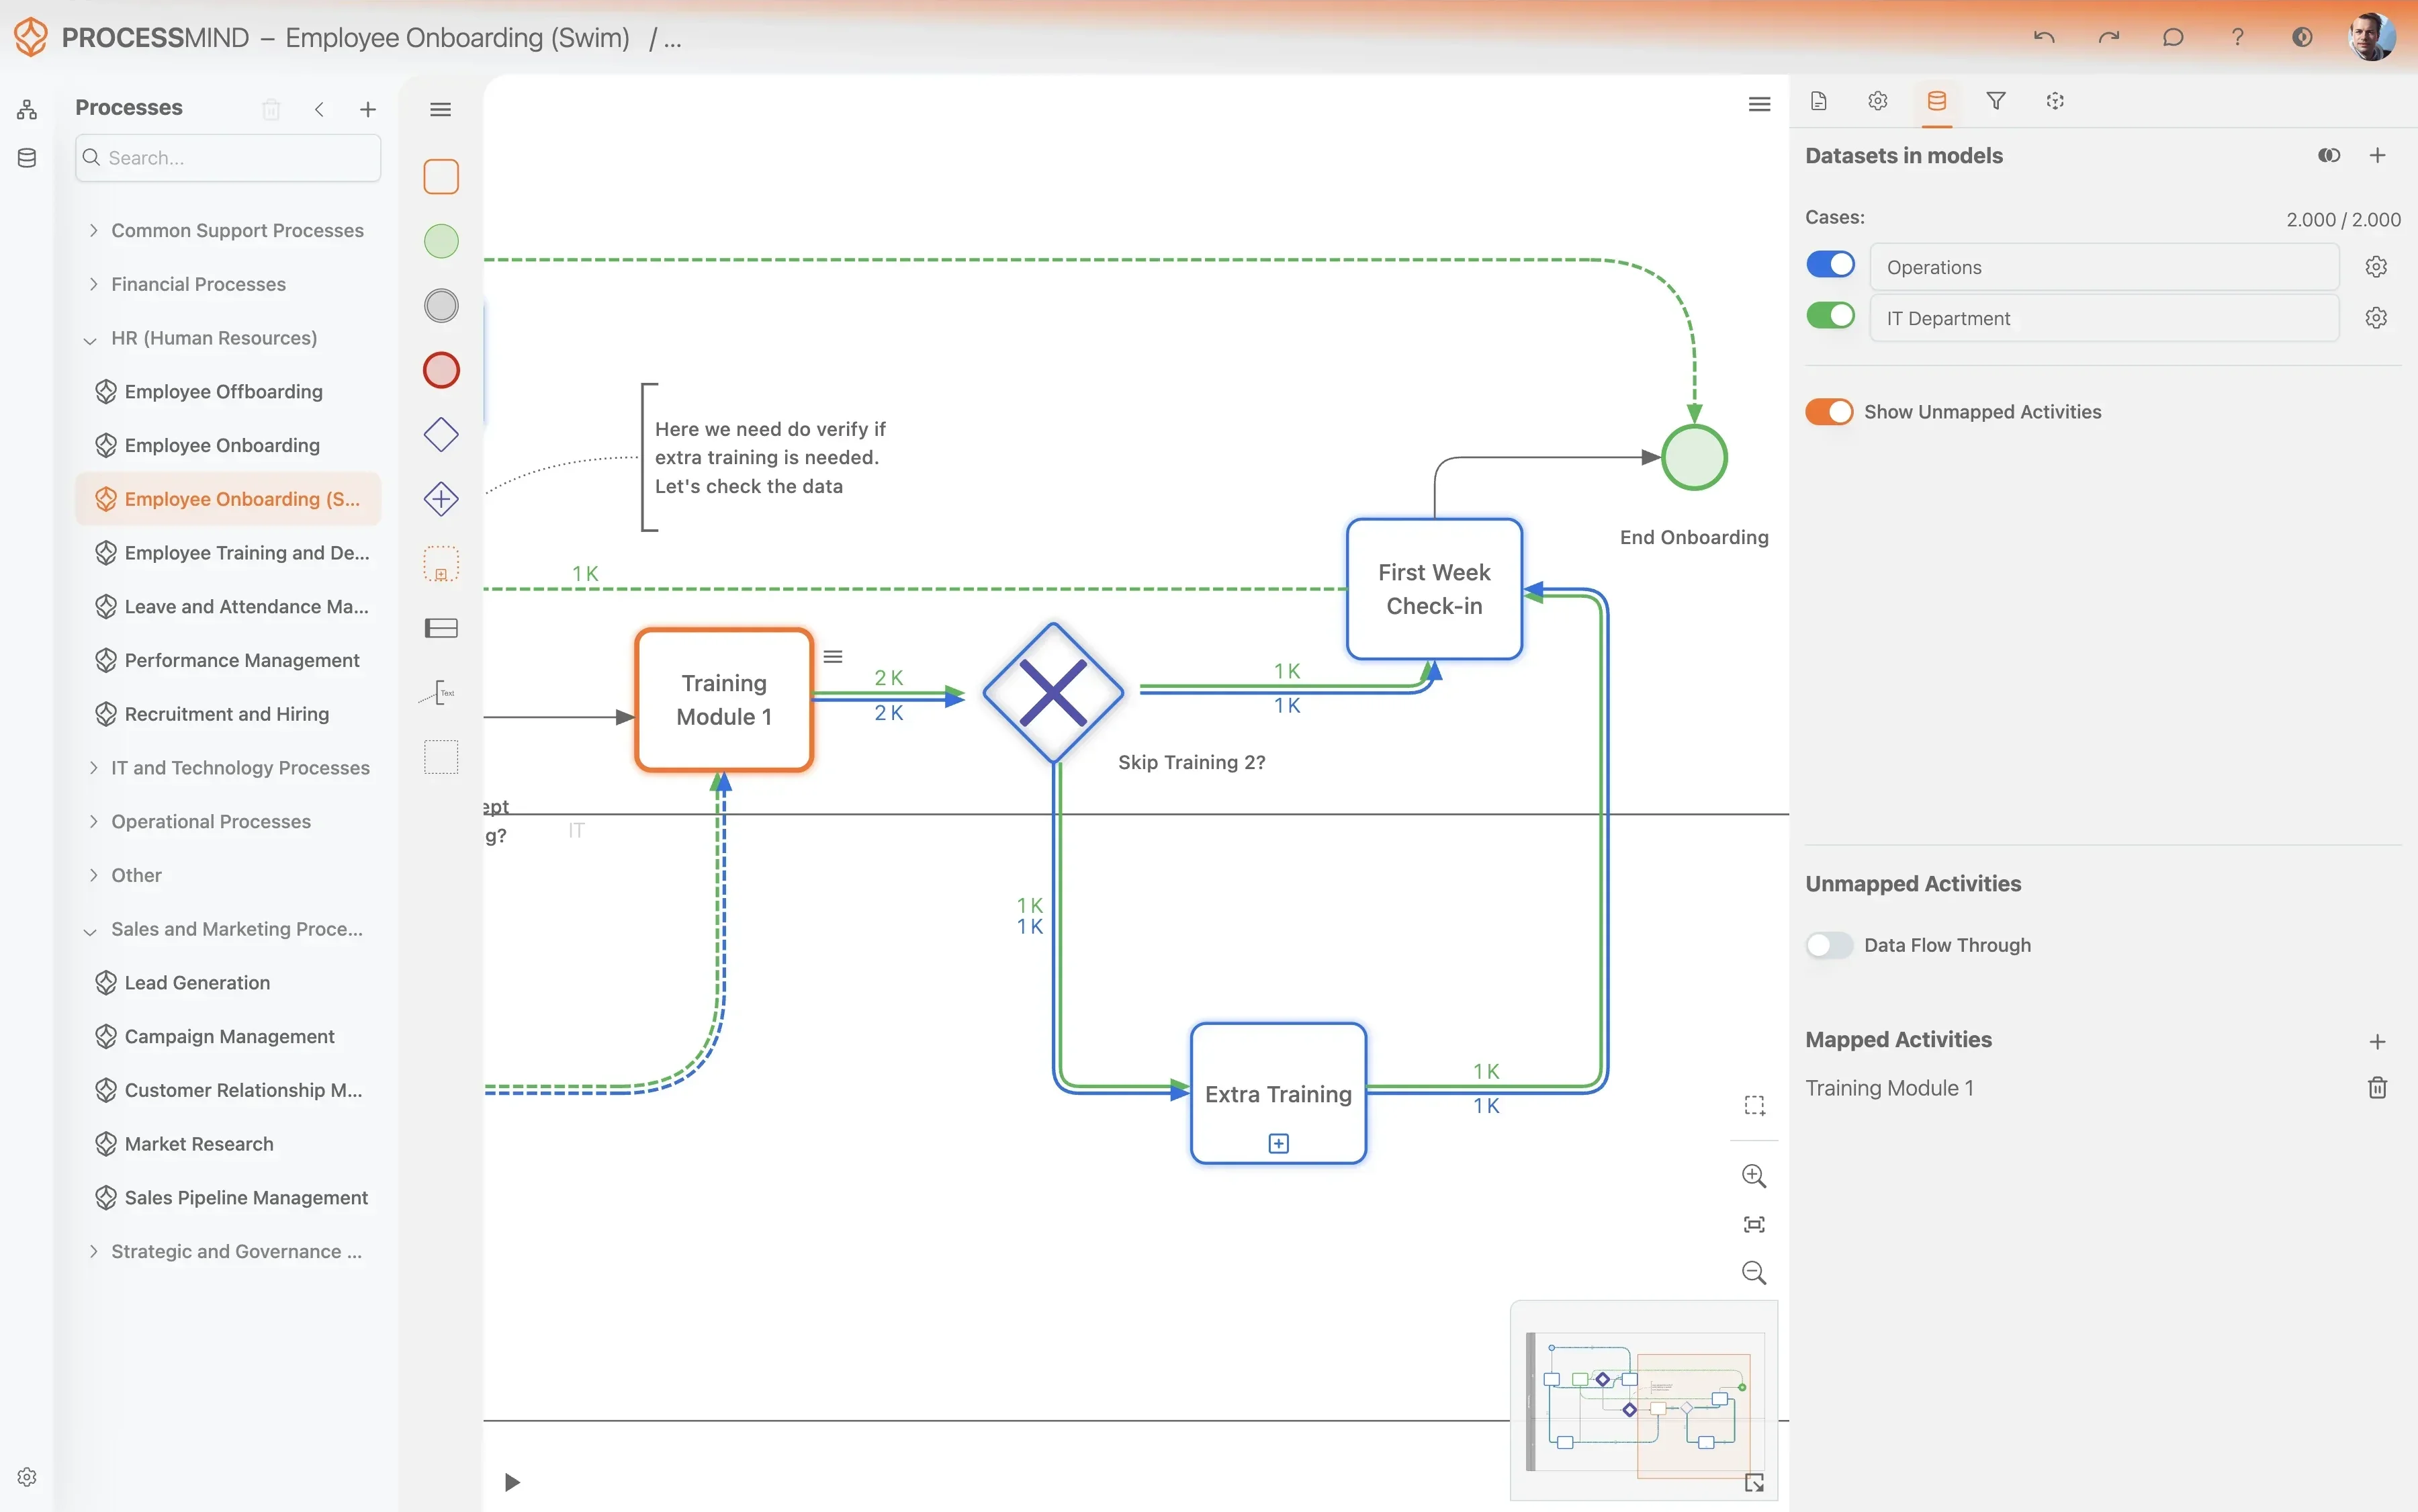
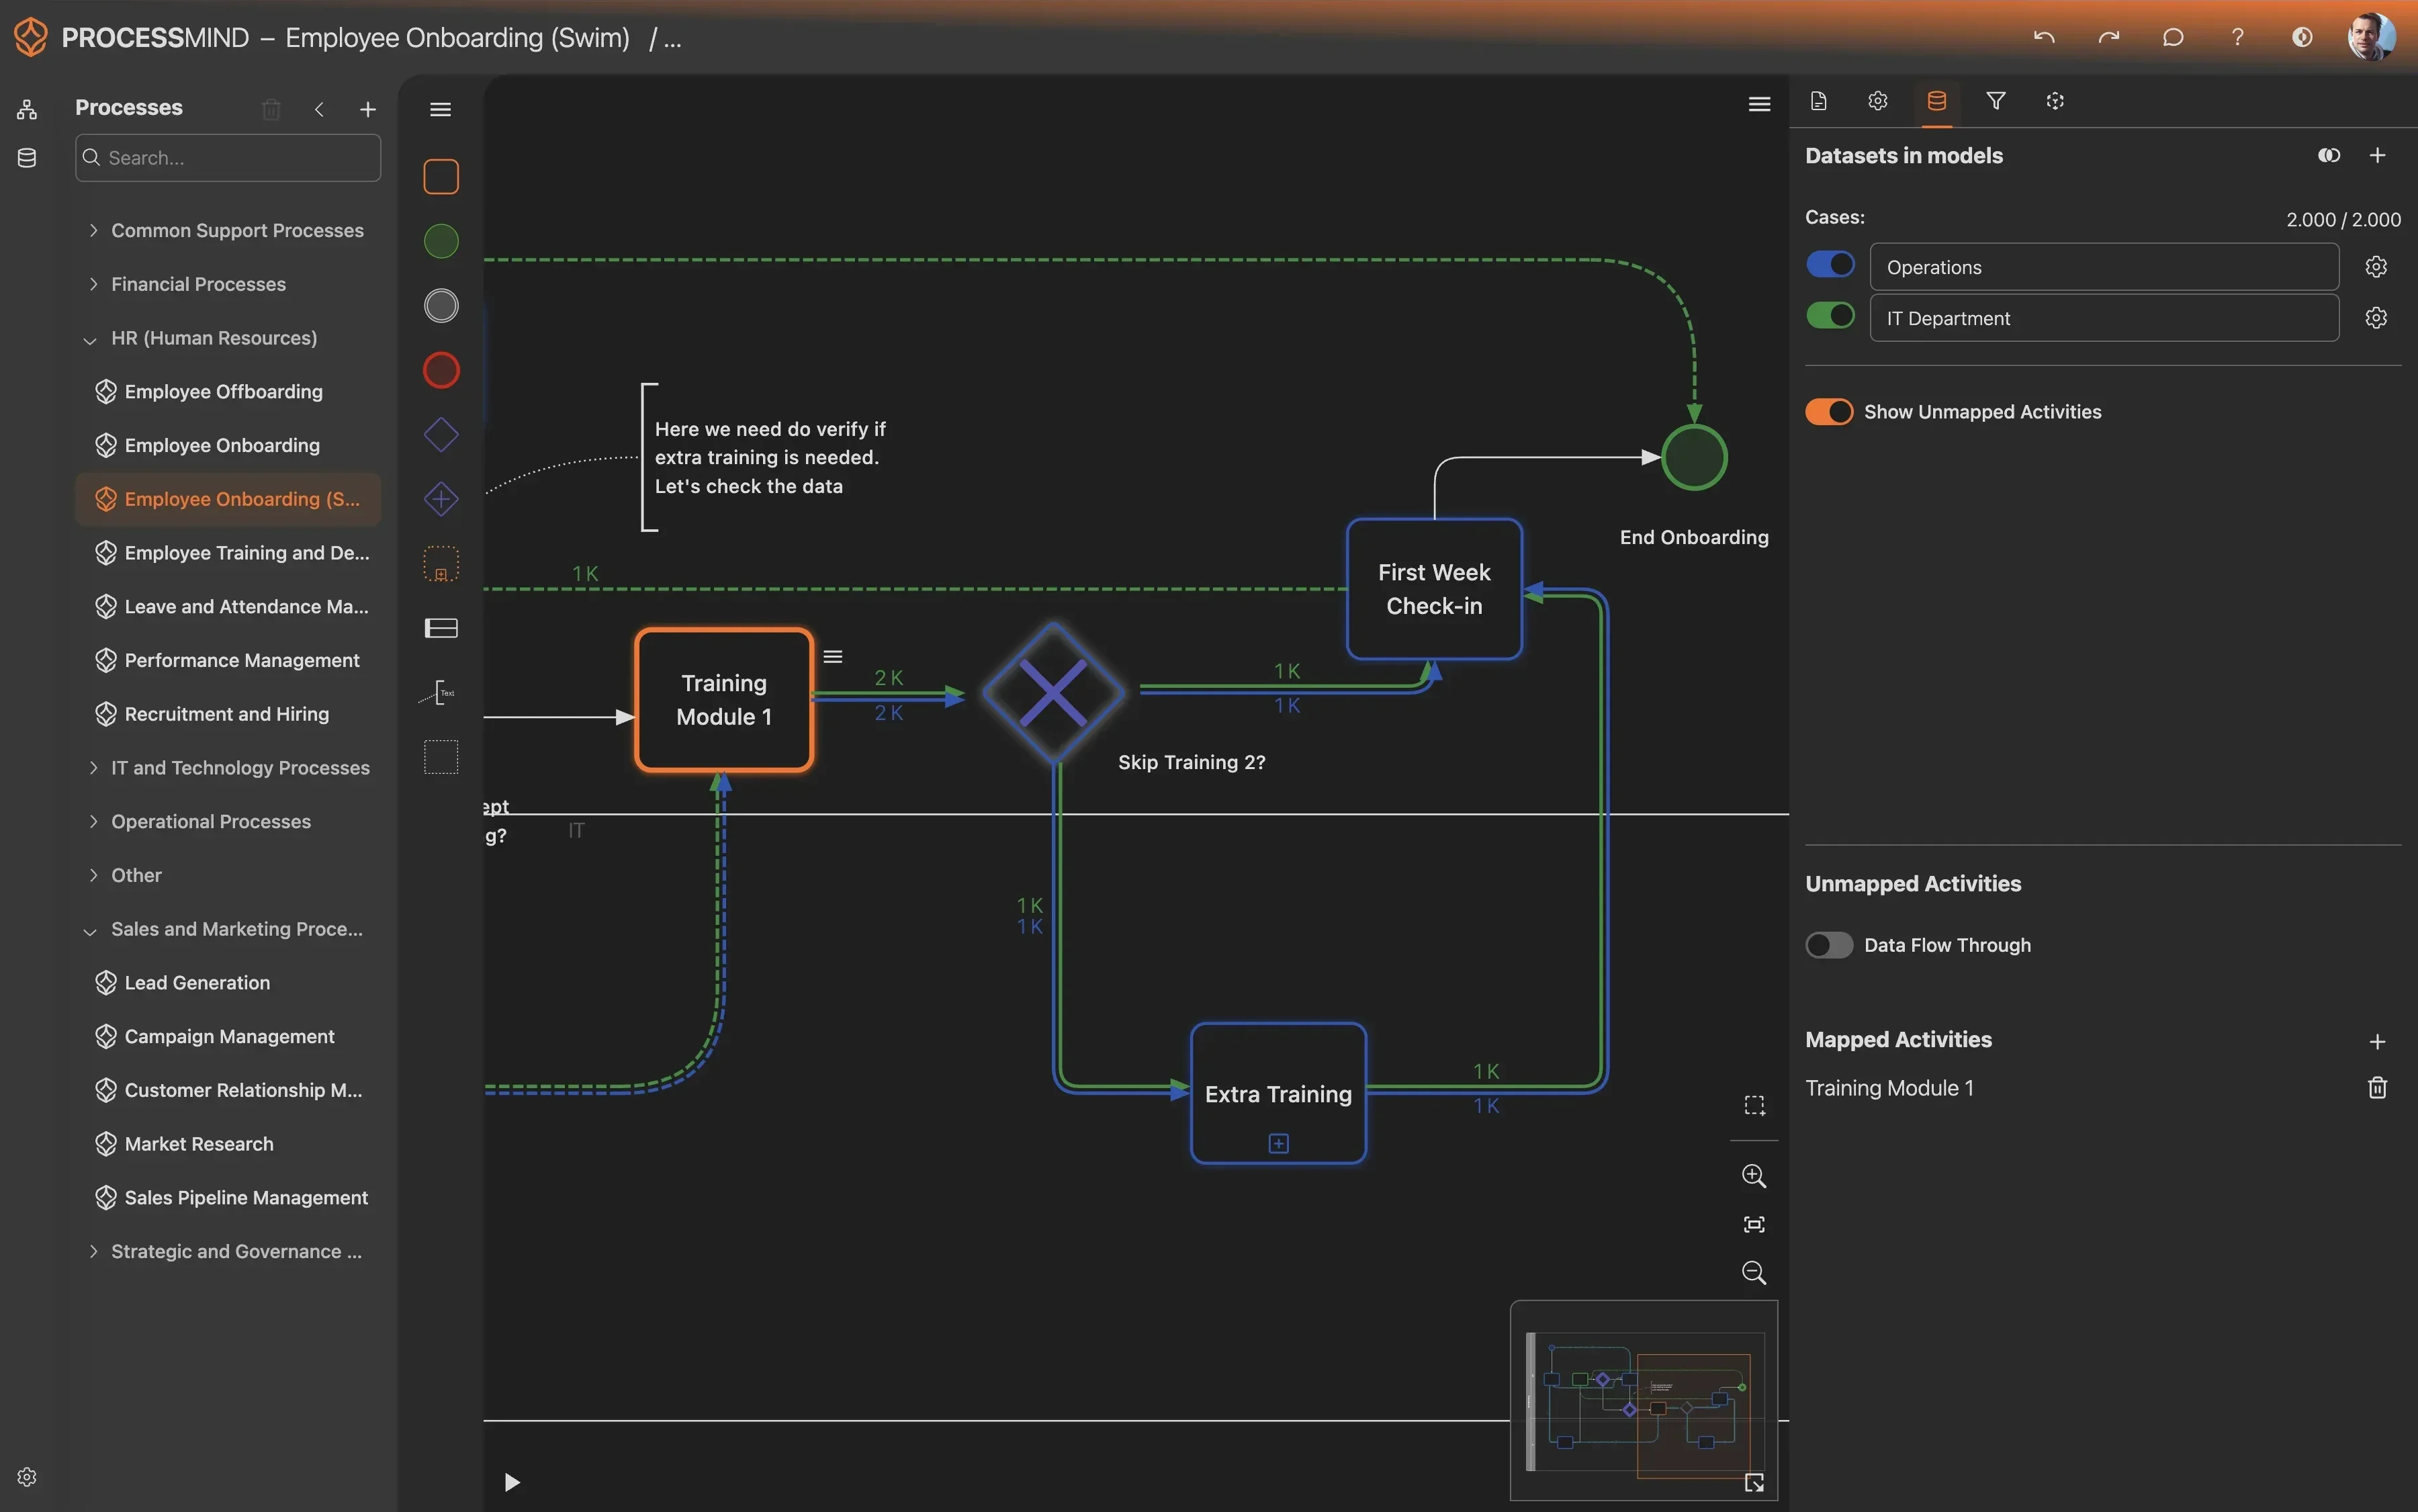
Niezależnie od wybranej metody dane powinny trafić tam, gdzie odbywa się analiza. Plik w folderze, którego nikt nie monitoruje, nie jest strategią zarządzania danymi. Zbiór danych, który ktoś mapuje i sprawdza, już tak.
Jakie narzędzia ETL sprawdzą się w process mining?
Nie ma jednej listy narzędzi ETL odpowiedniej dla każdego projektu. Wybór zależy od tego, gdzie znajdują się dane, z jakich narzędzi korzysta już zespół i jak bardzo trzeba przygotować dziennik. To standardowe zadania z zakresu inżynierii danych. Jedyny wymóg specyficzny dla process mining to zachowanie w danych wyjściowych identyfikatora sprawy, czynności i znacznika czasu.
| Podejście | Kiedy warto je wybrać | Kompromis |
|---|---|---|
| Ręczny eksport i przygotowanie danych | Testują Państwo jeden proces na małym, stabilnym zbiorze danych | Najszybszy start, ale każde odświeżenie wymaga ręcznej pracy |
| Narzędzia już używane przez zespół | SQL, dbt, hurtownia lub data lake są już dostępne | Pozwala wykorzystać istniejące umiejętności i infrastrukturę, a logikę stosować także poza process mining |
| Zewnętrzne narzędzie ETL | Dane trzeba regularnie pobierać z kilku systemów | Więcej elementów do skonfigurowania i utrzymania |
| ETL wbudowany w platformę process mining | Platforma obsługuje potrzebne przekształcenia | Wygodne rozwiązanie, ale warto sprawdzić, czy logikę można przenieść i ponownie wykorzystać dane |
W projektach process mining często pojawiają się następujące narzędzia: CData i dbt do pobierania danych i przekształceń SQL, BigQuery, Snowflake i Databricks po stronie hurtowni danych oraz Talend, Apache NiFi i Airbyte, gdy największym wyzwaniem jest przesyłanie danych między systemami. Dostępne są też narzędzia open source. Zwykle warto zacząć od NiFi lub Airbyte. Niektórzy dostawcy, między innymi Evidant i Konekti, oferują ETL przeznaczony do process mining wraz z szablonami dla popularnych systemów.
To przykłady, a nie rekomendacje. Żadna z wymienionych firm nie jest naszym partnerem. Warto wybrać narzędzia i formaty, które zespół będzie w stanie utrzymywać po zakończeniu projektu. Jeśli to możliwe, logikę przekształceń należy przechowywać poza platformą process mining. Szczególnie uważnie warto ocenić ETL wbudowany w platformę. Jest wygodny, dopóki z niej Państwo korzystają, ale przygotowane dane trudniej potem wykorzystać w innych projektach analitycznych lub AI.
Jak zarządzać danymi po ich wczytaniu?
Pobranie danych to dopiero połowa pracy. Sposób zarządzania zbiorami danych decyduje o tym, czy wyniki analizy będą aktualne także za kwartał.
- Nazywaj zbiory danych zgodnie z ich zawartością. Nazwa
Q1_2025_Sales_DatalubCustomer_Support_Logsmówi więcej niżexport_final_v3. - Dobierz format do zadania. CSV lub Excel wystarczą w przypadku małych plików wczytywanych ręcznie. Parquet lub ORC sprawdzą się przy dużych zbiorach i danych generowanych przez potok.
- Przejrzyj dane przed mapowaniem. Sprawdź strukturę, typy kolumn i kilka wierszy. Potwierdź identyfikator sprawy, czynność i znacznik czasu w konfiguracji zbioru danych.
- Sprawdź mapowanie czynności. Zacznij od automatycznego mapowania, a następnie przejrzyj niezmapowane czynności. Kroki, które występują, ale nie pozostawiają śladu w danych, można oznaczyć jako data flow through. Pozostaną widoczne, ale nie wpłyną na wyniki.
- Odświeżaj dane zamiast budować wszystko od nowa. Jeśli eksport jest cykliczny, zastępuj zbiór danych aktualnym plikiem z częstotliwością odpowiadającą potrzebom analizy, na przykład codziennie lub co tydzień, i zachowaj to samo mapowanie.
- Zapisz, czego dane nie obejmują. Brakujące okresy, systemy i kroki należy odnotować w analizie, ponieważ wpływają na wnioski, które można później wyciągnąć.
- Ogranicz dostęp, a nieużywane dane archiwizuj. Przyznaj dostęp do zbioru danych osobom, które go potrzebują, a po zakończeniu projektu zarchiwizuj dane, z których nikt już nie korzysta.
Podsumowanie
ETL jest środkiem do celu, a nie celem projektu process mining. Skonfiguruj go tak, by nie opóźniał pierwszej analizy:
- Zacznij od danych, które można uzyskać w tym tygodniu.
- Zachowaj trzy wymagane pola, niezależnie od tego, co jeszcze usuniesz.
- Najpierw wczytaj eksport. Zautomatyzuj ten proces, gdy analiza pokaże, że warto.
- Korzystaj z narzędzi i formatów, które zespół już utrzymuje.
Więcej projektów kończy się niepowodzeniem dlatego, że potok zbudowano, zanim ustalono, na jakie pytanie ma odpowiedzieć, niż dlatego, że był zbyt prosty.
Where to Go From Here
Mają już Państwo eksport albo potok, który może go wygenerować. Następny krok to wczytanie danych i sprawdzenie, czy eksport pozwala odpowiedzieć na postawione pytanie.