Datos Última actualización: 5 de noviembre de 2026
Herramientas ETL para Process Mining: lo que necesita
Cuándo necesita ETL Process Mining, qué datos debe incluir la extracción y por qué ProcessMind carga los datos que genera su pipeline actual.
¿Necesita ETL para Process Mining?
Las herramientas ETL extraen datos de los sistemas de origen, los transforman para que puedan utilizarse y los cargan para analizarlos. En este artículo verá qué tareas ETL necesita realmente un proyecto de Process Mining y cuáles puede evitar. No es una guía de compra de herramientas de integración. Si un sistema permite exportar los registros y el archivo contiene un ID del caso, una actividad y una marca de tiempo, a menudo puede prescindir de una canalización de datos para el primer análisis y cargar la exportación directamente.
La respuesta depende del proceso, de los sistemas que lo respaldan y de la frecuencia con la que debe actualizarse el análisis. Empiece con la extracción más pequeña que permita responder una pregunta y añada preparación y automatización cuando el primer análisis demuestre que hacen falta.
Hay tres situaciones que justifican el trabajo ETL:
- El proceso abarca varios sistemas. Hay que combinar los registros y unificar sus identificadores para seguir un caso de principio a fin.
- Los datos de origen no se pueden leer tal como están. Hay que estandarizar los nombres de las actividades, las marcas de tiempo o los identificadores de los casos antes de poder analizarlos.
- Es necesario repetir la extracción. Si los datos cambian a diario y el análisis debe reflejar esos cambios, una exportación manual deja de ser práctica.
Estos son motivos para preparar los datos, no para crear un proceso de integración antes de responder la primera pregunta. Cargue los datos disponibles, compruebe qué falta y decida a partir de ahí.
Durante un tiempo, dimos por hecho que ETL debía formar parte del producto. Después, analizamos lo que ya tenían nuestros clientes. La ola de los almacenes de datos duró unos veinte años y adoptó distintos nombres, como mercados de datos y lagos de datos. Hoy, la mayoría de las empresas ya dispone de datos utilizables. Por eso, dejamos de crear nuestro propio proceso de integración. Importe una exportación de los sistemas que ya utiliza o conecte a nuestra API el proceso que mantiene su equipo y empiece con los datos que ya tiene.
También puede prescindir de un proceso de integración independiente cuando:
- El proceso se registra principalmente en un solo sistema.
- Puede exportar los registros pertinentes.
- La exportación incluye un ID del caso, una actividad y una marca de tiempo.
- El archivo es lo bastante pequeño como para prepararlo manualmente.
- Aún está comprobando si los datos permiten responder su pregunta.
Una hoja de cálculo sirve para cambiar nombres de columnas, corregir incoherencias evidentes y eliminar los campos que no necesita. La preparación manual no tiene por qué ser permanente: cuando el análisis demuestre su utilidad y los datos deban actualizarse con frecuencia, automatice los pasos que se encuentre repitiendo.
Qué debe incluir la extracción
Un registro de eventos para Process Mining necesita tres campos y una fila por evento.
| Campo | Qué representa | Qué debe comprobar |
|---|---|---|
| ID del caso | La instancia del proceso, como un pedido o una solicitud de servicio | El mismo ID del caso debe vincular todos los eventos de esa instancia |
| Actividad | Un paso que tuvo lugar en el proceso | Nombres que distingan los pasos reales y se utilicen de forma coherente |
| Marca de tiempo | Cuándo ocurrió el paso | Una fecha y hora válidas, con una sola zona horaria en todas las fuentes que combine |
Los atributos como el coste, el usuario, el equipo, el segmento de clientes o la huella de CO2 son opcionales. También son los que convierten una vista del proceso en un análisis: cada atributo que conserve podrá utilizarse después como filtro, segmentación o medida. La referencia de atributos del conjunto de datos explica qué permite hacer cada campo.
Un campo puede existir en el sistema de origen y aun así no servir. Si el ID del caso cambia de un sistema a otro, los eventos no se podrán vincular. Si los nombres de las actividades son incoherentes, un mismo paso real aparecerá como tres. Si una marca de tiempo se guarda como texto, los eventos pueden quedar desordenados. Revise la exportación antes de asignar los campos y compruebe primero los tres campos obligatorios. Para conocer mejor qué debe incluir un registro, consulte qué necesita Process Mining.
Consulta mínima para obtener un registro de eventos útil
Si el sistema de origen ya almacena una fila por actividad, basta con una consulta select. En este ejemplo, la tabla se llama process_events y contiene el caso, la actividad y la hora del evento:
SELECT
  case_id        AS case_id,
  activity_name  AS activity,
  event_time     AS timestamp
FROM process_events
WHERE case_id IS NOT NULL
  AND activity_name IS NOT NULL
  AND event_time IS NOT NULL
ORDER BY case_id, event_time;
La consulta asigna un nombre a los tres campos, descarta las filas que no se pueden utilizar y ordena los eventos de cada caso. Adapte los nombres de la tabla y las columnas a su sistema de origen y revise una muestra de casos antes de cargar los datos: cada caso debe incluir los eventos esperados en un orden que las personas que realizan el trabajo reconozcan.
Qué pasos de transformación son importantes
La transformación debe corregir aquello que distorsionaría el análisis. Cuatro pasos cubren la mayoría de los casos.
-
Normalice los eventos
Coloque cada aparición de una actividad en su propia fila, junto con el ID del caso y la marca de tiempo, incluso si el sistema de origen guarda los pasos del proceso en columnas separadas. -
Prepare las marcas de tiempo para poder utilizarlas
Compruebe que los valores sean fechas y horas válidas, y averigüe si corresponden a la hora local o a UTC. Unifique las zonas horarias de las fuentes que combine; de lo contrario, el orden de los eventos será incorrecto. -
Estandarice los nombres de las actividades
Asigne una sola etiqueta a cada paso real, en un único idioma y con una sola ortografía. No combine pasos que solo parecen similares para acortar la lista. -
Combine fuentes solo cuando sea necesario
Encuentre la clave que vincula los registros y compruebe que coincida. Una unión que duplique eventos o elimine casos cambia la vista del proceso, así que compare el número de registros antes y después.
Si la exportación ya contiene una fila por evento y los tres campos necesarios, no hace falta transformarla. Es lo habitual, no un atajo. Cómo crear un registro de eventos para Process Mining explica los mismos pasos con ejemplos de Excel y SQL.
¿Dónde se debe cargar el registro de eventos?
Cargue los datos preparados en la plataforma donde los analizará. Para una primera revisión, basta con un solo archivo: prepárelo, cárguelo, consulte la vista del proceso y ajuste la extracción cuando vea qué permiten analizar los datos. Evite crear una nueva capa de almacenamiento solo para Process Mining. Si su equipo ya mantiene un almacén de datos o un lago de datos, conserve allí los datos y cargue lo que genere ese entorno.
En la página de formatos de datos compatibles encontrará más información. También puede enviar los mismos formatos mediante una tarea programada a través de la API de datos, si prefiere no cargarlos manualmente.
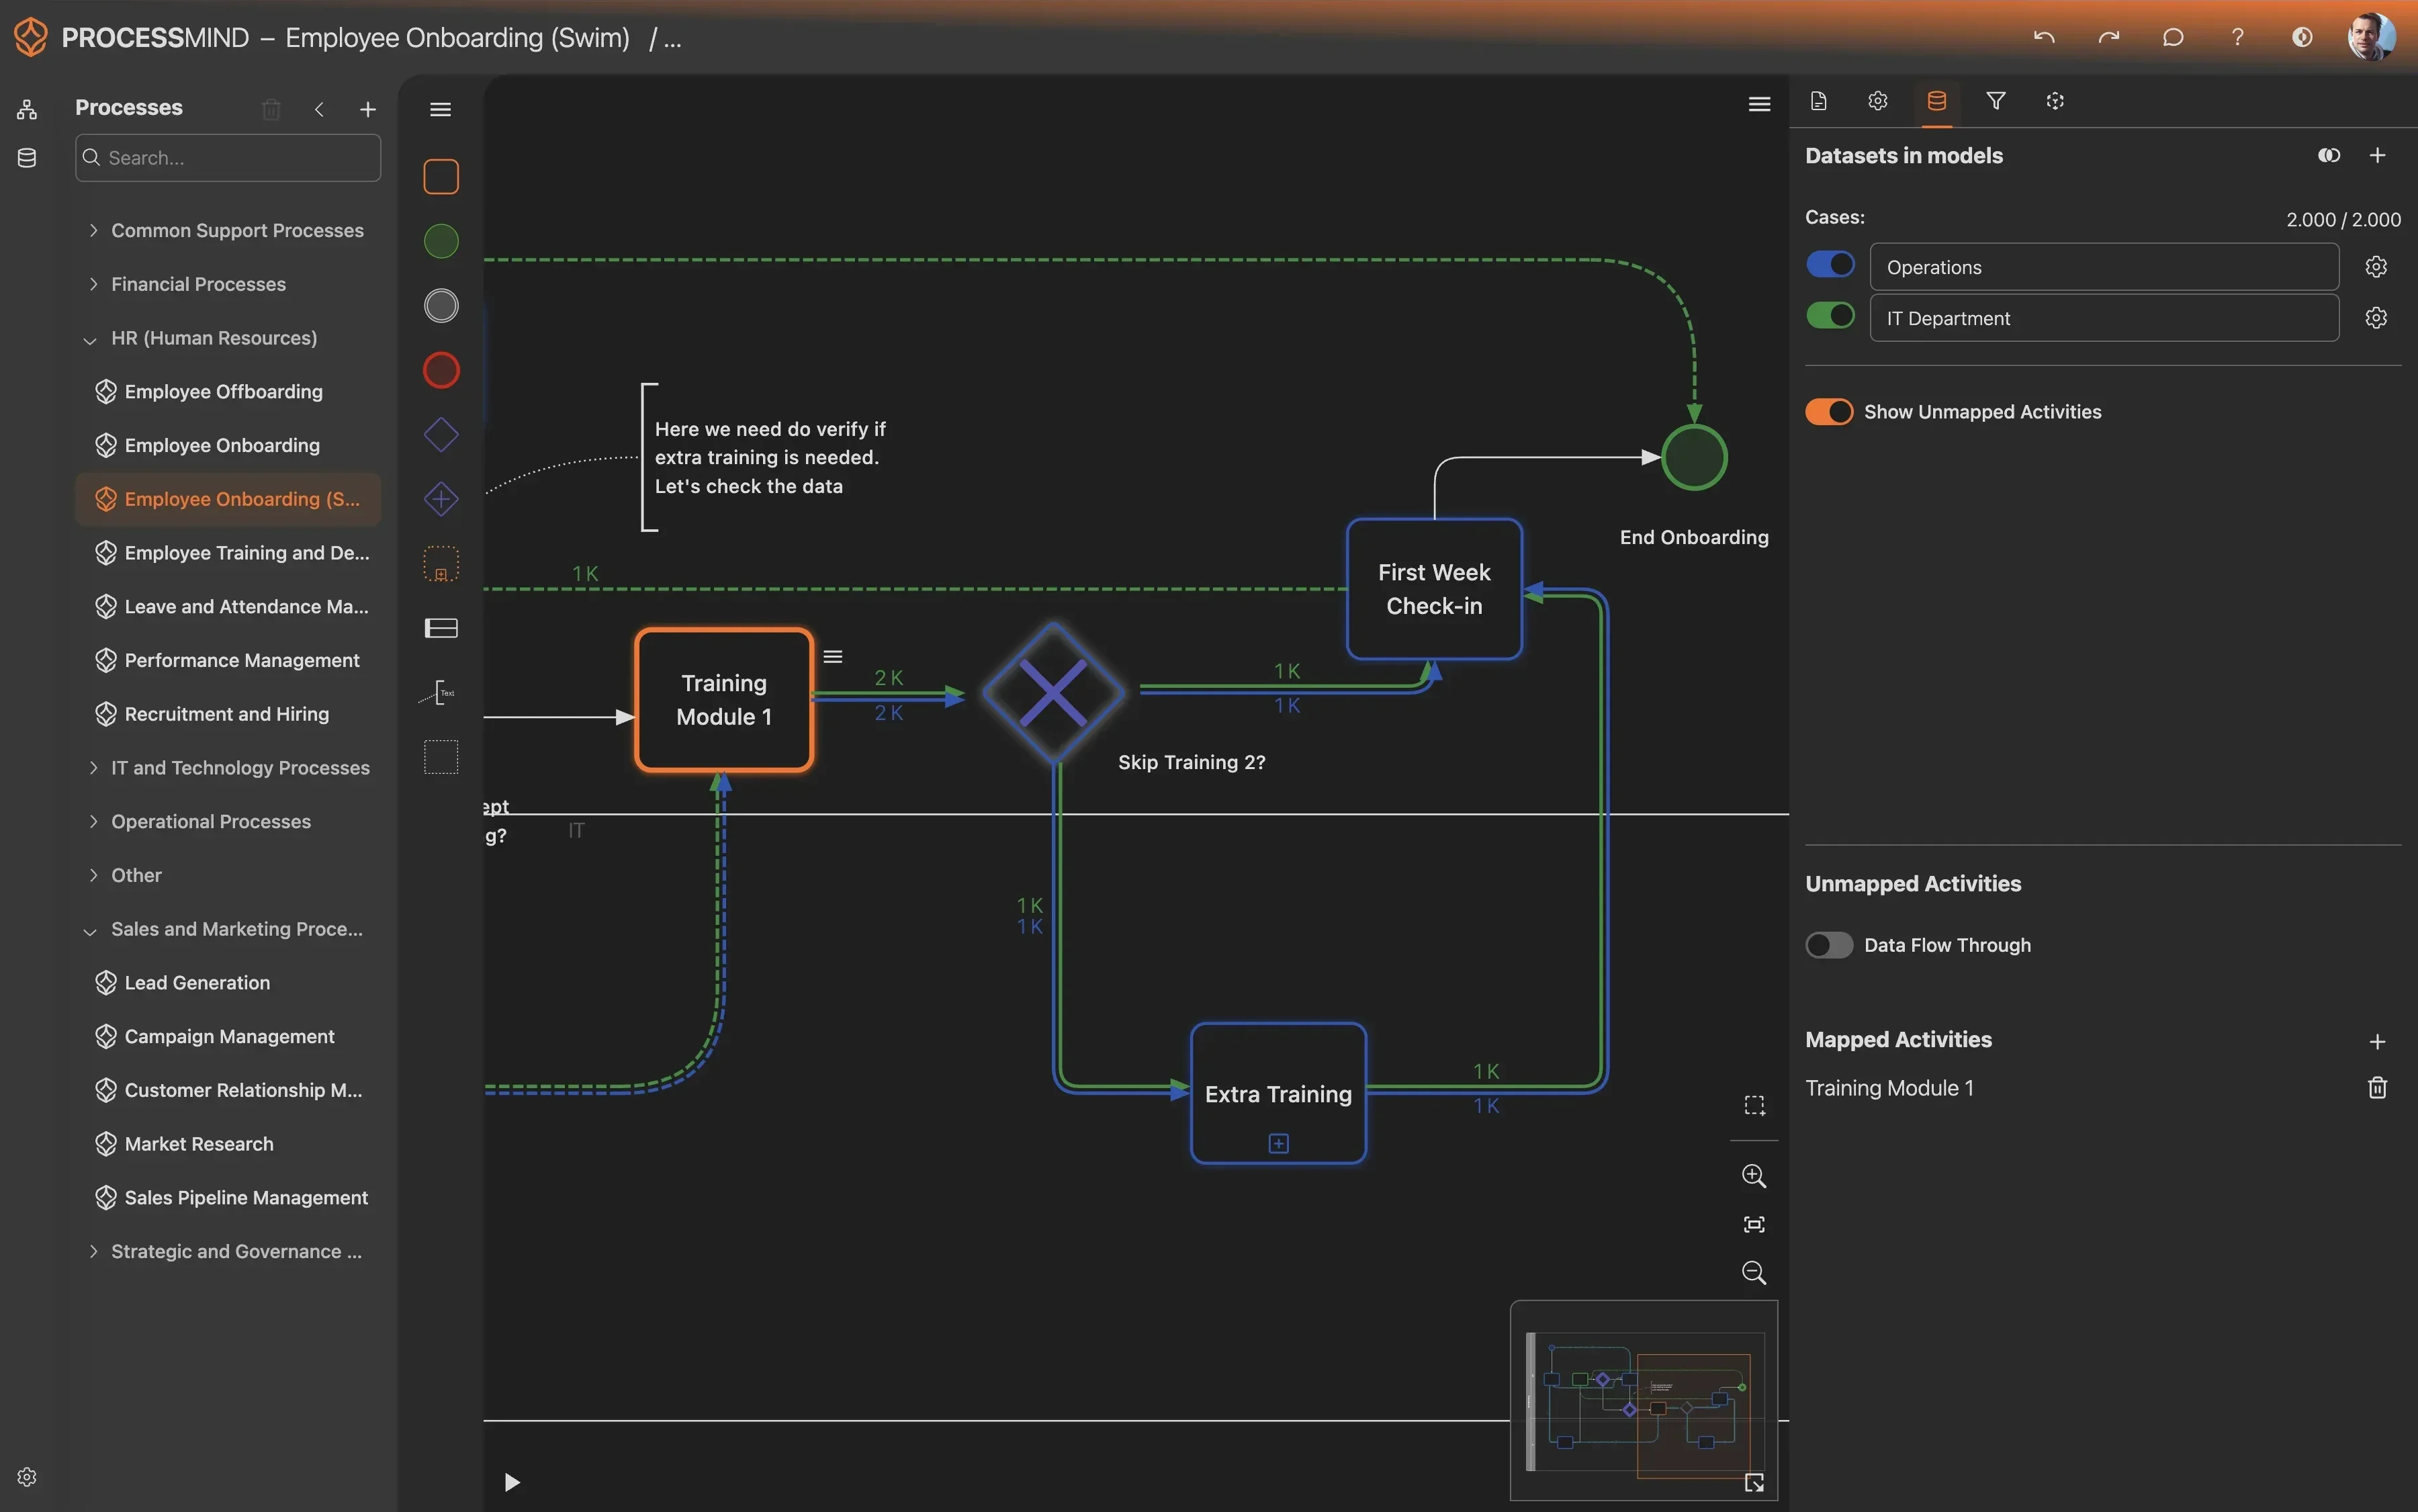
Sea cual sea la opción que elija, los datos deben terminar en el lugar donde se realiza el análisis. Un archivo en una carpeta que nadie revisa no constituye una estrategia de datos; sí lo es un conjunto de datos que alguien asigna y revisa.
¿Qué herramientas ETL son adecuadas para Process Mining?
No existe una lista única de herramientas ETL que sirva para todos los proyectos. Elija según dónde se encuentren los datos, qué herramientas utiliza ya su equipo y cuánta preparación necesita el registro. Se trata de tareas habituales de ingeniería de datos. El único requisito específico de Process Mining es que el resultado conserve el ID del caso, la actividad y la marca de tiempo.
| Enfoque | Cuándo utilizarlo | Aspectos a tener en cuenta |
|---|---|---|
| Exportar y preparar manualmente | Está probando un proceso con un conjunto de datos pequeño y estable | Es la forma más rápida de empezar, pero cada actualización requiere trabajo manual |
| Las herramientas que ya utiliza su equipo | Ya cuenta con SQL, dbt, un almacén de datos o un lago de datos | Aprovecha las habilidades y la infraestructura existentes, y permite reutilizar la lógica fuera de Process Mining |
| Una herramienta ETL de terceros | La extracción debe repetirse en varios sistemas | Requiere configurar y mantener más componentes |
| ETL integrado en una plataforma de minería de procesos | La plataforma incluye las transformaciones que necesita | Es práctico, pero compruebe si la lógica se puede trasladar y si los datos se pueden reutilizar en otros entornos |
Entre los nombres más habituales en proyectos de Process Mining están CData y dbt para extraer datos y transformarlos con SQL; BigQuery, Snowflake y Databricks en el ámbito de los almacenes de datos; y Talend, Apache NiFi y Airbyte cuando el reto principal es mover datos entre sistemas. El código abierto también es una opción válida. NiFi y Airbyte suelen ser un buen punto de partida. Algunos proveedores, como Evidant y Konekti, ofrecen ETL para Process Mining con plantillas para sistemas habituales.
Son ejemplos, no recomendaciones, y no implican ninguna asociación. Elija herramientas y formatos que su equipo pueda mantener una vez terminado el proyecto y, siempre que sea posible, conserve la lógica de transformación fuera del producto de minería. Conviene evaluar con cuidado el ETL integrado: resulta práctico mientras se utiliza esa plataforma, pero deja la preparación de los datos en un lugar donde será más difícil reutilizarla en el siguiente proyecto de analítica o IA.
¿Cómo se gestionan los datos después de cargarlos?
La extracción es solo la mitad del trabajo. La forma de gestionar los conjuntos de datos después de cargarlos determina si el análisis seguirá siendo válido dentro de tres meses.
- Asigne nombres que describan el contenido de los conjuntos de datos.
Q1_2025_Sales_DataoCustomer_Support_Logses mejor queexport_final_v3. - Elija el formato según el uso. CSV o Excel sirven para archivos pequeños que se cargan manualmente. Parquet u ORC son más convenientes para conjuntos de datos grandes y para los que genera una canalización.
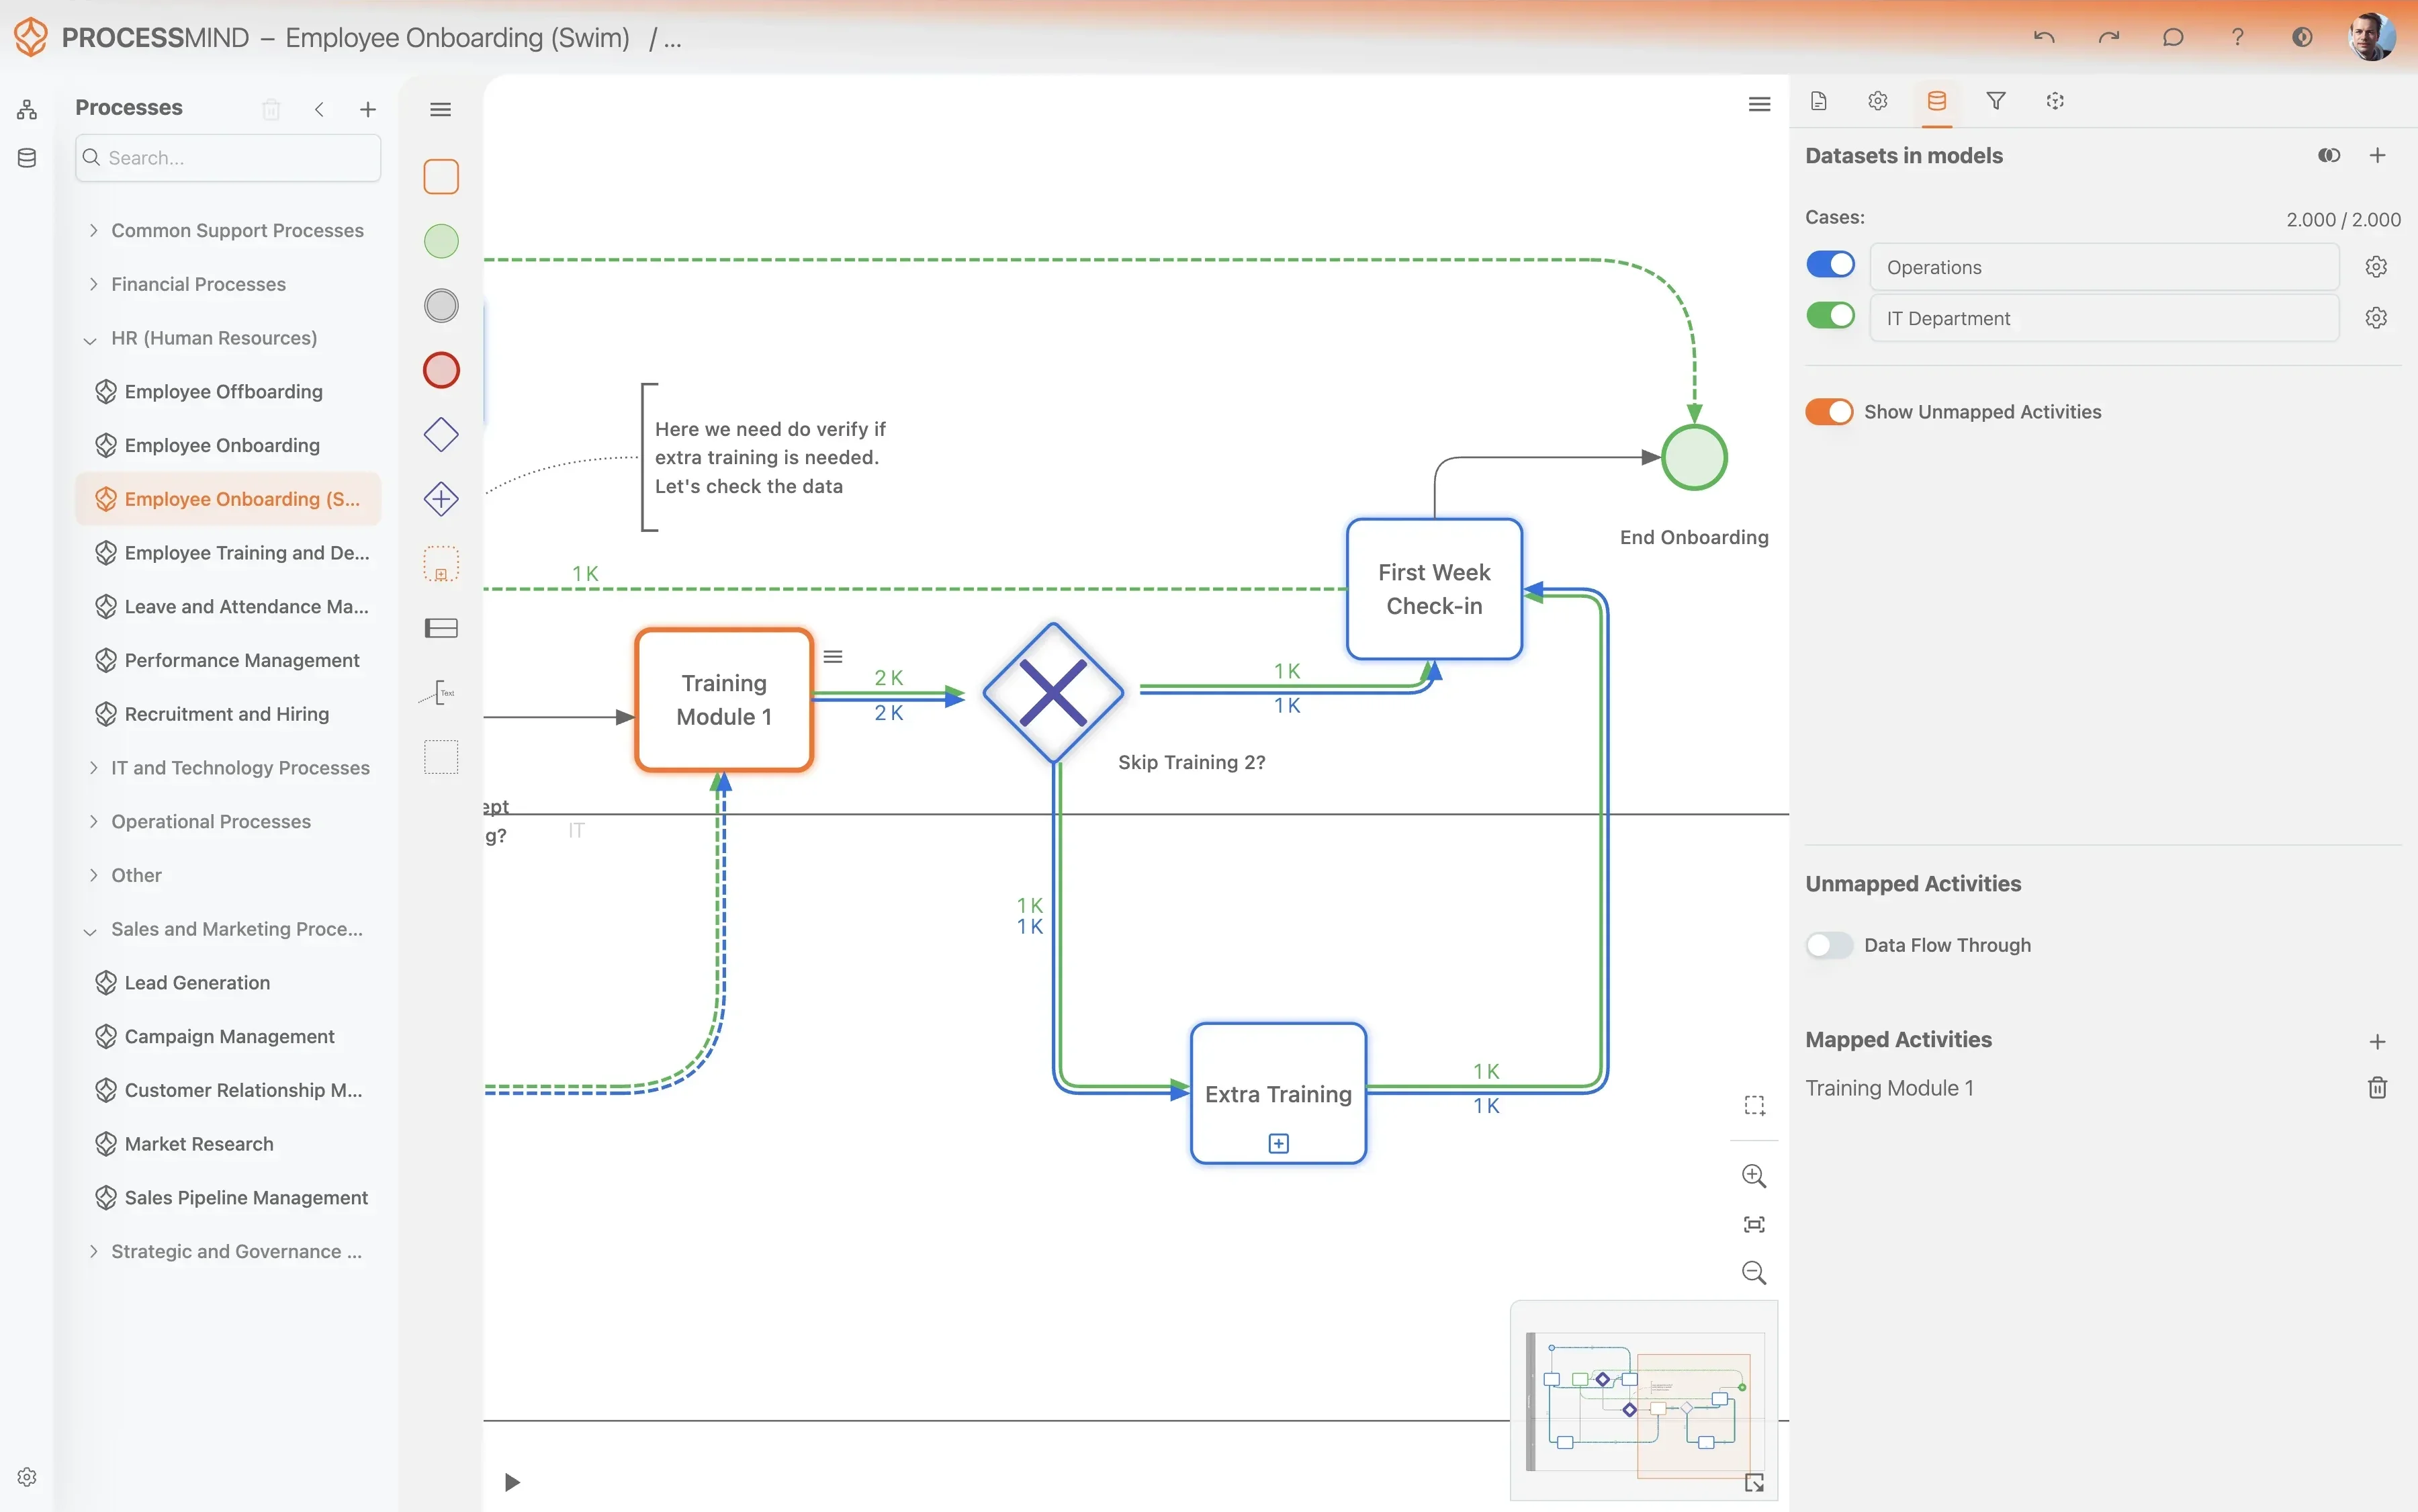
- Revise los datos antes de asignarlos. Compruebe la estructura, los tipos de columna y algunas filas. Confirme el ID del caso, la actividad y la marca de tiempo en la configuración del conjunto de datos.
- Revise la asignación de actividades. Deje que la asignación automática haga una primera pasada y, después, revise las actividades sin asignar. Los pasos que ocurren pero no dejan rastro en los datos pueden marcarse como flujo de datos a través de. Así permanecen visibles sin alterar las cifras.
- Actualice los datos en lugar de reconstruirlos. Si recibe exportaciones periódicas, sustituya el conjunto de datos por el archivo actualizado con la frecuencia que requiera el análisis, diaria o semanalmente, y conserve la misma asignación.
- Documente qué aspectos no cubren los datos. Anote los periodos, sistemas y pasos que faltan, ya que determinan qué conclusiones puede presentar.
- Controle el acceso y archive los datos. Conceda acceso al conjunto de datos a quienes lo necesiten y archive lo que ya no se utilice en un proyecto terminado.
En resumen
ETL es un medio, no el objetivo de un proyecto de Process Mining. Configúrelo para que no retrase el primer análisis:
- Empiece con los datos que pueda obtener esta semana.
- Conserve los tres campos obligatorios, aunque descarte otros.
- Cargue primero la exportación y automatice la carga cuando el análisis lo justifique.
- Utilice las herramientas y los formatos que su equipo ya mantiene.
Más proyectos fracasan porque se creó la canalización antes de saber qué pregunta debía responder que porque la canalización fuera demasiado sencilla.
Where to Go From Here
Ya tiene una exportación o una canalización que puede generarla. El siguiente paso es cargarla y comprobar si los datos extraídos responden a su pregunta.