Dados Última atualização em 5 de novembro de 2026
Ferramentas ETL para Process Mining: o que você precisa saber
Quando o Process Mining precisa de ETL, o que a extração deve conter e por que o ProcessMind carrega os dados gerados pelo pipeline que você já usa.
Você precisa de ETL para Process Mining?
As ferramentas ETL extraem dados dos sistemas de origem, transformam-nos em um formato adequado e os carregam para análise. Neste artigo, você vai entender o trabalho de ETL que um projeto de Process Mining realmente exige e o que pode ser dispensado. O foco não é escolher uma ferramenta de pipeline. Se um sistema exporta os registros e o arquivo contém um ID do caso, uma atividade e uma data e hora, muitas vezes você pode dispensar o pipeline na primeira análise e carregar o arquivo como está.
A resposta depende do processo, dos sistemas envolvidos e da frequência com que a análise precisa ser atualizada. Comece com a menor extração capaz de responder a uma pergunta. Depois, acrescente preparação e automação quando a primeira análise mostrar que são necessárias.
Três situações justificam o trabalho de ETL:
- O processo passa por vários sistemas. É preciso combinar os registros e alinhar seus identificadores para acompanhar um caso de ponta a ponta.
- Os dados de origem não podem ser lidos como estão. Os nomes das atividades, as datas e horas ou os identificadores dos casos precisam ser padronizados antes da análise.
- A extração precisa ser repetida. Quando os dados mudam diariamente e a análise precisa acompanhar essas mudanças, exportar manualmente deixa de ser prático.
Esses são motivos para preparar os dados, não para criar um pipeline antes de responder à primeira pergunta. Carregue o que você tem, veja o que está faltando e decida a partir daí.
Por um tempo, presumimos que o ETL deveria fazer parte do produto. Depois, analisamos o que nossos clientes já tinham. A onda dos data warehouses durou cerca de vinte anos e recebeu vários nomes, como data marts e data lakes. Hoje, a maioria das empresas já tem dados utilizáveis. Por isso, paramos de criar nosso próprio pipeline. Traga uma exportação dos sistemas que você usa ou direcione à nossa API o pipeline que sua equipe já mantém. Comece pelos dados que já estão disponíveis.
Você também pode dispensar um pipeline separado quando:
- O processo é registrado principalmente em um sistema.
- Os registros relevantes podem ser exportados.
- A exportação contém um ID do caso, uma atividade e uma data e hora.
- O arquivo é pequeno o bastante para ser preparado manualmente.
- Você ainda está testando se os dados respondem à sua pergunta.
Uma planilha é suficiente para renomear colunas, corrigir inconsistências evidentes e remover campos desnecessários. A preparação manual não precisa ser permanente: quando a análise se mostrar útil e os dados precisarem ser atualizados com frequência, automatize as etapas que você perceber que está repetindo.
O que a extração precisa gerar
Um Event Log para Process Mining precisa de três campos e uma linha por evento.
| Campo | O que representa | O que verificar |
|---|---|---|
| ID do caso | A instância do processo, como um pedido ou uma solicitação de serviço | O mesmo ID do caso deve conectar todos os eventos dessa instância |
| Atividade | Uma etapa que ocorreu no processo | Nomes que diferenciem etapas reais e sejam usados de forma consistente |
| Data e hora | Quando a etapa aconteceu | Uma data e hora válidas, com o mesmo fuso horário nas fontes combinadas |
Atributos como custo, usuário, equipe, segmento de cliente ou pegada de CO2 são opcionais. Mas são eles que transformam uma visão do processo em uma análise: cada atributo mantido pode se tornar um filtro, uma segmentação ou uma métrica. A referência de atributos do conjunto de dados explica o que cada campo permite fazer.
Um campo pode existir na origem e ainda assim não ser utilizável. Se o ID do caso mudar entre sistemas, os eventos não serão conectados. Rótulos inconsistentes de atividades podem transformar uma etapa real em três. Uma data e hora armazenada como texto pode deixar os eventos fora de ordem. Confira a exportação antes de mapeá-la e verifique primeiro os três campos obrigatórios. Para entender melhor o que um Event Log precisa conter, consulte o que é necessário para fazer Process Mining.
Uma consulta mínima viável para Event Log
Se a origem já armazena uma linha por atividade, basta fazer uma consulta select. Este exemplo considera uma tabela chamada process_events com um caso, uma atividade e a data e hora do evento:
SELECT
  case_id        AS case_id,
  activity_name  AS activity,
  event_time     AS timestamp
FROM process_events
WHERE case_id IS NOT NULL
  AND activity_name IS NOT NULL
  AND event_time IS NOT NULL
ORDER BY case_id, event_time;
A consulta identifica os três campos, remove as linhas que não podem ser usadas e ordena os eventos dentro de cada caso. Adapte os nomes da tabela e das colunas à sua origem e confira uma amostra de casos antes de carregar os dados: cada caso deve conter os eventos esperados, em uma ordem reconhecida por quem executa o trabalho.
Quais etapas de transformação são importantes
A transformação deve corrigir o que distorceria a análise. Quatro etapas resolvem a maior parte dos casos.
-
Padronize os eventos
Coloque cada ocorrência de atividade em uma linha própria, junto com o ID do caso e a data e hora, mesmo quando a origem armazena as etapas do processo em colunas separadas. -
Deixe as datas e horas prontas para uso
Confira se os valores são datas e horas válidas e se estão no horário local ou em UTC. Alinhe os fusos horários das fontes combinadas. Caso contrário, a ordem dos eventos ficará incorreta. -
Padronize os nomes das atividades
Use um único rótulo para cada etapa real, no mesmo idioma e com a mesma grafia. Não junte etapas diferentes só porque parecem semelhantes, para encurtar a lista. -
Combine fontes somente quando necessário
Encontre a chave que conecta os registros e teste se ela corresponde. Uma junção que duplica eventos ou elimina casos altera a visão do processo. Por isso, compare a quantidade de registros antes e depois.
Se a exportação já contém uma linha por evento e os três campos estão preenchidos, não há nada a transformar. Isso é normal, não um atalho. Como criar um Event Log para Process Mining explica o mesmo processo com exemplos em Excel e SQL.
Onde carregar o Event Log?
Carregue os dados preparados na plataforma em que você vai analisá-los. Para uma primeira análise, um único arquivo basta: prepare os dados, carregue o arquivo, consulte a visualização do processo e refine a extração quando entender o que os dados permitem analisar. Evite criar uma nova camada de armazenamento só para fazer Process Mining. Se sua equipe já mantém um data warehouse ou um data lake, deixe os dados lá e carregue o que esse ambiente produzir.
A página de formatos de dados compatíveis traz mais detalhes. Você também pode enviar os mesmos formatos por meio da API de dados usando uma tarefa agendada, sem precisar carregar os arquivos manualmente.
Seja qual for o caminho escolhido, os dados devem chegar ao local onde a análise acontece. Um arquivo em uma pasta que ninguém acompanha não é uma estratégia de dados. Um conjunto de dados que alguém mapeia e revisa, sim.
Quais ferramentas de ETL funcionam para Process Mining?
Não existe uma lista única de ferramentas de ETL que sirva para todos os projetos. Escolha com base em onde os dados estão, nas ferramentas que sua equipe já usa e no nível de preparação necessário para o Event Log. O trabalho é o de sempre na engenharia de dados. Para Process Mining, o único requisito específico é manter no resultado o ID do caso, a atividade e a data e hora.
| Abordagem | Quando usar | Desvantagem |
|---|---|---|
| Exportar e preparar manualmente | Você está testando um processo em um conjunto de dados pequeno e estável | É a forma mais rápida de começar, mas cada atualização exige trabalho manual |
| Ferramentas que sua equipe já usa | SQL, dbt, um data warehouse ou um data lake já fazem parte do ambiente | Aproveita as habilidades e a infraestrutura existentes e mantém a lógica reutilizável fora do Process Mining |
| Ferramenta de ETL de terceiros | A extração precisa se repetir em vários sistemas | Exige mais componentes para configurar e manter |
| ETL integrado à plataforma de mineração | A plataforma oferece as transformações necessárias | É prático, mas verifique se a lógica pode ser reutilizada e se os dados podem ser aproveitados em outros lugares |
Entre os nomes mais comuns em projetos de Process Mining estão CData e dbt para extração de dados e transformação com SQL; BigQuery, Snowflake e Databricks para data warehouse; e Talend, Apache NiFi e Airbyte quando o desafio é transferir dados entre sistemas. O código aberto também é uma opção, com NiFi e Airbyte entre os pontos de partida mais comuns. Alguns fornecedores, como Evidant e Konekti, oferecem ferramentas de ETL voltadas para Process Mining, com Templates para sistemas comuns.
Esses são exemplos, não recomendações, e não há parceria com nenhuma dessas empresas. Prefira as ferramentas e os formatos que sua equipe poderá manter depois do projeto. Sempre que possível, mantenha a lógica de transformação fora do produto de mineração. Vale avaliar com cuidado o ETL integrado: ele é prático enquanto você usa a plataforma, mas deixa a preparação dos dados em um lugar onde fica mais difícil reutilizá-la no próximo projeto de analytics ou IA.
Como gerenciar os dados depois de carregá-los?
A extração é só metade do trabalho. A forma como você gerencia os conjuntos de dados depois determina se a análise continuará válida daqui a três meses.
- Dê nomes que indiquem o conteúdo dos conjuntos de dados.
Q1_2025_Sales_DataouCustomer_Support_Logsé melhor do queexport_final_v3. - Escolha o formato adequado para cada tarefa. CSV ou Excel funcionam bem para arquivos pequenos carregados manualmente. Parquet ou ORC são mais adequados para conjuntos de dados grandes e para arquivos gerados por um pipeline.
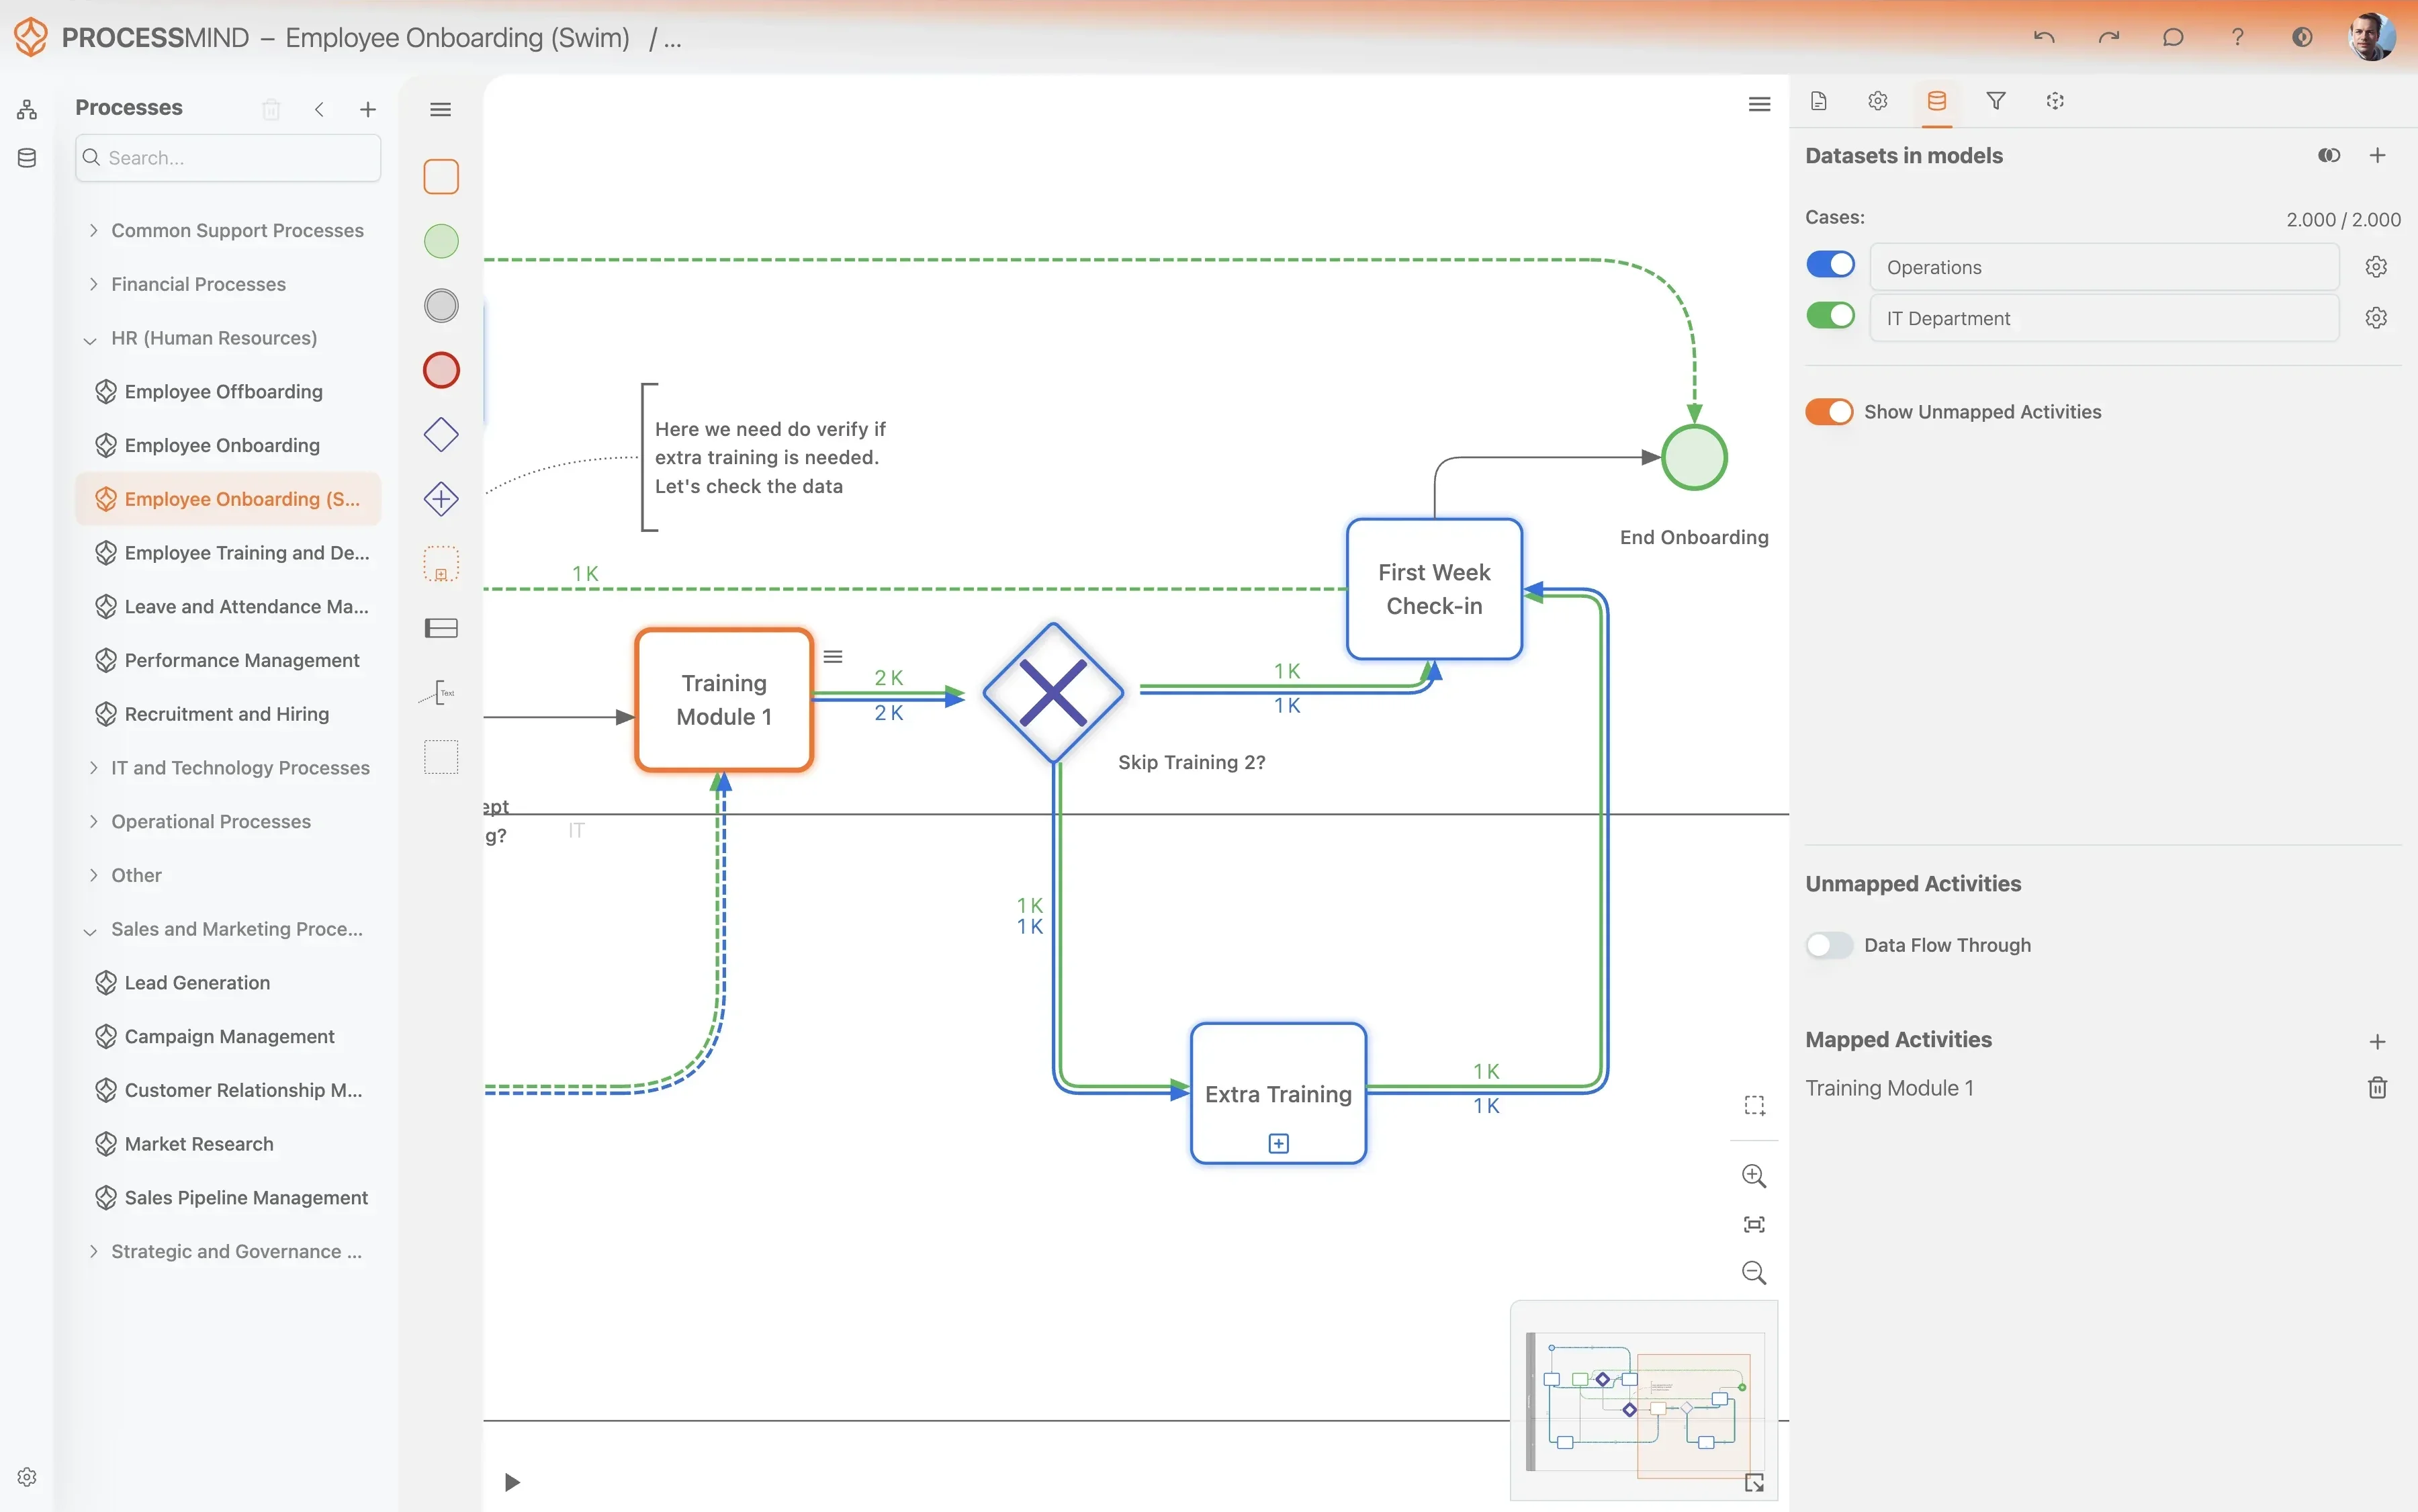
- Confira uma prévia antes de mapear. Verifique a estrutura, os tipos de coluna e algumas linhas. Confirme também o ID do caso, a atividade e a data e hora na configuração do conjunto de dados.
- Confira o mapeamento das atividades. Deixe o mapeamento automático fazer a primeira tentativa e, em seguida, revise as atividades não mapeadas. Você pode marcar como fluxo de dados as etapas que acontecem, mas não deixam registro nos dados. Assim, elas continuam visíveis sem alterar os números.
- Atualize os dados em vez de reconstruir tudo. Se você exporta os dados regularmente, substitua o conjunto de dados pelo arquivo atualizado na frequência necessária para a análise, diária ou semanal, e mantenha o mesmo mapeamento.
- Registre o que os dados não abrangem. Anote períodos, sistemas e etapas ausentes, pois essas lacunas determinam o que você poderá afirmar ao final.
- Controle o acesso e arquive os dados. Conceda acesso ao conjunto de dados a quem precisa dele e arquive o que não for mais usado em projetos concluídos.
Resumo
ETL é um meio, não o objetivo de um projeto de Process Mining. Configure-o para não atrasar a primeira análise:
- Comece pelos dados que você consegue obter nesta semana.
- Mantenha intactos os três campos obrigatórios, mesmo que descarte os demais.
- Carregue primeiro a exportação e automatize o carregamento quando a análise justificar isso.
- Use as ferramentas e os formatos que sua equipe já mantém.
Mais projetos fracassam porque o pipeline foi criado antes de alguém saber qual pergunta precisava responder do que por ser simples demais.
Where to Go From Here
Você já tem uma exportação ou um pipeline capaz de gerá-la. Agora, carregue os dados e confira se a extração responde à sua pergunta.