リーンプロセス改善:データに基づくガイド
DMAICプロセス、シックスシグマプロセス、リーンプロセス改善の手法を学び、測定可能な業務成果につなげます。

プロセスマイニングのパフォーマンスは、アップロードするデータ量、データの構造、システムによる処理方法という三つの要因で決まります。このガイドでは、実際のベンチマークと結果を改善する具体的な方法を通じて、三つの要因をすべて説明します。
数値はすべて公開しています。他のプロセスマイニングツールと比較してみてください。
主なポイント
ProcessMindにデータをアップロードすると、三つの処理が行われます。時間がどこでかかるのかを、正確に見ていきます。
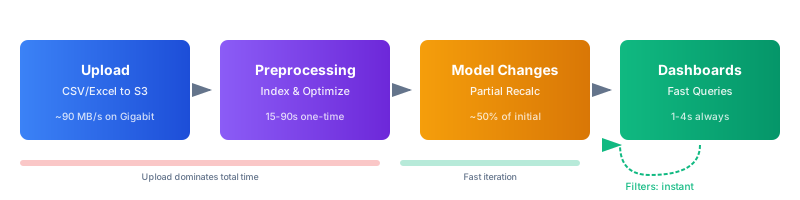
**アップロード(全体の所要時間の大部分を占めます)。**ファイルはインターネット経由でクラウド基盤に送信されます。大容量ファイルでは、ここがボトルネックになります。物理的な制約は避けられません。5,000万件のイベントを含むCSV(11GB)は、ギガビット回線で2分、100Mbpsで18分、10Mbpsでは3時間以上かかります。同じデータをParquetにするとわずか1.7GBとなり、所要時間は19秒、3分、28分まで短縮されます。ParquetやORCなどの列指向形式、またはより小さなデータセットを使う主な理由はここにあります。
**前処理(初回のみ、約30秒~2.5分)。**アップロードが完了すると、データを最適化された列指向ストレージに変換します。イベントのインデックス作成、アクティビティ間の遷移の事前計算、プロセスバリアントの特定、要約統計の計算を行います。小規模なデータセットでは30秒、1億件のイベントでは最大2.5分かかります。この処理はアップロードごとに1回だけ発生し、その後の分析で効果を発揮します。
**モデルの変更(部分的な再計算、6~52秒)。**アクティビティの追加・削除やマッピングの変更によってプロセスモデルを修正すると、モデルに依存する計算だけが更新されます。小規模なデータセットでは6秒、1億件のイベントでは最大52秒です。前処理を最初からやり直すよりも大幅に短時間で済みます。フィルターの変更はすぐに反映されます。
ダッシュボードのパフォーマンス:常に高速
**ダッシュボードは高速です。**前処理が完了すると、1,000万件までのデータセットでは、ダッシュボードの操作に2.5秒未満で応答します。5,000万件でも、ほとんどのクエリは2~5秒で返ります。1億件を超えるデータセットでプロセスフローを表示する場合でも、7秒程度です。詳しい応答時間は、以下の詳細な応答時間をご覧ください。
数時間かけて行う分析がすぐに実行できるよう、前処理に大きく投資しています。
データを読み込んだ後のクエリ速度は、いくつかの特性によって決まります。これらを理解しておくと、より適切なエクスポート設計と現実的な期待値の設定に役立ちます。
**アクティビティ数が影響します。**10~20種類のアクティビティを含むプロセスモデルが最適です。50種類を超えると、プロセスフローの計算に時間がかかり、理解も難しくなります。ノードやエッジが多すぎると、表示が複雑になります。エクスポートに多くのアクティビティが含まれる場合は、関連する手順をグループ化してください。
**バリアントの多様性が計算に影響します。**ケースの80%が5つのバリアントに沿って進むプロセスは、すべてのケースが異なる経路をたどるプロセスよりも速く分析できます。ばらつきが大きいことは悪いとは限らず、実際の問題を示している場合もあります。ただし、クエリの実行時間はやや長くなる可能性があります。
**列が増えるほどスキャン量も増えます。**含めた各属性にはインデックスが作成され、クエリの対象になります。基本となるCaseId、Activity、Timestampは常に必要です。追加の列はフィルタリングや分類に役立ちますが、列ごとに処理負荷が増えます。
**ケースが長いほど時間がかかります。**50件のイベントを含むケースは、5件のケースより多くの計算が必要です。数百件のイベントにまたがるケースが含まれるプロセスでは、クエリも比例して遅くなります。これは特定のツールに限った問題ではなく、プロセスマイニングに inherent な特性です。
何を期待できるかを理解しておくと、計画を立てやすくなります。以下のベンチマークは、実際のネットワーク遅延を含む本番AWS基盤で実施し、複数回のテスト結果を平均したものです。データセットのサイズごとに50種類以上のクエリをテストしました。
以下の表は、各データセットサイズで想定される現実的な所要時間を示しています。特に回線速度が遅い場合、大きなファイルではアップロード時間が大部分を占めます。全体の待ち時間を左右する最大の要因です。
| データセット | 実際のイベント数 | ファイルサイズ | アップロード(1Gbps) | アップロード(100Mbps) | アップロード(50Mbps) | アップロード(10Mbps) | 前処理 |
|---|---|---|---|---|---|---|---|
| 100K | 125,260 | 22MB | < 1秒 | 2秒 | 4秒 | 22秒 | 35秒 |
| 500K | 626,300 | 110MB | 1秒 | 11秒 | 22秒 | 2分 | 45秒 |
| 1M | 1,253,424 | 221MB | 3秒 | 22秒 | 44秒 | 4分 | 55秒 |
| 2M | 2,506,848 | 443MB | 5秒 | 44秒 | 1.5分 | 7分 | 1分 |
| 5M | 4,996,877 | 1.1GB | 13秒 | 2分 | 4分 | 18分 | 1.5分 |
| 10M | 12,511,867 | 2.2GB | 25秒 | 4分 | 7分 | 37分 | 1.5分 |
| 20M | 25,023,734 | 4.4GB | 50秒 | 7分 | 15分 | 1.2時間 | 2分 |
| 50M | 62,559,335 | 11.1GB | 2分 | 18分 | 37分 | 3時間 | 2分 |
| 100M | 125,118,670 | 22.3GB | 4分 | 37分 | 1.2時間 | 6時間 | 2.5分 |
ファイルサイズは、一般的なイベントログのスキーマ(CaseId、Activity、Timestamp、および5~8個の業務属性)を持つ非圧縮CSVを基準にしています。列数や内容によって、実際のファイルサイズは異なります。
1Gbpsでのアップロード時間は、AWS eu-central-1への実効スループット88MB/秒で測定しています。その他の速度は、実用上のスループットとして、50Mbpsは約5MB/秒、100Mbpsは約10MB/秒、10Mbpsは約1MB/秒で換算しています。実際のスループットは、ネットワーク、データセンターまでの距離、現在の負荷によって異なります。
**重要なポイント:**前処理時間は、規模にかかわらず1~2.5分程度で頭打ちになります。一方、アップロード時間はファイルサイズに比例して増加します。ファイルサイズを小さくすることが、最も効果の高い最適化です。
アップロードするファイル形式は、アップロード速度と前処理時間に大きく影響します。ProcessMindはCSV、Parquet、ORC、Excel、XESに対応しています。大規模なデータセットでは、ParquetとORCはファイルサイズと処理速度の両方でCSVを大きく上回ります。
| データセット | CSV | Parquet | ORC | CSV.GZ |
|---|---|---|---|---|
| 100万イベント | 221MB | 34MB | 39MB | 20MB |
| 500万イベント | 1.1GB | 151MB | 197MB | 107MB |
| 1,000万イベント | 2.2GB | 301MB | 395MB | 215MB |
| 2,000万イベント | 4.4GB | 603MB | 791MB | 430MB |
| 5,000万イベント | 11.1GB | 1.7GB | 1.9GB | 1.1GB |
| 1億イベント | 22.3GB | 3.4GB | 3.7GB | 2.2GB |
ParquetファイルはCSVより85%小さく、ORCファイルは82%小さくなります。どちらも圧縮機能を組み込んだ列指向形式のため、追加の処理は必要ありません。Spark、Databricks、dbt、BigQueryなどのETLツールやデータ基盤では、すでにParquetまたはORCへのエクスポートに対応している可能性があります。
ファイルサイズだけでは全体像は分かりません。アップロード後、データは形式に応じた取り込みと分析計算を経ます。イベントのインデックス作成、遷移とバリアントの計算などが含まれます。時間の大部分を占めるのは分析処理で、形式による違いはありません。CSV.GZだけは、gzipファイルを並列で展開できないため、大きな追加時間が発生します。
| データセット | Parquet | ORC | CSV | CSV.GZ |
|---|---|---|---|---|
| 100万イベント | 55秒 | 55秒 | 55秒 | 55秒 |
| 500万イベント | 1.5分 | 1.5分 | 1.5分 | 1.5分 |
| 1,000万イベント | 1.5分 | 1.5分 | 1.5分 | 2分 |
| 2,000万イベント | 2分 | 2分 | 2分 | 2.5分 |
| 5,000万イベント | 2分 | 2分 | 2分 | 3分 |
| 1億イベント | 2.5分 | 2.5分 | 2.5分 | 4.5分 |
Parquet、ORC、CSVの前処理時間はほぼ同じです。入力形式にかかわらず、分析計算が大部分を占めるためです。一方、CSV.GZの前処理は規模が大きくなると大幅に遅くなります。100万件では約1分ですが、1億件では4分を超えます。gzip圧縮ファイルは分割して並列処理できないため、分析を開始する前の展開処理がデータ量に応じて増加します。
アップロード時間と前処理時間の両方を考慮すると、形式の選択は明確になります。
| 1,000万イベント(100Mbps) | ファイルサイズ | アップロード | 前処理 | 合計 |
|---|---|---|---|---|
| Parquet | 301MB | 30秒 | 1.5分 | 約2分 |
| ORC | 395MB | 40秒 | 1.5分 | 約2.2分 |
| CSV | 2.2GB | 4分 | 1.5分 | 約5.5分 |
| CSV.GZ | 215MB | 21秒 | 2分 | 約2.5分 |
| 5,000万イベント(100Mbps) | ファイルサイズ | アップロード | 前処理 | 合計 |
|---|---|---|---|---|
| Parquet | 1.7GB | 3分 | 2分 | 約5分 |
| ORC | 1.9GB | 3.2分 | 2分 | 約5.2分 |
| CSV | 11.1GB | 18分 | 2分 | 約20分 |
| CSV.GZ | 1.1GB | 2分 | 3分 | 約5分 |
大規模になると、ParquetとORCが明らかに優れています。ファイルサイズが大幅に小さいためです。主なボトルネックはアップロード時間です。CSV.GZを除けば、前処理時間はどの形式でもほぼ同じです。CSV.GZでは、展開にかかる時間がデータ量とともに増加します。
どの形式を使うべきですか?
Gzipの場合はどうなりますか?
CSV.GZファイルは生のCSVより90%小さいため、遅い回線では有効です。ただし、組み込みの圧縮機能を備え、直接クエリを実行できるParquetやORCとは異なり、gzipファイルは処理前に完全に展開する必要があります。また、gzipは並列展開に対応していません。5,000万件以上では、CSV.GZの前処理に3~4.5分かかるのに対し、他の形式では約2分です。高速回線なら、多少大きくてもParquetをアップロードする方がほとんどの場合に適しています。
非常に遅い10Mbpsの回線で、大きなCSVを扱う場合は、gzipを使う意味があります。gzip -k data.csvMac/Linuxでは、Windowsでは7-Zipをお使いください。
基準となるデータセットを読み込んだ後、新しいデータが届くたびにすべてを再アップロードする必要はありません。ProcessMindは差分読み込み(増分アップロード)に対応しているため、既存のデータセットに新しいイベントを追加できます。
仕組み:
**パフォーマンスへの効果は大きくなります。**データセット全体を毎回再アップロードするのではなく、新しく追加されたデータだけをアップロードできます。
| シナリオ | 全体の再アップロード | 差分アップロード | 短縮時間 |
|---|---|---|---|
| 1,000万件の基準データ+新規50万件(100Mbps) | アップロード4分 | アップロード5秒 | 約4分 |
| 2,000万件の基準データ+新規200万件(100Mbps) | アップロード7分 | アップロード44秒 | 約6分 |
| 5,000万件の基準データ+新規500万件(100Mbps) | アップロード18分 | アップロード2分 | 約16分 |
差分アップロード後は、統合されたデータセット全体に対して前処理が再実行され、1~2.5分かかります。ただし、すでにアップロードしたデータを再送信する時間は不要です。
差分読み込みは、次の用途に適しています:
差分ファイルには、元のアップロードと同じファイル形式と列構造を使用してください。詳しくは増分データ読み込みガイドをご覧ください。
数GBを超えるデータセットや定期的なアップロードでは、ブラウザーよりもスクリプトやコマンドラインツールの方が信頼性が高くなります。ブラウザーでは、タイムアウトしたり、メモリを過剰に消費したり、ネットワークが中断した際に進行状況が失われたりする可能性があります。
大容量ファイルでAPIが適している理由:
curlなどのツールで、転送状況をリアルタイムに確認できます。curlを使った例:
# Upload a Parquet file directly using a presigned URL
curl -X PUT "$PRESIGNED_URL" --upload-file data.parquetProcessMindは、クラウドストレージへの直接アップロードを認証する署名付きURLを提供します。APIキー以外の認証情報は必要ありません。ProcessMindのUIにあるデータセット設定メニューから、署名付きアップロードURLを直接コピーすることもできます。
完全なBash、JavaScript、Pythonの例については、APIドキュメントをご覧ください。署名付きURLの取得、差分ファイルのアップロード、大規模なデータセットのプログラムによる処理方法を説明しています。
アクティビティ名の変更、マッピングの変更、グループ化の追加などによってプロセスモデルを改善する場合、更新が必要なのはモデルに依存する計算だけです。基盤となるデータはそのまま保持されます。
| データセット | 完全な前処理 | モデル変更 | 短縮時間 |
|---|---|---|---|
| 100万イベント | 55秒 | 約14秒 | 75% |
| 200万イベント | 1分 | 約16秒 | 73% |
| 1,000万イベント | 1.5分 | 約20秒 | 78% |
| 2,000万イベント | 2分 | 約23秒 | 81% |
| 5,000万イベント | 2分 | 約37秒 | 69% |
| 1億イベント | 2.5分 | 約52秒 | 65% |
モデル変更が速いのは、データセットのサイズに応じて増加する初回のデータ読み込みがすでに完了しているためです。再実行されるのは、アクティビティのマッピング、遷移、バリアントなど、モデルに依存する集計処理だけです。2,000万件までのデータセットなら、モデル変更は25秒未満で完了します。1億件でも1分未満で、完全な前処理より大幅に短時間です。
データを読み込んだ後、分析中に発生する応答時間は以下のとおりです。数値は複数回のベンチマーク実行における中央値です。各ダッシュボードコンポーネントは独立してクエリを実行し、並列に読み込まれます。
| データセット | 統計 | プロセスフロー | バリアント | カテゴリ | データブラウザー | アニメーション |
|---|---|---|---|---|---|---|
| 100K | 0.6秒 | 1.5秒 | 1.1秒 | 1.5秒 | 1.2秒 | 1.4秒 |
| 1M | 0.6秒 | 1.6秒 | 1.4秒 | 1.9秒 | 1.5秒 | 2.0秒 |
| 5M | 0.6秒 | 2.5秒 | 1.8秒 | 2.4秒 | 1.3秒 | 2.1秒 |
| 10M | 0.6秒 | 3.4秒 | 2.2秒 | 2.5秒 | 1.6秒 | 2.4秒 |
| 20M | 0.6秒 | 3.9秒 | 2.7秒 | 3.3秒 | 1.9秒 | 3.6秒 |
| 50M | 0.6秒 | 5.1秒 | 4.2秒 | 5.7秒 | 1.6秒 | 2.7秒 |
| 100M | 0.6秒 | 7.2秒 | 3.5秒 | 4.7秒 | 1.6秒 | 5.0秒 |
注目すべき傾向:
**要点:**推奨される1~1,000万件のイベント数であれば、すべてのダッシュボードコンポーネントが3.5秒未満で応答します。5,000万件でも、フィルター適用時のほとんどのクエリは2~4秒で返ります。フィルターなしのプロセスフローとカテゴリ表示だけが、5,000万件以上のデータセットで5~6秒に達します。
このガイドで最も重要なアドバイスは、最大のデータセットから始めないことです。
反復的なアプローチ
数字が示すとおりです:
| アプローチ | アップロード(100Mbps) | 前処理 | 合計待ち時間 | ダッシュボード速度 |
|---|---|---|---|---|
| 100万件から開始 | 22秒 | 55秒 | 約1.5分 | 1~2秒 |
| 500万件から開始 | 2分 | 1.5分 | 約3.5分 | 1~2.5秒 |
| 5,000万件から開始 | 18分 | 2分 | 約20分 | 1~6秒 |
多くの組織では、100万~500万件のイベントで、具体的な改善案を得るには十分だと分かっています。プロセスの挙動は、1,000万件に達する前に安定します。それ以上追加しても、すでに確認したパターンの重複が増えることがほとんどです。
100万件のイベントを含むParquetファイルは34MBで、3秒でアップロードできます。5,000万件の場合と同じプロセスマップが得られるなら、18分も待つ必要があるでしょうか。
上の数字は明確な傾向を示しています。100万~500万件では、アップロードは数秒、前処理は2分未満、ダッシュボードの応答は1~2.5秒です。5,000万件では、100Mbpsの回線でアップロードに20分かかり、ダッシュボードの応答も3~6秒まで遅くなります。体感は大きく異なります。
つまり、本当の問いは「ツールはどれだけ速いか」ではありません。「実際にどれだけのデータが必要か」です。答えは、ほとんどの場合、想定より少なくなります。
まずは1つの国、1つの部門、または1つの製品ラインを分析します。
これは制限を設けるということではありません。明確さを高めるためです。分割した分析は、全体平均よりも焦点の合った結果を示します。
分割が有効な理由:
**例:**8か国にまたがる4,200万件の出荷イベントを持つ欧州の物流会社の場合です。
分割の軸
地理:国、地域、拠点。組織:事業部門、部門。製品:製品ライン、カテゴリ。時間:会計年度、四半期。顧客:セグメント、チャネル。
**アップロード前に標準経路を除外します。**この方法でデータセットを90~95%削減できます。
多くの業務プロセスは80対20の法則に従います。大半のケースは、標準的で成功する経路をたどります。例外、コンプライアンス違反、プロセス逸脱を探している場合、そのデータは必要ありません。
**例:**120万件の発注(イベント840万件)を含む調達から支払いまでのプロセスの場合です。
コンプライアンス上の問題を分析する場合は、例外ケースだけをエクスポートしてください。イベント数は840万件(1.9GB)から67万件(150MB)へ92%削減できます。100Mbpsでのアップロード時間は3分から15秒に短縮されます。Parquetでエクスポートすれば15MBとなり、2秒未満でアップロードできます。
エクスポート前にフィルタリングする方法
ステータス(却下、キャンセル、例外など)、特定のアクティビティ(「Rejection」や「Manual Override」を含むケースなど)、ケースの所要時間(想定より長くかかったケースなど)、または特定の期間や事業部門でフィルタリングします。
エクスポートする各列には、帯域幅、ストレージ、処理時間が必要です。列を慎重に選ぶことは、効果の大きい最適化の1つです。
含めない列:
**例:**45列を含むSAPの発注イベント180万件のエクスポートを、必要な12列に絞った場合です。
**重要な列:**CaseId、Activity、Timestamp、およびステータス、金額、カテゴリ、地域などの業務属性をいくつか含めます。それ以外は、おそらくノイズです。
大規模なデータセットが本当に必要な分析上の問いもあります。どのような場合かを理解して、適切に判断してください。
5,000万件以上のイベントが必要なら、事前に計画してください。Parquet形式を使うと、11GBのCSVを1.7GBに削減して前処理を高速化します。信頼性の高い転送にはAPIを使い、可能であれば高速なネットワーク接続を利用してください。初回の読み込みが完了した後は、ダッシュボードを高速に利用できます。
上記のセクションではデータ量を扱いました。応答性を左右するもう半分は、モデルとダッシュボードの構築方法です。
プロセスマイニングのパフォーマンスを理解する最善の方法は、自社のデータで実際に試すことです。
**サンプルから始めます。**直近の期間から100万件のイベントをParquet形式でエクスポートし、アップロードします。最初のモデルを構築し、どれだけ速く反復できるかを確認してください。
**このガイドの手法を適用します。**列指向形式を使い、例外をフィルタリングし、地域ごとに分割し、不要な列を削除します。それぞれの最適化が次の改善につながります。
**意図を持って規模を拡大します。**100万件でプロセスを理解したら、さらにデータが必要か判断します。通常は必要ありません。必要な場合は、再アップロードするのではなく、差分読み込みでデータを追加してください。
無料トライアルを開始して、これらのベンチマークを実際にお試しください。データセットのサイズ設定やエクスポートの最適化については、お問い合わせください。これまでに数百の組織を支援し、データ量と分析速度の適切なバランスを見つけてきました。
DMAICプロセス、シックスシグマプロセス、リーンプロセス改善の手法を学び、測定可能な業務成果につなげます。
CelonisのプロセスマイニングとProcessMindを比較し、プロセス、予算、目的に合うソフトウェアを見つけます。
Fluxicon DiscoとProcessMindを機能、料金、ユースケースの観点で比較し、チームに適したプロセスマイニングプラットフォームを選びます。
Process Mining、モデリング、シミュレーションの観点でProcessMindとSAP Signavioを比較し、ビジネスに適した選択肢を検討します。
クレジットカード不要、待ち時間なしですぐに利用を開始できます。組織の業務の進め方を、明確でつながりのあるプロセス設計に変えます。
プロセスアーキテクチャを構築し、所有者と管理項目を定義して、あらゆる階層で役割と責任をそろえます。
無料トライアルを開始し、プロセスのガバナンス、管理、継続的改善を支える信頼できる基盤を1つ構築します。
Cookieを使用して、利用体験の改善、コンテンツのパーソナライズ、トラフィックの分析を行っています。「すべて受け入れる」をクリックすると、Cookieの使用に同意したものとみなされます。