精益流程改进:数据驱动指南
了解DMAIC流程、六西格玛流程和精益流程改进工具,推动业务取得可衡量的成果。
流程挖掘性能取决于三个因素:上传多少数据、如何组织数据,以及系统如何处理数据。本指南将通过真实基准测试和实用方法,全面介绍这三个方面,帮助您改善结果。
我们公开所有数据。将这些数据与市场上的任何流程挖掘工具进行比较。
关键要点
将数据上传到ProcessMind后,会发生三件事。以下是时间的具体去向:
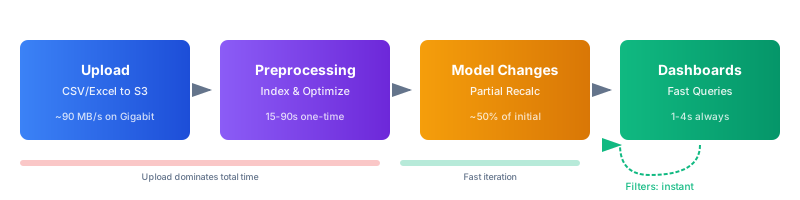
**上传(占总耗时的大部分)。**您的文件需要通过互联网传输到我们的云基础设施。对于大文件,这是瓶颈。受网络带宽限制,5000万条事件的CSV文件(11GB)在千兆网络下需要2分钟,在100Mbps下需要18分钟,在10Mbps下则超过3小时。同样的数据使用Parquet格式仅1.7GB,耗时分别降至19秒、3分钟和28分钟。这也是应使用Parquet或ORC等列式格式,或缩小数据集的主要原因。
**预处理(一次性成本,约30秒至2.5分钟)。**上传完成后,我们会将数据转换为经过优化的列式存储:为事件建立索引、预先计算活动转换、识别流程变体并计算汇总统计信息。小型数据集需要30秒,1亿条事件最多需要2.5分钟。每次上传只需承担一次该成本,之后即可持续受益。
**模型变更(部分重新计算,6至52秒)。**当您通过添加或删除活动,或更改映射来修改流程模型时,系统只会更新依赖模型的计算。小型数据集需要6秒,1亿条事件最多需要52秒,远快于完整预处理。筛选条件的变更会立即生效。
仪表板性能:始终快速
**仪表板运行快速。**预处理完成后,数据集规模不超过1000万条事件时,仪表板交互响应时间低于2.5秒。即使达到5000万条事件,大多数查询也能在2至5秒内返回。只有1亿条以上数据集的流程顺序接近7秒。请参阅下方的详细响应时间。
我们在预处理上投入了大量工作,让需要数小时分析的过程也能即时完成。
数据加载完成后,多项特征会决定查询速度。了解这些特征,有助于您设计更合理的导出方案并建立合理预期。
**活动数量很重要。**包含10至20个不同活动的流程模型最为理想。活动超过50个后,流程顺序需要更长时间计算,也更难理解。节点和边过多会造成视觉噪声。如果导出数据包含大量活动,请考虑将相关步骤分组。
**变体多样性会影响计算。**80%的案例遵循5种变体的流程,比每个案例都采用独特路径的流程更易于分析。高变异并非坏事,通常还意味着存在真实问题,但您应预期查询时间会略有增加。
**列越多,扫描量越大。**您包含的每个属性都会建立索引并参与查询。核心列CaseId、Activity和Timestamp始终是必需的。其他列有助于筛选和分类,但每增加一列都会带来额外开销。
**案例越长,耗时越久。**包含50个事件的案例比包含5个事件的案例需要更多计算。如果您的流程案例跨越数百个事件,查询速度会按比例下降。这是流程挖掘本身的特性,并非某个工具特有的问题。
了解预期结果有助于您做好规划。以下基准测试运行于生产环境的AWS基础设施,包含真实网络延迟,结果取多次测试的平均值。我们针对每种数据规模测试了50多种查询类型。
下表展示了不同数据规模下的实际预期。对于较大的文件,尤其是在较慢的网络连接下,上传时间占主导地位,是总等待时间中影响最大的因素。
| 数据集 | 实际事件数 | 文件大小 | 上传(1Gbps) | 上传(100Mbps) | 上传(50Mbps) | 上传(10Mbps) | 预处理 |
|---|---|---|---|---|---|---|---|
| 100K | 125,260 | 22MB | < 1秒 | 2秒 | 4秒 | 22秒 | 35秒 |
| 500K | 626,300 | 110MB | 1秒 | 11秒 | 22秒 | 2分钟 | 45秒 |
| 1M | 1,253,424 | 221MB | 3秒 | 22秒 | 44秒 | 4分钟 | 55秒 |
| 2M | 2,506,848 | 443MB | 5秒 | 44秒 | 1.5分钟 | 7分钟 | 1分钟 |
| 5M | 4,996,877 | 1.1GB | 13秒 | 2分钟 | 4分钟 | 18分钟 | 1.5分钟 |
| 10M | 12,511,867 | 2.2GB | 25秒 | 4分钟 | 7分钟 | 37分钟 | 1.5分钟 |
| 20M | 25,023,734 | 4.4GB | 50秒 | 7分钟 | 15分钟 | 1.2小时 | 2分钟 |
| 50M | 62,559,335 | 11.1GB | 2分钟 | 18分钟 | 37分钟 | 3小时 | 2分钟 |
| 100M | 125,118,670 | 22.3GB | 4分钟 | 37分钟 | 1.2小时 | 6小时 | 2.5分钟 |
文件大小以未压缩CSV为准,采用典型事件日志结构(CaseId、Activity、Timestamp,以及5至8个业务属性)。文件大小还会因列数和内容而有所不同。
1Gbps上传耗时的测量基于向AWS eu-central-1传输时88MB/s的有效吞吐量。其他速度按实际吞吐量推算:50Mbps约为5MB/s,100Mbps约为10MB/s,10Mbps约为1MB/s。实际吞吐量取决于您的网络、与数据中心的距离以及当前负载。
**关键结论:**无论数据规模如何,预处理时间基本稳定在1至2.5分钟之间。上传时间则随文件大小线性增长。缩小文件大小是最值得优先采用的优化措施。
上传文件的格式会显著影响上传速度和预处理时间。ProcessMind支持CSV、Parquet、ORC、Excel和XES。对于大型数据集,Parquet和ORC在文件大小和处理速度方面都明显优于CSV。
| 数据集 | CSV | Parquet | ORC | CSV.GZ |
|---|---|---|---|---|
| 1M条事件 | 221MB | 34MB | 39MB | 20MB |
| 5M条事件 | 1.1GB | 151MB | 197MB | 107MB |
| 10M条事件 | 2.2GB | 301MB | 395MB | 215MB |
| 20M条事件 | 4.4GB | 603MB | 791MB | 430MB |
| 50M条事件 | 11.1GB | 1.7GB | 1.9GB | 1.1GB |
| 100M条事件 | 22.3GB | 3.4GB | 3.7GB | 2.2GB |
Parquet文件比CSV小85%,ORC文件小82%。两者都是内置压缩的列式格式,无需额外处理。您的ETL工具或数据平台,例如Spark、Databricks、dbt或BigQuery,很可能已经支持导出为Parquet或ORC。
文件大小只是其中一半。上传后,数据会经过依赖格式的数据摄取和分析计算,包括事件索引,以及转换和变体计算。分析步骤占主要耗时,且对所有格式都相同。CSV.GZ是唯一会显著增加额外耗时的格式,因为gzip文件无法拆分进行并行解压。
| 数据集 | Parquet | ORC | CSV | CSV.GZ |
|---|---|---|---|---|
| 1M条事件 | 55秒 | 55秒 | 55秒 | 55秒 |
| 5M条事件 | 1.5分钟 | 1.5分钟 | 1.5分钟 | 1.5分钟 |
| 10M条事件 | 1.5分钟 | 1.5分钟 | 1.5分钟 | 2分钟 |
| 20M条事件 | 2分钟 | 2分钟 | 2分钟 | 2.5分钟 |
| 50M条事件 | 2分钟 | 2分钟 | 2分钟 | 3分钟 |
| 100M条事件 | 2.5分钟 | 2.5分钟 | 2.5分钟 | 4.5分钟 |
Parquet、ORC和CSV的预处理时间几乎相同,因为无论输入格式如何,分析计算都占主要耗时。但CSV.GZ的预处理会明显变慢,从100万条事件时约1分钟,增加到1亿条事件时超过4分钟。Gzip压缩文件无法拆分并行处理,因此解压会在分析开始前增加一个不断扩大的步骤。
同时考虑上传时间和预处理时间后,格式选择就很明确了:
| 1000万条事件(100Mbps) | 文件大小 | 上传 | 预处理 | 总计 |
|---|---|---|---|---|
| Parquet | 301MB | 30秒 | 1.5分钟 | 约2分钟 |
| ORC | 395MB | 40秒 | 1.5分钟 | 约2.2分钟 |
| CSV | 2.2GB | 4分钟 | 1.5分钟 | 约5.5分钟 |
| CSV.GZ | 215MB | 21秒 | 2分钟 | 约2.5分钟 |
| 5000万条事件(100Mbps) | 文件大小 | 上传 | 预处理 | 总计 |
|---|---|---|---|---|
| Parquet | 1.7GB | 3分钟 | 2分钟 | 约5分钟 |
| ORC | 1.9GB | 3.2分钟 | 2分钟 | 约5.2分钟 |
| CSV | 11.1GB | 18分钟 | 2分钟 | 约20分钟 |
| CSV.GZ | 1.1GB | 2分钟 | 3分钟 | 约5分钟 |
在大规模场景下,Parquet和ORC明显更优,因为文件大小小得多。上传时间是主要瓶颈。除CSV.GZ会产生不断增加的解压开销外,所有格式的预处理时间大致相同。
应选择哪种格式?
Gzip怎么样?
CSV.GZ文件比原始CSV小90%,有助于在慢速网络下传输。但与内置压缩且可直接查询的Parquet和ORC不同,gzip文件必须先完整解压才能处理,而且gzip不支持并行解压。在5000万条以上事件的场景中,CSV.GZ预处理需要3至4.5分钟,而其他格式约需2分钟。在高速网络下,上传稍大的Parquet文件几乎总是更好的选择。
如果您的网络非常慢,例如10Mbps,并且手头是大型CSV文件,gzip仍然有用:gzip -k data.csv在Mac或Linux上使用,Windows上使用7-Zip。
基准数据集加载完成后,新数据到达时无需重新上传全部内容。ProcessMind支持增量加载,也就是增量上传,您可以将新事件追加到现有数据集中。
工作方式:
**性能影响十分明显。**您无需每次都重新上传不断增长的数据集,只需上传新增内容:
| 场景 | 完整重新上传 | 增量上传 | 节省时间 |
|---|---|---|---|
| 1000万条基础事件+50万条新增事件(100Mbps) | 上传4分钟 | 上传5秒 | 约4分钟 |
| 2000万条基础事件+200万条新增事件(100Mbps) | 上传7分钟 | 上传44秒 | 约6分钟 |
| 5000万条基础事件+500万条新增事件(100Mbps) | 上传18分钟 | 上传2分钟 | 约16分钟 |
增量上传后,系统会再次对合并后的数据集执行预处理,耗时仍为1至2.5分钟。但对于已经上传的数据,您可以节省全部上传时间。
增量加载适用于:
增量文件必须使用与原始上传相同的文件格式和列结构。详情请参阅增量数据加载指南。
对于超过几GB的数据集或定期上传任务,脚本或命令行工具比浏览器上传更可靠。浏览器可能超时、占用过多内存,或在网络中断时丢失进度。
API为何更适合大型文件:
curl等工具可以显示实时传输进度。使用curl的示例:
# Upload a Parquet file directly using a presigned URL
curl -X PUT "$PRESIGNED_URL" --upload-file data.parquetProcessMind提供预签名URL,用于授权直接上传到云存储。除API密钥外,无需其他凭据。您也可以直接从ProcessMind界面的数据集设置菜单复制预签名上传URL。
完整的Bash、JavaScript和Python示例请参阅API文档,其中包括如何获取预签名URL、上传增量文件,以及以编程方式处理大型数据集。
当您通过重命名活动、更改映射或添加分组来完善流程模型时,只需更新依赖模型的计算,基础数据保持不变:
| 数据集 | 完整预处理 | 模型变更 | 节省时间 |
|---|---|---|---|
| 100万条事件 | 55秒 | 约14秒 | 75% |
| 200万条事件 | 1分钟 | 约16秒 | 73% |
| 1000万条事件 | 1.5分钟 | 约20秒 | 78% |
| 2000万条事件 | 2分钟 | 约23秒 | 81% |
| 5000万条事件 | 2分钟 | 约37秒 | 69% |
| 1亿条事件 | 2.5分钟 | 约52秒 | 65% |
模型变更速度快,是因为随数据集规模增长的初始数据加载步骤已经完成。系统只会再次运行依赖模型的聚合步骤,包括活动映射、转换和变体。对于不超过2000万条事件的数据集,模型变更可在25秒内完成。即使达到1亿条事件,也只需不到1分钟,远快于完整预处理。
数据加载完成后,以下是您在分析过程中会体验到的响应时间。下表数据为多次基准测试的中位数。每个仪表板组件都会独立查询并行加载:
| 数据集 | 统计数据 | 流程顺序 | 变体 | 类别 | 数据浏览器 | 动画 |
|---|---|---|---|---|---|---|
| 100K | 0.6s | 1.5s | 1.1s | 1.5s | 1.2s | 1.4s |
| 1M | 0.6s | 1.6s | 1.4s | 1.9s | 1.5s | 2.0s |
| 5M | 0.6s | 2.5s | 1.8s | 2.4s | 1.3s | 2.1s |
| 10M | 0.6s | 3.4s | 2.2s | 2.5s | 1.6s | 2.4s |
| 20M | 0.6s | 3.9s | 2.7s | 3.3s | 1.9s | 3.6s |
| 50M | 0.6s | 5.1s | 4.2s | 5.7s | 1.6s | 2.7s |
| 100M | 0.6s | 7.2s | 3.5s | 4.7s | 1.6s | 5.0s |
值得关注的规律:
**结论:**在建议的数据集规模,即100万至1000万条事件下,每个仪表板组件的响应时间都低于3.5秒。即使达到5000万条事件,应用筛选器后,大多数查询也能在2至4秒内返回。只有未应用筛选器的流程顺序和5000万条以上数据集的类别视图会达到5至6秒。
这是本指南最重要的建议:不要从最大的数据集开始。
迭代式方法
数据已经说明了一切:
| 方法 | 上传(100Mbps) | 预处理 | 总等待时间 | 仪表板速度 |
|---|---|---|---|---|
| 从100万条事件开始 | 22秒 | 55秒 | 约1.5分钟 | 1至2秒 |
| 从500万条事件开始 | 2分钟 | 1.5分钟 | 约3.5分钟 | 1至2.5秒 |
| 从5000万条事件开始 | 18分钟 | 2分钟 | 约20分钟 | 1至6秒 |
大多数组织发现,100万至500万条事件已经足以提供可执行洞察。流程行为通常在1000万条事件之前就趋于稳定。再增加数据,通常只是重复已有模式。
如果您的100万条事件Parquet文件只有34MB,3秒即可上传,并且能生成与5000万条事件相同的流程图,为什么还要等待18分钟?
上述数据说明了一个清晰的结论:在100万至500万条事件的规模下,上传只需几秒,预处理不到2分钟,仪表板响应时间为1至2.5秒。达到5000万条事件后,在100Mbps网络下上传需要等待20分钟,仪表板响应也会降至3至6秒。两种体验差异明显。
因此,真正的问题不是“工具有多快”,而是“我实际需要多少数据?”答案几乎总是比您想象的少。
先分析一个国家、一个部门或一条产品线。
这不是限制,而是为了获得清晰结论。分段分析比全局平均值更容易产生精准洞察。
分段分析为何有效:
**示例:**一家欧洲物流公司在8个国家拥有4200万条运输事件:
分段维度
地理维度,包括国家、地区和站点;组织维度,包括业务单元和部门;产品维度,包括产品线和类别;时间维度,包括财年和季度;客户维度,包括细分市场和渠道。
**上传前排除标准路径。**这项方法可以将数据集缩小90%至95%。
大多数业务流程遵循二八法则。绝大多数案例都会沿着标准且成功的路径完成。如果您要寻找例外、合规违规或流程偏差,就不需要这些数据。
**示例:**一个包含120万张采购订单、840万条事件的采购到付款流程:
如果您正在分析合规问题,只需导出例外案例即可。数据量可减少92%,从840万条事件(1.9GB)降至67万条事件(150MB)。在100Mbps网络下,上传时间从3分钟降至15秒。导出为Parquet后文件仅15MB,上传时间还可降至2秒以内。
如何在导出前筛选
按状态筛选,例如已拒绝、已取消或例外;按特定活动筛选,例如包含“拒绝”或“人工覆盖”的案例;按案例持续时间筛选,例如耗时超过预期的案例;或按特定时间段或业务单元筛选。
您导出的每一列都会增加带宽、存储和处理成本。谨慎选择列,是最值得采用的优化措施之一。
可以省略的内容:
**示例:**一个包含180万条采购订单事件、45列的SAP导出文件,经过处理后只保留12个必要列:
**真正重要的列:**CaseId、Activity、Timestamp,以及少量业务属性,例如状态、金额、类别和地区。其他内容很可能只是噪声。
有些分析问题确实需要大型数据集。了解适用场景有助于您做出正确判断:
如果您需要5000万条以上事件,请提前规划:使用Parquet格式,将11GB的CSV缩小至1.7GB并加快预处理;使用API确保传输可靠;条件允许时使用高速网络连接。首次加载完成后,仪表板仍能保持快速响应。
以上部分讨论的是数据量。响应速度的另一半取决于模型和仪表板的构建方式:
了解流程挖掘性能的最佳方式,是使用您自己的数据亲自体验。
**从样本开始。**从近期时间段导出100万条事件,使用Parquet格式上传。构建您的第一个模型,感受迭代速度。
**应用本指南中的方法。**使用列式格式,筛选例外,按地区分段,并删除不必要的列。每项优化都会在上一项基础上继续发挥作用。
**有计划地扩展。**使用100万条事件了解流程后,再决定是否需要更多数据。通常并不需要。如果确实需要,请使用增量加载追加数据,而不是重新上传。
开始免费试用,亲自体验这些基准数据。如果需要帮助确定数据集规模或优化导出,请联系我们。我们已帮助数百家组织在数据量与分析速度之间找到合适平衡。
了解DMAIC流程、六西格玛流程和精益流程改进工具,推动业务取得可衡量的成果。
比较Celonis流程挖掘与ProcessMind,找到适合您流程、预算和目标的软件。
从功能、定价和使用场景等方面比较Fluxicon Disco与ProcessMind,为您的团队选择合适的流程挖掘平台。
比较ProcessMind与SAP Signavio在流程挖掘、建模和模拟方面的能力,为您的企业选择合适的方案。
无需信用卡,无需等待,即可立即访问。将您组织的工作方式转化为清晰、互联的流程设计。
构建流程架构,定义所有权和控制措施,并在各个层级统一角色与职责。
开始免费试用,为流程治理、管理和持续改进建立可靠的统一基础。