Nástroje ETL pro process mining: co potřebujete
Kdy process mining potřebuje ETL, co musí obsahovat export a proč ProcessMind načte výstup z vašeho stávajícího datového toku.

Potřebujete pro process mining ETL?
Nástroje ETL získávají data ze zdrojových systémů, upravují je do použitelné podoby a načítají pro analýzu. V tomto článku se zaměříme na to, jaké úpravy dat projekt process mining skutečně potřebuje a čemu se můžete vyhnout. Nejde o přehled nástrojů pro datové pipeline. Pokud jeden systém umí exportovat záznamy a soubor obsahuje ID případu, aktivitu a časové razítko, můžete první analýzu často provést bez pipeline a načíst export tak, jak je.
Záleží na procesu, systémech, které ho podporují, a na tom, jak často je potřeba analýzu aktualizovat. Začněte s nejmenším exportem, který dokáže odpovědět na vaši otázku. Přípravu a automatizaci přidejte, až první analýza ukáže, že jsou potřeba.
ETL se vyplatí ve třech situacích:
- Proces probíhá v několika systémech. Záznamy je třeba spojit a sjednotit jejich identifikátory, abyste mohli sledovat jeden případ od začátku do konce.
- Zdrojová data nejsou v současné podobě použitelná. Před analýzou je třeba sjednotit názvy aktivit, časová razítka nebo identifikátory případů.
- Export se musí pravidelně opakovat. Pokud se data mění každý den a analýza musí držet krok, ruční export přestává být praktický.
To jsou důvody k přípravě dat, ne k vytvoření pipeline ještě před zodpovězením první otázky. Načtěte dostupná data, zjistěte, co chybí, a pak se rozhodněte, jak pokračovat.
Dlouho jsme předpokládali, že ETL musí být součástí produktu. Pak jsme se podívali na to, co už naši zákazníci používají. Datové sklady se budovaly zhruba dvacet let pod různými názvy, mimo jiné jako datová tržiště a datová jezera. Dnes už má většina firem použitelná data k dispozici. Proto jsme přestali vytvářet vlastní pipeline. Nahrajte export ze svých systémů, nebo nasměrujte pipeline, kterou váš tým už spravuje, do našeho API. Začněte s daty, která už máte.
Samostatnou pipeline můžete vynechat také v těchto případech:
- Proces se zaznamenává převážně v jednom systému.
- Potřebné záznamy lze exportovat.
- Export obsahuje ID případu, aktivitu a časové razítko.
- Soubor je dostatečně malý na ruční přípravu.
- Ověřujete, zda data dokážou odpovědět na vaši otázku.
Tabulka dobře poslouží k přejmenování sloupců, opravě zjevných nesrovnalostí a odstranění nepotřebných polí. Ruční příprava nemusí být trvalým řešením. Jakmile se ukáže, že analýza přináší užitek a data je třeba často aktualizovat, automatizujte opakující se kroky.
Co musí export obsahovat
Záznam událostí pro process mining potřebuje tři pole a jeden řádek pro každou událost.
| Pole | Co označuje | Co ověřit |
|---|---|---|
| ID případu | Instanci procesu, například objednávku nebo servisní požadavek | Stejné ID případu musí propojit všechny události dané instance |
| Aktivita | Jeden krok, který v procesu proběhl | Názvy musí rozlišovat skutečné kroky a být používané jednotně |
| Časové razítko | Kdy krok proběhl | Skutečné datum a čas, se stejným časovým pásmem ve všech kombinovaných zdrojích |
Atributy jako náklady, uživatel, tým, zákaznický segment nebo uhlíková stopa jsou volitelné. Právě díky nim ale získáte víc než jen přehled o procesu: každý zachovaný atribut můžete později použít jako filtr, rozdělení nebo metriku. V přehledu atributů datové sady se dozvíte, co vám jednotlivá pole umožní.
Pole může být ve zdrojových datech přítomné, a přesto nepoužitelné. Pokud se ID případu mezi systémy mění, události se nepropojí. Nekonzistentní názvy aktivit rozdělí jeden skutečný krok na tři. Časové razítko uložené jako text může události seřadit nesprávně. Než data namapujete, prohlédněte si export a nejprve ověřte tři povinná pole. Další informace o tom, co musí záznam obsahovat, najdete v článku Co potřebuje process mining.
Minimální dotaz pro záznam událostí
Pokud zdroj už ukládá jeden řádek pro každou aktivitu, stačí data vybrat pomocí dotazu. Tento příklad předpokládá tabulku s názvem process_events, která obsahuje případ, aktivitu a čas události:
SELECT
  case_id        AS case_id,
  activity_name  AS activity,
  event_time     AS timestamp
FROM process_events
WHERE case_id IS NOT NULL
  AND activity_name IS NOT NULL
  AND event_time IS NOT NULL
ORDER BY case_id, event_time;
Dotaz pojmenuje tři pole, vyřadí nepoužitelné řádky a seřadí události v rámci každého případu. Upravte názvy tabulky a sloupců podle svého zdroje a před načtením zkontrolujte vzorek případů. Každý případ by měl obsahovat očekávané události ve správném pořadí, které odpovídá tomu, jak práci vnímají lidé, kteří ji vykonávají.
Které kroky transformace jsou důležité
Transformace má napravit nedostatky, které by zkreslily analýzu. Ve většině případů stačí čtyři kroky.
-
Sjednoťte záznamy událostí
Každý výskyt aktivity uložte na samostatný řádek spolu s ID případu a časovým razítkem. Platí to i tehdy, když zdroj ukládá jednotlivé kroky procesu do samostatných sloupců. -
Připravte časová razítka k použití
Ověřte, že hodnoty představují skutečná data a časy, a zjistěte, zda jde o místní čas, nebo UTC. Sjednoťte časová pásma kombinovaných zdrojů, jinak bude pořadí událostí zavádějící. -
Sjednoťte názvy aktivit
Každý skutečný krok pojmenujte jedním názvem, v jednom jazyce a s jednotným pravopisem. Neslučujte kroky, které jen vypadají podobně, abyste zkrátili seznam. -
Zdroje spojujte jen v případě potřeby
Najděte identifikátor, který propojuje záznamy, a ověřte, že odpovídá. Spojení, které zdvojí události nebo vynechá případy, změní pohled na proces. Porovnejte proto počty záznamů před spojením a po něm.
Pokud export už obsahuje jeden řádek pro každou událost a všechna tři pole, není co transformovat. To je běžný výsledek, ne zkratka. Jak vytvořit záznam událostí pro process mining popisuje stejný postup na příkladech v Excelu a SQL.
Kam načíst záznam událostí?
Připravená data načtěte do platformy, ve které je budete analyzovat. Pro první kontrolu stačí jeden soubor: připravte ho, načtěte, prohlédněte si proces a upravte export podle toho, co data skutečně umožňují. Kvůli process mining nezavádějte novou vrstvu úložiště. Pokud váš tým už spravuje datový sklad nebo datové jezero, ponechte data tam a načtěte výstup, který toto prostředí vytváří.
Podrobnosti najdete na stránce Podporované formáty dat. Stejné formáty lze odeslat také naplánovanou úlohou přes data API, pokud nechcete soubory nahrávat ručně.
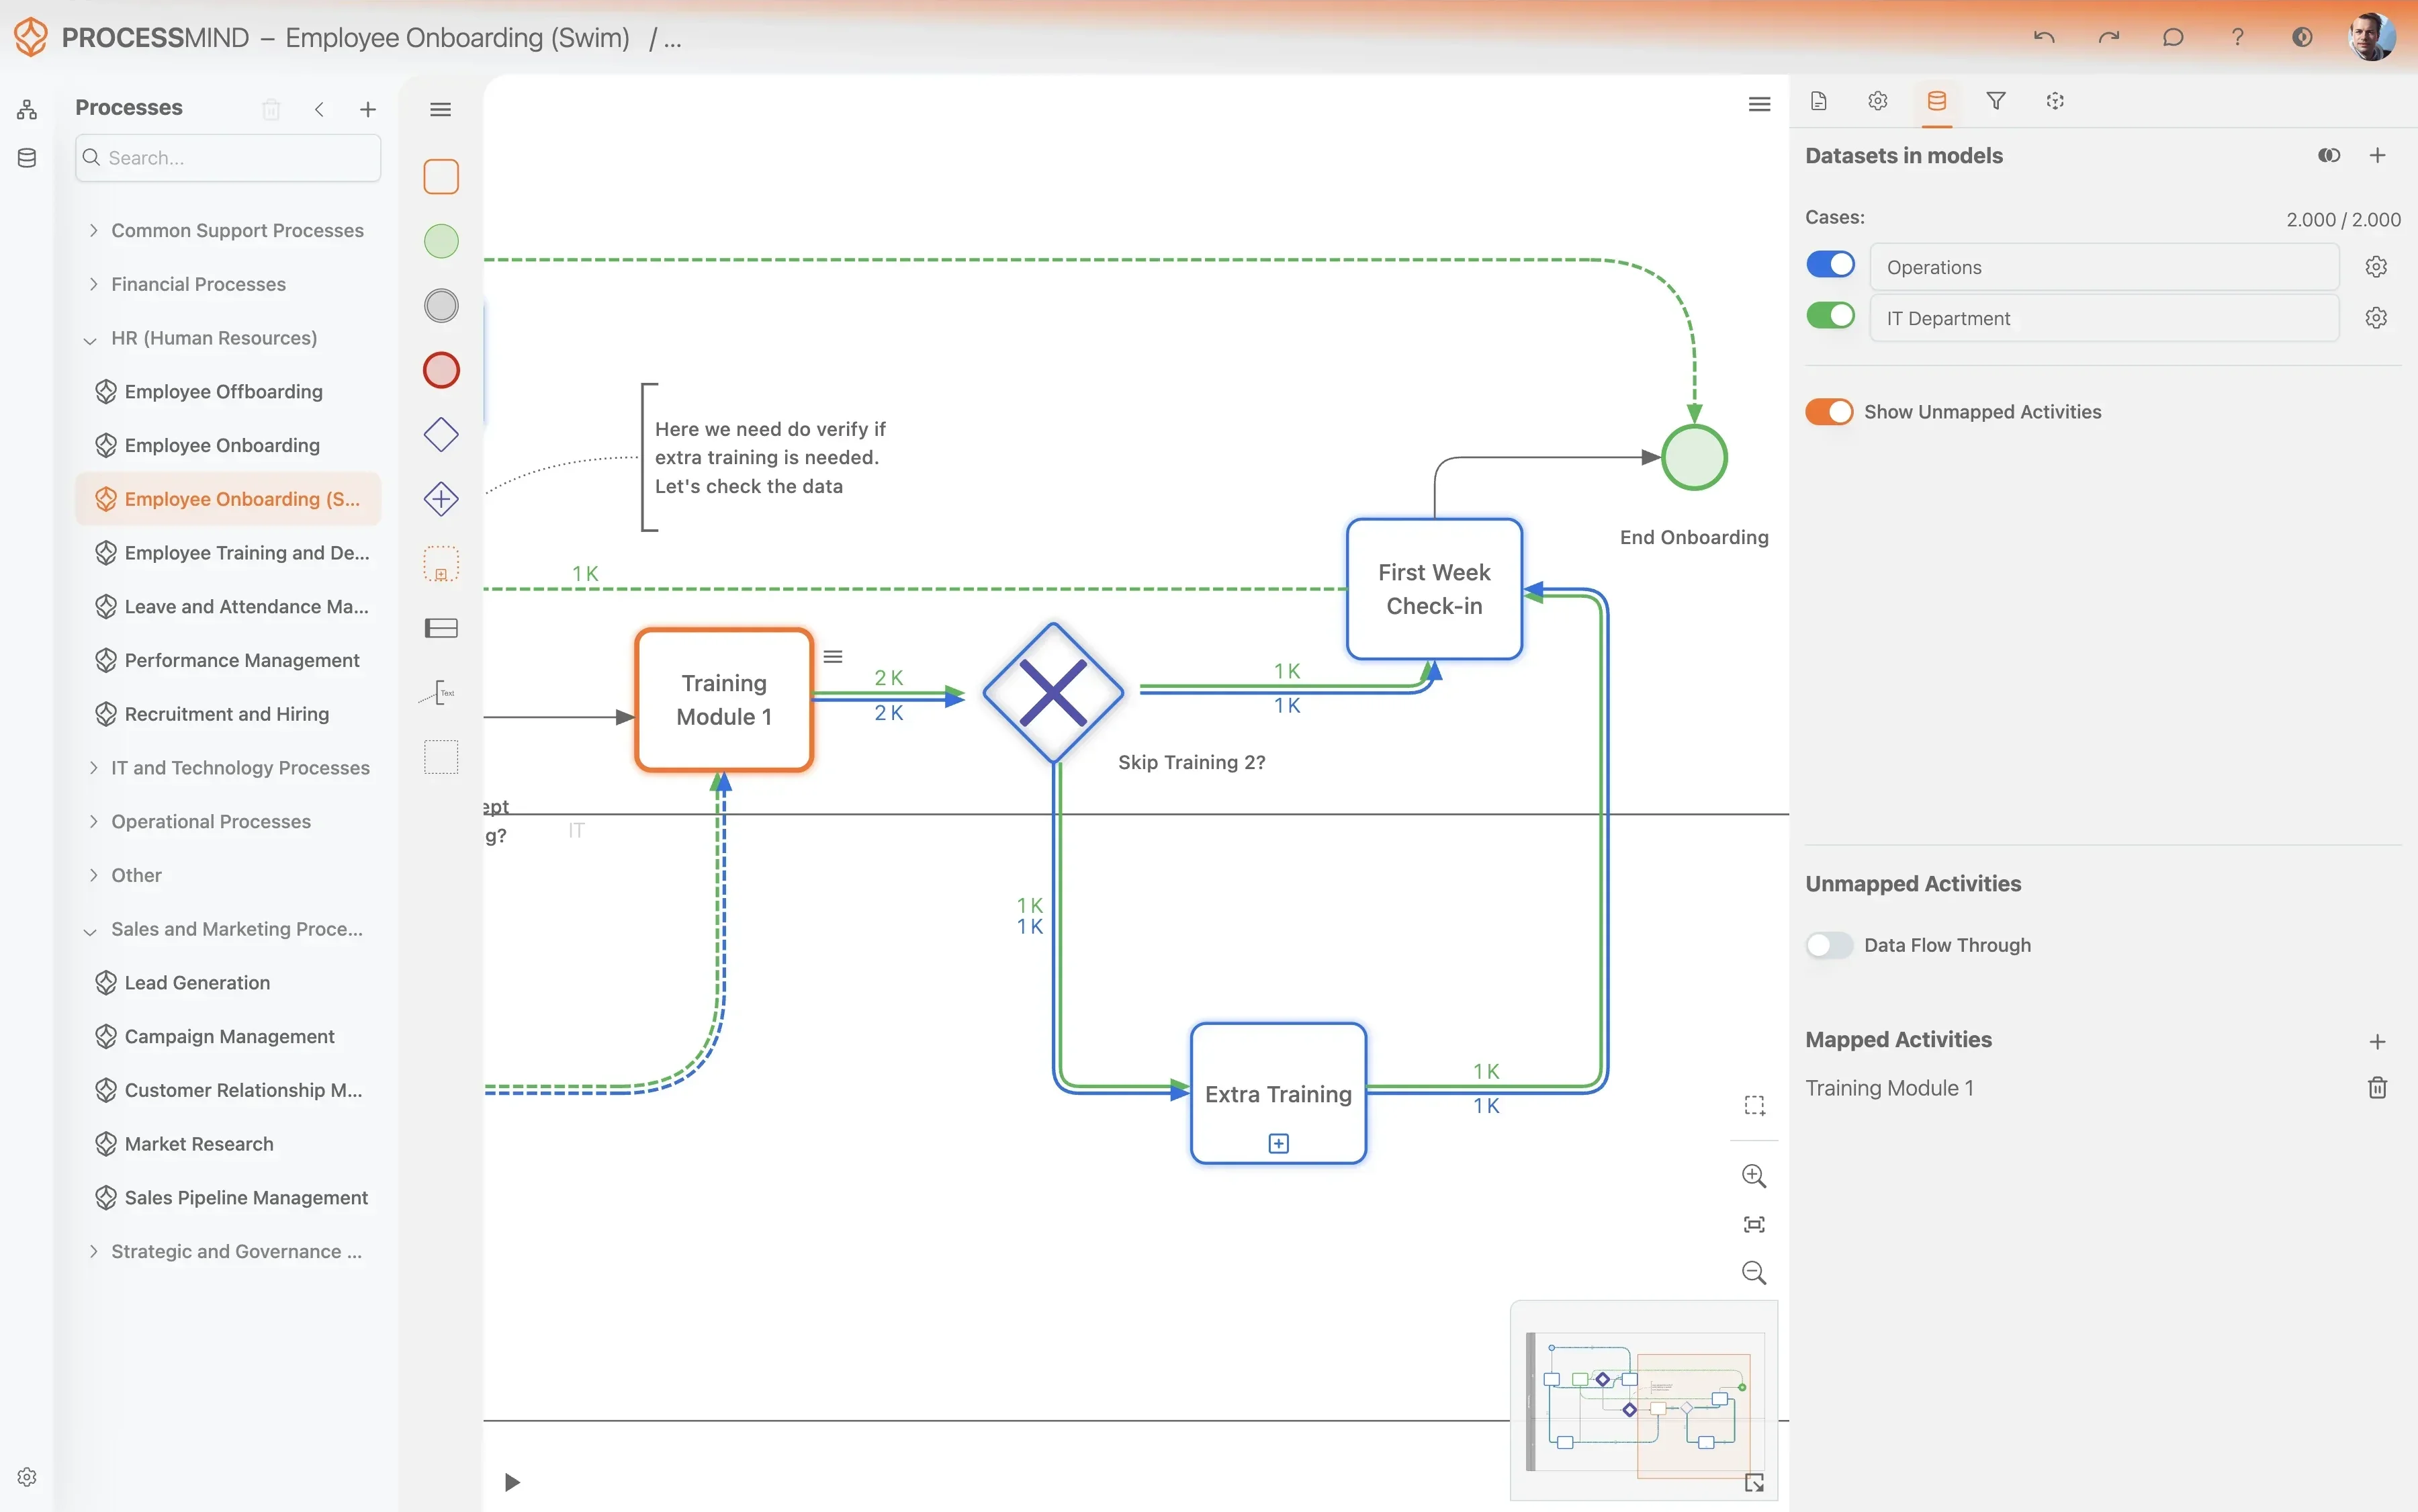
Ať zvolíte jakýkoli způsob, data načtěte tam, kde probíhá analýza. Soubor ve složce, kterou nikdo nesleduje, není datová strategie. Datová sada, kterou někdo namapuje a zkontroluje, ano.
Které nástroje ETL se hodí pro process mining?
Neexistuje jediný seznam nástrojů ETL vhodný pro každý projekt. Vybírejte podle toho, kde jsou data uložená, jaké nástroje váš tým už používá a kolik přípravy záznam vyžaduje. Jde o běžnou práci s daty. Jediným specifickým požadavkem process mining je zachovat ve výstupu ID případu, aktivitu a časové razítko.
| Přístup | Kdy ho použít | Nevýhoda |
|---|---|---|
| Ruční export a příprava | Ověřujete jeden proces na malé, stabilní datové sadě | Nejrychlejší začátek, ale každý další export vyžaduje ruční práci |
| Nástroje, které už váš tým používá | Už máte SQL, dbt, datový sklad nebo datové jezero | Využijete stávající znalosti a infrastrukturu a logiku můžete používat i mimo process mining |
| Nástroj ETL třetí strany | Export se musí opakovat z několika systémů | Je třeba nastavit a spravovat více součástí |
| Vestavěné ETL v platformě pro process mining | Platforma podporuje potřebné transformace | Je pohodlné, ale ověřte, zda lze logiku přenést a data znovu použít jinde |
V projektech process mining se často setkáte s těmito nástroji: CData a dbt pro získávání dat a transformace v SQL, BigQuery, Snowflake a Databricks pro datové sklady a Talend, Apache NiFi a Airbyte pro přesun dat mezi systémy. V úvahu přicházejí i nástroje s otevřeným zdrojovým kódem, obvykle NiFi a Airbyte. Někteří dodavatelé, například Evidant a Konekti, nabízejí ETL určené pro process mining včetně šablon pro běžné systémy.
Jde o příklady, nikoli doporučení, a s žádným z těchto dodavatelů nespolupracujeme. Upřednostněte nástroje a formáty, které váš tým dokáže spravovat i po skončení projektu. Pokud to jde, ponechte logiku transformací mimo produkt pro process mining. Pečlivě zvažte vestavěné ETL: jeho používání je pohodlné, dokud zůstáváte na dané platformě, ale připravená data se pak hůře využívají v dalších analytických projektech nebo projektech AI.
Jak spravovat data po jejich načtení?
Získání dat je jen polovina práce. O tom, zda bude analýza použitelná i za čtvrt roku, rozhoduje následná správa datových sad.
- Datové sady pojmenovávejte podle jejich obsahu. Název
Q1_2025_Sales_DataneboCustomer_Support_Logsje výstižnější nežexport_final_v3. - Vyberte formát podle účelu. Pro malé soubory nahrávané ručně stačí CSV nebo Excel. Parquet nebo ORC se vyplatí u velkých datových sad a výstupů z pipeline.
- Před mapováním si data prohlédněte. Zkontrolujte strukturu, typy sloupců a několik řádků. V nastavení datové sady ověřte ID případu, aktivitu a časové razítko.
- Zkontrolujte mapování aktivit. Nechte automatické mapování provést první průchod a pak projděte nenamapované aktivity. Kroky, které proběhnou, ale nezanechají v datech záznam, můžete označit jako průchod dat. Zůstanou viditelné, aniž by ovlivnily výpočty.
- Data aktualizujte, nevytvářejte znovu. U pravidelných exportů nahrazujte datovou sadu aktuálním souborem v potřebném intervalu, denně nebo týdně, a zachovejte stejné mapování.
- Zaznamenejte, co data nepokrývají. Chybějící období, systémy a kroky uveďte v poznámkách k analýze. Ovlivňují totiž závěry, které můžete vyvodit.
- Omezte přístup a pak data archivujte. Přístup k datové sadě dejte lidem, kteří ho potřebují. Datové sady, které už dokončený projekt nevyužívá, archivujte.
Shrnutí
ETL je prostředek, ne cíl projektu process mining. Nastavte ho tak, aby nezdržoval první analýzu:
- Začněte s daty, která můžete získat tento týden.
- Zachovejte tři povinná pole, ať už odstraníte cokoli dalšího.
- Nejprve načtěte export. Načítání automatizujte, až se ukáže, že to má smysl.
- Používejte nástroje a formáty, které váš tým už spravuje.
Více projektů ztroskotá na tom, že se pipeline vytvořila dřív, než někdo věděl, na jakou otázku má odpovědět, než na tom, že byla příliš jednoduchá.
Where to Go From Here
Máte export nebo pipeline, která ho dokáže vytvořit. Dalším krokem je data načíst a ověřit, zda export odpovídá na vaši otázku.