Process Mining performansı: Ölçüm sonuçları ve ipuçları
Veri hacmi, dosya biçimi ve sorgu yapısı Process Mining performansını nasıl etkiliyor? 100 bin ile 100 milyon olay arasındaki karşılaştırma sonuçlarını inceleyin.

Process Mining performansını yalnızca olay sayısı belirlemez. Dosya boyutu, vaka sayısı, sorgu yapısı ve ağ aktarım hızı da bekleme süresini etkiler. Aşağıdaki kıyaslamalar, 100 bin ile 100 milyon olay içeren veri setlerini kapsıyor. Testler, burada açıklanan dosya biçimleri ve koşullar kullanılarak Mart 2026’da AWS üretim altyapısında gerçekleştirildi.
Öne çıkan noktalar
- Büyük dosyalarda veya yavaş bağlantılarda bekleme süresinin büyük bölümünü yükleme alabilir.
- Parquet ve ORC dosyaları, ham CSV dosyalarından çok daha küçüktür; bu da aktarım süresini kısaltır.
- Dashboard yanıt süreleri sorguya bağlıdır. İstatistikler hızlı yüklenirken olay sayısı arttıkça süreç akışlarının yüklenmesi daha uzun sürer.
- Delta yükleme, tüm veri setini yeniden yüklemeniz gerekmeden yeni olayları aktarır.
- Kapsamı belirli bir veri setini yüklemek daha hızlı, analiz etmek daha kolay olabilir.
Process Mining performansını neler etkiler?
Performansı dört etken belirler: veri miktarı, Event Log yapısı, çalıştırılan sorgu ve veriyi aktarmak ve işlemek için kullanılan ortam.
- Olay ve vaka sayısı: Olay sayısı arttıkça genellikle yüklenecek ve işlenecek veri miktarı da artar. Vaka sayısı, analizinizin kaç süreç örneğini kapsadığını belirler.
- Sorgu yapısı: Özet istatistiklerle süreç akışını hesaplamak farklı işlemler gerektirir. Etkinlikler arasındaki geçişleri hesaplayan sorgular, önceden toplulaştırılmış veriler üzerinde çalışan sorgulardan daha uzun sürebilir.
- Etkinlik sayısı ve vaka uzunluğu: Birbirinden farklı etkinliklerin ve uzun vakaların sayısı arttıkça akışları ve varyantları hesaplamak için gereken işlem de artar.
- Dosya boyutu ve ağ hızı: Yükleme süresini bu ikisi belirler. Uzun metin alanları içeren geniş bir CSV dosyası, aynı olayları içeren sıkıştırılmış sütunlu bir dosyadan çok daha büyük olabilir.
Bir veri setinin ne kadar sürede işleneceğini yalnızca olay sayısına bakarak tahmin edemezsiniz. Karşılaştırma değerlerini başlangıç noktası olarak kullanın, ardından kullanmayı planladığınız Event Log ve sorgularla test yapın. Ortamınızda Process Mining performansını değerlendirmenin en yararlı yolu budur.
Veri hattında süre nereye gidiyor?
Veri seti üç aşamadan geçer: yükleme, ön işleme ve süreç modelini değiştirdiğinizde yeniden hesaplama.
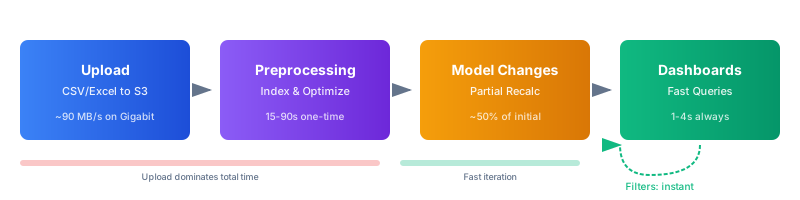
- Yükleme: Dosyanız internet üzerinden ProcessMind bulut altyapısına aktarılır. Aktarım süresini ağ hızı ve dosya boyutu belirler. Örneğin, 50 milyon olay içeren 11 GB’lık bir CSV dosyasının yüklenmesi 1 Gbps hızında yaklaşık 2 dakika, 100 Mbps hızında 18 dakika, 10 Mbps hızında ise 3 saatten fazla sürer. Aynı verileri içeren 1,7 GB’lık Parquet dosyası, bu hızlarda sırasıyla yaklaşık 19 saniyede, 3 dakikada veya 28 dakikada yüklenir.
- Ön işleme: Yüklemenin ardından sistem verileri optimize edilmiş sütunlu depolama biçimine dönüştürür, olayları dizinler, etkinlik geçişlerini ve süreç varyantlarını hesaplar, özet istatistikleri oluşturur. Aşağıdaki karşılaştırma testlerinde bu işlem 100 bin olay için 35 saniye, 100 milyon olay içinse 2,5 dakika sürüyor.
- Model değişiklikleri: Etkinlik eşlemelerini değiştirdiğinizde veya etkinlik ekleyip kaldırdığınızda ProcessMind, modele bağlı hesaplamaları günceller. Aşağıdaki karşılaştırma testlerinde bu işlem 1 milyon olay için yaklaşık 14 saniye, 100 milyon olay için 52 saniye sürüyor. Filtre değişiklikleri anında uygulanır.
Büyük veri setlerinde dosya boyutunu küçültmek, ilk bekleme süresini kısaltmanın çoğu zaman en etkili yoludur. Ön işlemenin ardından sorgu performansı, Dashboardınızın neyi hesaplaması gerektiğine bağlıdır.
Sorgu performansı neden değişir?
Farklı sorguların işlem maliyetleri de farklıdır. Aşağıdaki özellikler, ne beklemeniz gerektiğini ve verilerinizi nasıl düzenleyebileceğinizi anlamanıza yardımcı olur.
- Etkinlik sayısı: 10-20 farklı etkinlik içeren modelleri analiz etmek ve görüntülemek daha kolaydır. Etkinlik sayısı 50’yi aştığında süreç akışlarının hesaplanması uzayabilir ve akışları okumak zorlaşabilir. Süreci doğru yansıtıyorsa birbiriyle ilişkili adımları gruplayın.
- Varyant çeşitliliği: Vakaların çoğunun az sayıda yolu izlediği süreçleri analiz etmek, her vakanın farklı bir yol izlediği süreçleri analiz etmekten genellikle daha hızlıdır. Yüksek çeşitlilik anlamlı olabilir, ancak sorgu süresini uzatabilir.
- Sütun sayısı: Süreç analizi için temel alanlar olan CaseId, Activity ve Timestamp gereklidir. Ek öznitelikler filtreleme ve kategorilere ayırma olanağı sunar, ancak aktarılacak ve taranacak veri miktarını artırır.
- Vaka uzunluğu: 50 olay içeren bir vakayı işlemek, 5 olay içeren bir vakadan daha fazla işlem gerektirir. Yüzlerce olay içeren vakalar için sorguların tamamlanması daha uzun sürebilir.
Dashboard yanıt süreleri
Bu medyan değerler, birden fazla karşılaştırma testinden elde edilmiştir. Her Dashboard bileşeni kendi sorgusunu çalıştırır ve paralel olarak yüklenir.
| Veri Seti | İstatistikler | Süreç akışı | Varyantlar | Kategoriler | Veri tarayıcısı | Animasyon |
|---|---|---|---|---|---|---|
| 100 bin | 0,6 sn | 1,5 sn | 1,1 sn | 1,5 sn | 1,2 sn | 1,4 sn |
| 1 milyon | 0,6 sn | 1,6 sn | 1,4 sn | 1,9 sn | 1,5 sn | 2,0 sn |
| 5 milyon | 0,6 sn | 2,5 sn | 1,8 sn | 2,4 sn | 1,3 sn | 2,1 sn |
| 10 milyon | 0,6 sn | 3,4 sn | 2,2 sn | 2,5 sn | 1,6 sn | 2,4 sn |
| 20 milyon | 0,6 sn | 3,9 sn | 2,7 sn | 3,3 sn | 1,9 sn | 3,6 sn |
| 50 milyon | 0,6 sn | 5,1 sn | 4,2 sn | 5,7 sn | 1,6 sn | 2,7 sn |
| 100 milyon | 0,6 sn | 7,2 sn | 3,5 sn | 4,7 sn | 1,6 sn | 5,0 sn |
Test edilen veri boyutlarının tümünde istatistikler yaklaşık 0,6 saniyede yüklendi. Etkinlikler arasındaki geçişleri hesapladığı için olay sayısı arttıkça Süreç akışının yüklenmesi uzadı. Varyantlar ve Kategoriler orta düzeyde yavaşlarken sayfalama sayesinde Veri tarayıcısı hızlı yanıt vermeyi sürdürdü. Animasyon süresi, görüntülenen etkin vakaların sayısına göre değişti.
1-10 milyon olay içeren veri setlerinde, bileşene bağlı olarak ölçülen yanıt süreleri 0,6-3,4 saniye arasında değişti. 50 milyon olayda Süreç akışı ve Kategoriler yaklaşık 5-6 saniyede yüklendi. Bunlar karşılaştırma testlerinin sonuçlarıdır; her veri seti veya ortam için aynı sonuçları garanti etmez.
Karşılaştırma testi verileri: test koşulları nelerdi?
Bu karşılaştırma testleri Mart 2026’da AWS üretim altyapısında gerçekleştirildi. Yükleme ve ön işleme süreleri birden fazla testin ortalamasıdır. Dashboard yanıt süreleri ise birden fazla testin medyan değerleridir. Testlerde, her veri seti boyutu için 50’den fazla sorgu türü incelendi.
Aşağıdaki olay sayıları, test dosyalarındaki gerçek sayılardır. Dosya boyutları, standart bir Event Log şeması (CaseId, Activity, Timestamp ve 5-8 iş özniteliği) kullanan sıkıştırılmamış CSV dosyaları için verilmiştir. Dosya boyutunuz ve sonuçlarınız; sütun sayısına, içeriğe, ağ koşullarına, veri merkezine uzaklığınıza ve mevcut yüke göre değişir.
Yükleme ve ön işleme süreleri
| Veri Seti | Gerçek olay sayısı | Dosya boyutu | Yükleme (1 Gbps) | Yükleme (100 Mbps) | Yükleme (50 Mbps) | Yükleme (10 Mbps) | Ön işleme |
|---|---|---|---|---|---|---|---|
| 100 bin | 125.260 | 22 MB | < 1 sn | 2 sn | 4 sn | 22 sn | 35 sn |
| 500 bin | 626.300 | 110 MB | 1 sn | 11 sn | 22 sn | 2 dk | 45 sn |
| 1 milyon | 1.253.424 | 221 MB | 3 sn | 22 sn | 44 sn | 4 dk | 55 sn |
| 2 milyon | 2.506.848 | 443 MB | 5 sn | 44 sn | 1,5 dk | 7 dk | 1 dk |
| 5 milyon | 4.996.877 | 1,1 GB | 13 sn | 2 dk | 4 dk | 18 dk | 1,5 dk |
| 10 milyon | 12.511.867 | 2,2 GB | 25 sn | 4 dk | 7 dk | 37 dk | 1,5 dk |
| 20 milyon | 25.023.734 | 4,4 GB | 50 sn | 7 dk | 15 dk | 1,2 sa | 2 dk |
| 50 milyon | 62.559.335 | 11,1 GB | 2 dk | 18 dk | 37 dk | 3 sa | 2 dk |
| 100 milyon | 125.118.670 | 22,3 GB | 4 dk | 37 dk | 1,2 sa | 6 sa | 2,5 dk |
Ölçülen 1 Gbps aktarım hızı, AWS eu-central-1’e 88 MB/sn idi. Diğer hızlar, pratik aktarım hızları kullanılarak tahmin edildi: 50 Mbps için yaklaşık 5 MB/sn, 100 Mbps için 10 MB/sn ve 10 Mbps için 1 MB/sn. Gerçek aktarım hızı ağınıza ve koşullara bağlıdır.
Bu testte ön işleme 35 saniye ile 2,5 dakika arasında sürdü. Dosya boyutu arttıkça yükleme süresi de uzadı ve büyük dosyalarda toplam bekleme süresinin en büyük bölümünü oluşturdu.
Dosya biçimleri: Parquet ve ORC ile CSV karşılaştırması
ProcessMind; CSV, Parquet, ORC, Excel ve XES biçimlerini destekler. Bu dosya boyutu karşılaştırmasında, yukarıdaki testte kullanılan olay sayıları ve şema aynıdır.
| Veri Seti | CSV | Parquet | ORC | CSV.GZ |
|---|---|---|---|---|
| 1 milyon olay | 221 MB | 34 MB | 39 MB | 20 MB |
| 5 milyon olay | 1,1 GB | 151 MB | 197 MB | 107 MB |
| 10 milyon olay | 2,2 GB | 301 MB | 395 MB | 215 MB |
| 20 milyon olay | 4,4 GB | 603 MB | 791 MB | 430 MB |
| 50 milyon olay | 11,1 GB | 1,7 GB | 1,9 GB | 1,1 GB |
| 100 milyon olay | 22,3 GB | 3,4 GB | 3,7 GB | 2,2 GB |
Bu testlerde Parquet dosyaları CSV dosyalarından yaklaşık %85, ORC dosyaları ise yaklaşık %82 daha küçüktü. Her ikisi de yerleşik sıkıştırma özelliğine sahip sütunlu biçimlerdir. Spark, Databricks, dbt ve BigQuery gibi veri araçları bu biçimlere dışa aktarımı destekleyebilir.
Parquet, ORC ve CSV dosyalarının ön işleme süreleri birbirine yakındı. Olay sayısı yüksek olduğunda CSV.GZ dosyalarının işlenmesi daha uzun sürdü, çünkü gzip dosyaları paralel açma işlemi için parçalara ayrılamaz.
| Veri Seti | Parquet | ORC | CSV | CSV.GZ |
|---|---|---|---|---|
| 1 milyon olay | 55 sn | 55 sn | 55 sn | 55 sn |
| 5 milyon olay | 1,5 dk | 1,5 dk | 1,5 dk | 1,5 dk |
| 10 milyon olay | 1,5 dk | 1,5 dk | 1,5 dk | 2 dk |
| 20 milyon olay | 2 dk | 2 dk | 2 dk | 2,5 dk |
| 50 milyon olay | 2 dk | 2 dk | 2 dk | 3 dk |
| 100 milyon olay | 2,5 dk | 2,5 dk | 2,5 dk | 4,5 dk |
Toplam süre, yükleme ve ön işleme sürelerinin toplamıdır. Bu örneklerde 100 Mbps bağlantı kullanılmıştır.
| 10 milyon olay (100 Mbps) | Dosya boyutu | Yükleme | Ön işleme | Toplam |
|---|---|---|---|---|
| Parquet | 301 MB | 30 sn | 1,5 dk | ~2 dk |
| ORC | 395 MB | 40 sn | 1,5 dk | ~2,2 dk |
| CSV | 2,2 GB | 4 dk | 1,5 dk | ~5,5 dk |
| CSV.GZ | 215 MB | 21 sn | 2 dk | ~2,5 dk |
| 50 milyon olay (100 Mbps) | Dosya boyutu | Yükleme | Ön işleme | Toplam |
|---|---|---|---|---|
| Parquet | 1,7 GB | 3 dk | 2 dk | ~5 dk |
| ORC | 1,9 GB | 3,2 dk | 2 dk | ~5,2 dk |
| CSV | 11,1 GB | 18 dk | 2 dk | ~20 dk |
| CSV.GZ | 1,1 GB | 2 dk | 3 dk | ~5 dk |
Büyük veri setlerinde Parquet ve ORC dosyaları daha küçük olduğu için aktarım süresini kısaltır. Daha küçük veri setlerinde veya dışa aktarma süreciniz sütunlu biçimleri desteklemiyorsa CSV kullanmak kolay bir seçenektir. CSV.GZ, yavaş bağlantılarda aktarım süresini kısaltabilir; ancak veri seti büyüdükçe dosyayı açmak için gereken işlem de artar.
Dosya biçimi seçimi
- Parquet: Veri hattınız destekliyorsa büyük veri setleri için iyi bir varsayılan seçenektir. Bu testlerde en küçük dosyaları Parquet oluşturdu.
- ORC: Özellikle veri hattınız Hadoop veya Spark kullanıyorsa benzer bir seçenektir.
- CSV: Kullanımı kolaydır ve yaygın olarak desteklenir. Küçük veri setlerinde pratik bir seçenek olabilir.
- CSV.GZ: Yükleme hızı en önemli kısıtlamaysa bu biçimi değerlendirin. Özellikle olay sayısı yüksek olduğunda, kendi verilerinizle ön işleme süresini test edin.
Hangi sorgu örüntüleri analizi yavaşlatabilir?
Bazı veri ve Dashboard düzenleri diğerlerinden daha fazla işlem gerektirir. Sorguların yavaşlamasına yol açabilecek etkenleri belirlemek için bu noktaları kontrol edin.
- Çok fazla etkinlik: 50’den fazla farklı etkinlik içeren bir süreç akışının hesaplanması daha uzun sürebilir ve akışı yorumlamak zorlaşabilir. Uygun olduğunda birbiriyle ilişkili adımları gruplayın.
- Çok sayıda farklı varyant: Vakalar birçok farklı yolu izlediğinde varyant hesaplamaları daha fazla işlem gerektirir. Yüksek çeşitlilik, incelenmeye değer süreç davranışlarına da işaret edebilir.
- Uzun vakalar: Çok sayıda olay içeren vakaların işlenmesi, kısa vakalardan daha fazla zaman alır.
- Gereksiz sütunlar: Ek öznitelikler dosya boyutunu artırır ve sorgulandıklarında ek işlem gerektirebilir. Analizinizi destekleyen alanları tutun.
- Büyük ve kalabalık Dashboardlar: Her grafik veya kutucuk kendi sorgusunu çalıştırır. Net bir soruyu yanıtlayan bileşenleri tutun, diğer görünümleri ayrı bir Dashboarda ekleyin.
- İşlem maliyeti yüksek görselleştirmeler: Büyük veri setlerinde çok sayıda kategori içeren grafiklerin oluşturulması daha uzun sürebilir. Ayrıntılı bir döküme ihtiyaç duymadığınızda özet görünümü kullanın.
- Çok sayıda etkin vaka içeren animasyonlar: Animasyon süresi, görüntülenen vaka sayısına bağlıdır. Yalnızca akışı incelemeniz gerekiyorsa hızı düşürün veya izleri ve efektleri kapatın.
Doğru veri boyutunu nasıl seçebilirsiniz?
Sorunuzu yanıtlayabilecek en küçük veri setiyle başlayın. Belirli bir konuya odaklanan veri setini yüklemek daha hızlı, doğrulamak daha kolaydır. Daha geniş kapsam, nadir olaylar veya uzun vadeli eğilimler için veri setini büyütün.
Daha küçük bir veri setiyle oluşturun ve doğrulayın
Yakın tarihli bir örnekle başlayın, modelinizi yapılandırın ve veri miktarını artırmadan önce verileri kontrol edin.
- Bir örnekle başlayın. Örneğin, son üç aylık dönemden 1 milyon olay çıkarın. Karşılaştırma testinde yükleme, 1 Gbps hızında 3 saniye veya 100 Mbps hızında 22 saniye sürdü; ardından 55 saniyelik ön işleme yapıldı.
- Modelinizi oluşturun. Etkinlikleri, filtreleri ve görünümleri yapılandırın. Test edilen 1-10 milyon olay içeren veri setlerinde model değişiklikleri yaklaşık 14-20 saniye sürdü.
- Bulguları doğrulayın. Etkinlik adlarının ve süreç yollarının anlamlı olup olmadığını kontrol edin, veri kalitesi sorunlarını giderin.
- Gerekirse daha fazla veri ekleyin. Nadir vakaları incelemeniz veya daha uzun dönemleri karşılaştırmanız gerektiğinde olay sayısını artırın.
Tablo, 100 Mbps bağlantıda farklı olay sayıları için ilk bekleme süresini karşılaştırıyor.
| Yaklaşım | Yükleme (100 Mbps) | Ön işleme | Toplam bekleme | Dashboard hızı |
|---|---|---|---|---|
| 1 milyon olayla başlayın | 22 sn | 55 sn | ~1,5 dk | 1-2 sn |
| 5 milyon olayla başlayın | 2 dk | 1,5 dk | ~3,5 dk | 1-2,5 sn |
| 50 milyon olayla başlayın | 18 dk | 2 dk | ~20 dk | 1-6 sn |
Uygun olay sayısı, yanıtlamaya çalıştığınız soruya bağlıdır. Yaygın süreç örüntülerini incelemek için küçük bir veri seti yeterli olabilir. Nadir olayları incelemek veya tüm vakaları kapsama gereksinimini karşılamak için daha fazla veriye ihtiyaç duyabilirsiniz.
Sorunuz belirliyse verileri bölümlere ayırın
Tek bir ülkeyi, departmanı veya ürün grubunu inceliyorsanız, birbiriyle ilgisiz grupları bir araya getirmek yerine önce o bölümle başlayın. Verileri bölümlere ayırmak karşılaştırmaları netleştirebilir ve işlenmesi gereken veri miktarını azaltabilir.
Örneğin, karşılaştırma testi 8 ülkeden 42 milyon sevkiyat olayı içeren bir Avrupa lojistik veri setini ele alıyor:
- Tüm ülkeler: 42 milyon olay, 9,3 GB; 100 Mbps hızında yükleme 16 dakika, ön işleme 2 dakika sürüyor.
- Almanya: 8,5 milyon olay, 1,9 GB; yükleme 3 dakika, ön işleme 1,5 dakika sürüyor.
- Hollanda: 3,1 milyon olay, 690 MB; yükleme 1 dakika, ön işleme 1 dakika sürüyor.
Her bölümü doğruladıktan sonra bölümleri karşılaştırabilirsiniz. Coğrafya, kuruluş, ürün, dönem ve müşteri segmenti karşılaştırma için kullanılabilecek boyutlardır.
İhtiyacınız olan vakaları filtreleyin
İstisnaları inceliyorsanız yalnızca ilgili vakaları dışa aktarmak veri setini önemli ölçüde küçültebilir. Örneğin, karşılaştırma testi 1,2 milyon satın alma siparişi ve 8,4 milyon olay içeren bir Satın Almadan Ödemeye sürecini ele alıyor. Testte, ret, iade, yinelenen fatura veya eksik onay gibi istisnaların 96.000 siparişte, yani siparişlerin %8’inde görüldüğü belirtiliyor.
Bu analiz için yalnızca istisna içeren vakaları dışa aktarmak, veri setini 8,4 milyon olaydan 670 bin olaya düşürüyor. Bildirilen dosya boyutu 1,9 GB’tan 150 MB’a, 100 Mbps hızındaki yükleme süresi ise 3 dakikadan 15 saniyeye iniyor. Aynı verileri 15 MB’lık Parquet dosyası olarak dışa aktarmak, karşılaştırma testinde 2 saniyeden kısa sürüyor.
İncelediğiniz soruyla ilgili alanları kullanarak duruma, etkinliğe, vaka süresine, döneme veya iş birimine göre filtreleyin.
Yalnızca ihtiyacınız olan sütunları seçin
Her sütun dosya boyutunu artırır. Uzun metin alanları, yinelenen tanımlayıcılar, denetim alanları ve teknik üst veriler analiziniz için gerekli olmayabilir.
Karşılaştırma testi, 45 sütun içeren 1,8 milyon satın alma siparişi olayının SAP dışa aktarımını ele alıyor. Veriyi 12 temel sütuna indirmek dosya boyutunu 2,1 GB’tan 380 MB’a düşürdü. Bu sütunları Parquet olarak dışa aktarmak boyutu 58 MB’a kadar indirdi. Bildirilen 100 Mbps yükleme süresi 3,5 dakikadan 6 saniyeye düştü.
Analizinizi destekleyen CaseId, Activity ve Timestamp alanlarıyla durum, tutar, kategori veya bölge gibi ilgili iş özniteliklerini tutun. Analiz için gerekli değilse kişisel bilgileri kaldırın.
Daha büyük bir veri setini ne zaman kullanmalısınız?
Sorunuzun yanıtı kapsam veya zaman aralığına bağlıysa daha fazla olay içeren bir veri seti gerekebilir.
- Nadir olaylar: 100.000 vakada bir görülen istisnaları bulmak için bu istisnaları içerecek kadar büyük bir veri kümesi gerekir. Bir istisna vakaların %0,01’inde görülüyorsa ve 50 örneğini incelemek istiyorsanız yaklaşık 500 bin vakaya ihtiyacınız olur.
- Düşük sıklıktaki varyantlar: Vakaların %0,1’inde görülen varyantlar, 1 milyon olaylık bir örneklemde fark edilmeyebilir; 50 milyon olaylık bir veri kümesinde ise net biçimde ölçülebilir.
- Uyumluluk ve denetim: Bazı gereksinimler örneklem yerine tüm veri kümesinin kapsanmasını gerektirir.
- Uzun vadeli eğilimler: 2024’ün ilk çeyreğini 2025 ve 2026’nın ilk çeyrekleriyle karşılaştırmak için üç dönemin de verileri gerekir. Delta loading ile bu kapsamı aşamalı olarak oluşturabilirsiniz.
50 milyondan fazla olay içeren veri setlerinde karşılaştırma testi, Parquet kullanmanızı, API üzerinden yükleme yapmanızı ve mümkünse hızlı bir ağ bağlantısından yararlanmanızı öneriyor. Testteki 50 milyon olaylık CSV dosyası 11,1 GB, Parquet dosyası ise 1,7 GB’tı.
Performans her zaman bir ödünleşim içerir: daha fazla veri ve daha yüksek hız daha fazla maliyet getirir. Asıl soru, bir aracın neler yapabildiği değil, sürecinizin neye ihtiyaç duyduğudur. ProcessMind çok büyük veri setlerini işleyebilir; yine de çoğu zaman gereksiz olan ve iyileştirme çalışmalarının odağını dağıtacak kadar karmaşıklık yaratan veri setlerini kullanmamanızı öneriyoruz.
Modelin ve arayüzün hızlı yanıt vermesini nasıl sağlayabilirsiniz?
Önemli olan yalnızca veri miktarı değildir. Süreç modelinin ve Dashboard tasarımının da çalışma hızınıza etkisi vardır.
- Modeli okunaklı tutun: Büyük süreçleri modüler Subprocess bileşenlerine ayırın. Çok sayıda görünür öğe içeren bir tuvalin oluşturulması daha uzun sürebilir ve tuvalde gezinmek zorlaşabilir. Yapısal değişikliklerden sonra otomatik düzeni kullanın.
- Dashboard bileşenlerini dikkatle seçin: Her grafik ve kutucuk bir hesaplama gerektirir. Mevcut sorularınızı yanıtlayan görünümleri tutun.
- Veriye uygun grafikler kullanın: Büyük veri setlerinde çok sayıda kategori içeren görselleştirmelerin hesaplanması daha uzun sürebilir. Ayrıntılı bir döküme ihtiyaç duymadığınızda özet görünümü kullanın.
- Filtreleri sorunuzla sınırlı tutun: Filtreler analizi daraltmaya yardımcı olabilir. Yanıtlamaya çalıştığınız soruyla ilgisi olmayan filtreleri bir arada kullanmayın.
- Animasyon ayarlarını düzenleyin: Etkin vaka sayısı arttıkça animasyonun işlem maliyeti de artar. Yalnızca akışı incelemeniz gerekiyorsa hızı düşürün veya izleri ve efektleri kapatın. Daha fazla bilgi için Süreç animasyonu sayfasına bakın.
- Yalnızca değişen verileri yeniden hesaplayın: Model değişiklikleri, tüm ön işleme adımını tekrarlamadan modele bağlı hesaplamaları günceller. Karşılaştırma testinde değişikliklerin uygulanması 1 milyon olay için yaklaşık 14 saniye, 100 milyon olay için 52 saniye sürdü.
Delta loading yükleme süresini nasıl kısaltır?
Delta loading, tüm veri setini yeniden yüklemek yerine mevcut veri setine yeni olaylar eklemenizi sağlar. Büyüyen bir Event Logu yenilerken aktarılan veri miktarını azaltır.
| Senaryo | Tüm veriyi yeniden yükleme | Delta yükleme | Kazanılan süre |
|---|---|---|---|
| 10 milyon temel veri + 500 bin yeni olay (100 Mbps) | 4 dk yükleme | 5 sn yükleme | ~4 dk |
| 20 milyon temel veri + 2 milyon yeni olay (100 Mbps) | 7 dk yükleme | 44 sn yükleme | ~6 dk |
| 50 milyon temel veri + 5 milyon yeni olay (100 Mbps) | 18 dk yükleme | 2 dk yükleme | ~16 dk |
Delta yüklemesinden sonra birleştirilmiş veri seti yeniden ön işlemden geçer. Karşılaştırma testinde bu işlem 1-2,5 dakika sürdü. Yükleme süresindeki kazanç, yalnızca yeni olayların aktarılmasından kaynaklanır.
Delta dosyası, ilk yüklemede kullanılan dosya biçimini ve sütun yapısını korumalıdır. Ayrıntılar için artımlı veri yükleme rehberine bakın.
API üzerinden yüklemeyi ne zaman tercih etmelisiniz?
Düzenli yüklemelerde veya birkaç gigabayt boyutundaki dosyalarda API üzerinden yükleme, tarayıcıyla aktarıma göre daha kolay yönetilebilir. Bir betik veya komut satırı aracı ETL hattınıza eklenebilir, zamanlanmış yüklemeleri destekleyebilir ve aktarımın ilerleyişini gösterebilir.
ProcessMind, bulut depolama alanına doğrudan yükleme için önceden imzalanmış URL’ler sağlar. Yükleme URL’sini ProcessMind arayüzündeki veri seti ayarları menüsünden kopyalayabilirsiniz.
# Upload a Parquet file directly using a presigned URL
curl -X PUT "$PRESIGNED_URL" --upload-file data.parquet
Önceden imzalanmış URL’leri alma ve delta dosyalarını yükleme adımları da dahil olmak üzere Bash, JavaScript ve Python örnekleri için API belgelerine bakın.
Veri setini ne zaman bölmelisiniz?
Belirli bir analiz için verilerin yalnızca bir bölümü gerekiyorsa veya ayrı grupları birbirinden bağımsız karşılaştırmanız gerekiyorsa veri setini bölün. Coğrafya, departman, ürün grubu, dönem veya vaka türüne göre bölümlere ayırabilir, ardından her veri setini ayrı ayrı analiz edebilirsiniz.
Sorunuz grupları karşılaştırmaya veya sürecin tamamını gruplar arasında izlemeye dayanıyorsa verileri bir arada tutun. Bölmeden önce, bu işlemin vakanın anlamını değiştirip değiştirmediğini veya vaka yolunu anlamak için gereken olayları çıkarıp çıkarmadığını kontrol edin. Örneğin, dönemlere göre bölerken bir dönemde başlayıp diğerinde tamamlanan vakaları hesaba katın.
Performansı kendi verilerinizle test edin
Karşılaştırma testleri planlama yapmanıza yardımcı olur, ancak her Event Log, ağ veya sorgu için sonuçları önceden gösteremez. Kullanmayı düşündüğünüz veri setini test edin, ardından yükleme ve ön işleme süreleriyle sizin için önemli Dashboard görünümlerinin yanıt sürelerini kontrol edin.
Event Logunuzu düzenlemek için yardıma ihtiyacınız varsa önce veri hazırlama yönergelerini okuyun. Ayrıca sürecinizi nasıl analiz edeceğinizi ve sürecinizi nasıl sürekli izleyeceğinizi inceleyebilirsiniz.
Kendi veri hacminizle test edin
Analiz etmeyi planladığınız Event Log verilerini yükleyin ve kendi verilerinizdeki performansı ölçün.