Process mining teljesítménye: mérések és gyakorlati tanácsok
Nézze meg, hogyan befolyásolja a process mining teljesítményét az adatmennyiség, a fájlformátum és a lekérdezés jellege. A 100 ezer és 100 millió esemény közötti, dátummal ellátott mérésekből ismerheti meg az eredményeket.

A process mining teljesítménye nem csak az események számától függ. A fájlméret, az esetek száma, a lekérdezés jellege és a hálózati átviteli sebesség egyaránt befolyásolja a várakozási időt. Az alábbi mérések 100 ezer és 100 millió esemény közötti adathalmazokra vonatkoznak. A teszteket éles AWS-infrastruktúrán végeztük 2026 márciusában, az itt ismertetett fájlformátumokkal és tesztkörülmények között.
Főbb tanulságok
- Nagy fájloknál vagy lassú kapcsolat esetén a feltöltés jelentheti a várakozás legnagyobb részét.
- A Parquet- és ORC-fájlok jóval kisebbek a nyers CSV-nél, így rövidebb az átviteli idő.
- A dashboard válaszideje a lekérdezéstől függ. A statisztikák gyorsan megjelennek, a folyamatábrák elkészítése viszont több időt vesz igénybe, ahogy nő az események száma.
- A delta betöltés az új eseményeket továbbítja, így nem kell ismét feltöltenie a teljes adathalmazt.
- A célzott adathalmaz gyorsabban feltölthető és könnyebben elemezhető.
Mi befolyásolja a process mining teljesítményét?
Négy tényező határozza meg a teljesítményt: az adatmennyiség, az eseménynapló felépítése, a futtatott lekérdezés, valamint az adatátvitelhez és -feldolgozáshoz használt környezet.
- Események és esetek száma: Több esemény általában több feltöltendő és feldolgozandó adatot jelent. Az esetek száma határozza meg, hány folyamatpéldányt fed le az elemzés.
- A lekérdezés jellege: Egy összesítő statisztika és egy folyamatábra eltérő számításokat igényel. A tevékenységek közötti átmeneteket kiszámító lekérdezések tovább tarthatnak, mint az előre összesített adatokra épülők.
- Tevékenységek száma és az esetek hossza: A több különböző tevékenység és a hosszabb esetek növelik az útvonalak és változatok kiszámításához szükséges munkát.
- Fájlméret és hálózati sebesség: Ezek határozzák meg a feltöltés idejét. A hosszú szöveges mezőket tartalmazó, széles CSV-fájl jóval nagyobb lehet, mint az ugyanazokat az eseményeket tartalmazó, tömör oszlopalapú fájl.
Az események száma önmagában nem jelzi előre, mennyi ideig tart az adathalmaz feldolgozása. Használja a mérési eredményeket viszonyítási alapként, majd tesztelje a használni kívánt eseménynaplót és lekérdezéseket. A saját környezetében így kaphatja a leghasznosabb képet a process mining teljesítményéről.
Adatfolyamat: mire megy el az idő?
Az adathalmaz három szakaszon megy keresztül: feltöltésen, előfeldolgozáson, majd a folyamatmodell módosításakor újraszámításon.
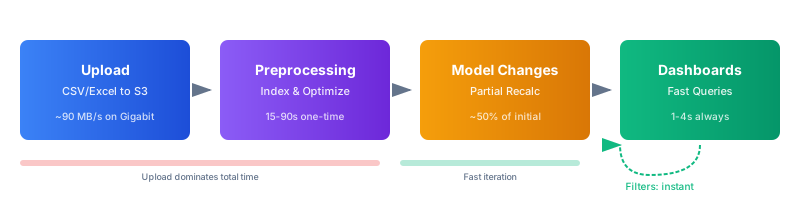
- Feltöltés: A fájl az interneten keresztül jut el a ProcessMind felhőinfrastruktúrájába. Az átviteli időt a hálózati sebesség és a fájlméret határozza meg. Például egy 50 millió eseményt tartalmazó, 11 GB-os CSV-fájl feltöltése 1 Gbps sebességgel körülbelül 2 perc, 100 Mbps sebességgel 18 perc, 10 Mbps sebességgel pedig több mint 3 óra. Ugyanez az adat egy 1,7 GB-os Parquet-fájlban ezeken a sebességeken körülbelül 19 másodperc, 3 perc, illetve 28 perc alatt tölthető fel.
- Előfeldolgozás: A feltöltés után a rendszer optimalizált oszlopalapú tárolási formátumba alakítja az adatokat, indexeli az eseményeket, kiszámítja a tevékenységek közötti átmeneteket és a folyamatváltozatokat, majd összesítő statisztikákat készít. Az alábbi mérésekben ez 100 ezer eseménynél 35 másodpercig, 100 millió eseménynél pedig legfeljebb 2,5 percig tartott.
- Modellmódosítások: Ha módosítja a tevékenységek hozzárendelését, vagy tevékenységeket ad hozzá, illetve távolít el, a ProcessMind frissíti a modelltől függő számításokat. Az alábbi mérésekben ez 1 millió eseménynél körülbelül 14 másodpercig, 100 millió eseménynél pedig 52 másodpercig tartott. A szűrők módosítása azonnali.
Nagy adathalmazoknál a fájlméret csökkentése gyakran a leghatékonyabb módja annak, hogy kevesebbet kelljen várnia az első betöltésre. Az előfeldolgozás után a lekérdezések sebessége attól függ, mit kell kiszámítania a dashboardnak.
Hogyan változik a lekérdezések teljesítménye?
A különböző lekérdezések eltérő számítási igényűek. Az alábbi szempontok segítenek felmérni, mire számíthat, és hogyan érdemes összeállítania az adatokat.
- Tevékenységek száma: A 10–20 különböző tevékenységet tartalmazó modellek könnyebben elemezhetők és áttekinthetők. 50 tevékenység fölött a folyamatábrák kiszámítása tovább tarthat, és nehezebben olvashatók. A kapcsolódó lépéseket akkor vonja össze, ha ez pontosan tükrözi a folyamatot.
- Változatok sokfélesége: Általában gyorsabban elemezhető az a folyamat, amelyben az esetek többsége néhány útvonalat követ, mint az, amelyben minden eset más útvonalon halad. A nagy változatosság fontos információt hordozhat, de növelheti a lekérdezési időt.
- Oszlopok száma: A folyamat elemzéséhez szükség van az alapmezőkre: CaseId, Activity és Timestamp. A további attribútumok szűréshez és kategorizáláshoz használhatók, de növelik az átvitt és beolvasott adatok mennyiségét.
- Eset hossza: Egy 50 eseményből álló eset feldolgozása több munkát igényel, mint egy 5 eseményből állóé. A több száz eseményt tartalmazó esetekkel rendelkező folyamatok lekérdezése tovább tarthat.
Dashboard-válaszidők
Ezek az értékek több mérési futás mediánjai. A dashboard minden eleme külön lekérdezést futtat, és párhuzamosan töltődik be.
| Adathalmaz | Statisztikák | Folyamatábra | Változatok | Kategóriák | Adatböngésző | Animáció |
|---|---|---|---|---|---|---|
| 100K | 0.6s | 1.5s | 1.1s | 1.5s | 1.2s | 1.4s |
| 1M | 0.6s | 1.6s | 1.4s | 1.9s | 1.5s | 2.0s |
| 5M | 0.6s | 2.5s | 1.8s | 2.4s | 1.3s | 2.1s |
| 10M | 0.6s | 3.4s | 2.2s | 2.5s | 1.6s | 2.4s |
| 20M | 0.6s | 3.9s | 2.7s | 3.3s | 1.9s | 3.6s |
| 50M | 0.6s | 5.1s | 4.2s | 5.7s | 1.6s | 2.7s |
| 100M | 0.6s | 7.2s | 3.5s | 4.7s | 1.6s | 5.0s |
A statisztikák minden vizsgált adathalmaznál körülbelül 0,6 másodperc alatt jelentek meg. A folyamatábra elkészítése tovább tartott, ahogy nőtt az események száma, mert ki kell számítani a tevékenységek közötti átmeneteket. A változatok és a kategóriák kezelése mérsékelten lassult, az adatböngésző pedig lapozással gyors maradt. Az animáció ideje a megjelenített aktív esetek számától függött.
1–10 millió eseménynél a mért válaszidő az adott elemtől függően 0,6 és 3,4 másodperc között volt. 50 millió eseménynél a folyamatábra és a kategóriák megjelenítése körülbelül 5–6 másodpercig tartott. Ezek mérési eredmények, nem jelentenek garanciát minden adathalmazra és környezetre.
Mérési adatok: milyen körülmények között zajlottak a tesztek?
A méréseket éles AWS-infrastruktúrán végeztük 2026 márciusában. A feltöltési és előfeldolgozási idők több tesztfutás átlagai. A dashboard válaszideje több futás mediánja. Az egyes adathalmazméreteknél több mint 50 lekérdezéstípust vizsgáltunk.
Az alábbi eseményszámok a tesztfájlok tényleges adatait mutatják. A fájlméretek tömörítetlen CSV-re vonatkoznak, tipikus eseménynapló-sémával: CaseId, Activity, Timestamp és 5–8 üzleti attribútum. Az Ön fájlmérete és eredményei az oszlopok számától, a tartalomtól, a hálózati feltételektől, az adatközpont távolságától és az aktuális terheléstől függően eltérhetnek.
Feltöltési és előfeldolgozási idők
| Adathalmaz | Tényleges eseményszám | Fájlméret | Feltöltés (1 Gbps) | Feltöltés (100 Mbps) | Feltöltés (50 Mbps) | Feltöltés (10 Mbps) | Előfeldolgozás |
|---|---|---|---|---|---|---|---|
| 100K | 125,260 | 22 MB | < 1s | 2s | 4s | 22s | 35s |
| 500K | 626,300 | 110 MB | 1s | 11s | 22s | 2 min | 45s |
| 1M | 1,253,424 | 221 MB | 3s | 22s | 44s | 4 min | 55s |
| 2M | 2,506,848 | 443 MB | 5s | 44s | 1.5 min | 7 min | 1 min |
| 5M | 4,996,877 | 1.1 GB | 13s | 2 min | 4 min | 18 min | 1.5 min |
| 10M | 12,511,867 | 2.2 GB | 25s | 4 min | 7 min | 37 min | 1.5 min |
| 20M | 25,023,734 | 4.4 GB | 50s | 7 min | 15 min | 1.2 hr | 2 min |
| 50M | 62,559,335 | 11.1 GB | 2 min | 18 min | 37 min | 3 hr | 2 min |
| 100M | 125,118,670 | 22.3 GB | 4 min | 37 min | 1.2 hr | 6 hr | 2.5 min |
A mért 1 Gbps átviteli sebesség 88 MB/s volt az AWS eu-central-1 régiójába. A többi sebesség gyakorlati átviteli értékeken alapuló becslés: 50 Mbps-nél körülbelül 5 MB/s, 100 Mbps-nél 10 MB/s, 10 Mbps-nél pedig 1 MB/s. A tényleges sebesség az Ön hálózatától és a körülményektől függ.
Ebben a tesztben az előfeldolgozás 35 másodperctől 2,5 percig tartott. A fájlméret növekedésével a feltöltési idő is nőtt, így nagy fájloknál ez tette ki a várakozás legnagyobb részét.
Fájlformátumok: Parquet és ORC a CSV-hez képest
A ProcessMind a CSV, Parquet, ORC, Excel és XES formátumokat támogatja. Az alábbi fájlméret-összehasonlítás ugyanazokat az eseményszámokat és sémát használja, mint a fenti mérés.
| Adathalmaz | CSV | Parquet | ORC | CSV.GZ |
|---|---|---|---|---|
| 1M esemény | 221 MB | 34 MB | 39 MB | 20 MB |
| 5M esemény | 1.1 GB | 151 MB | 197 MB | 107 MB |
| 10M esemény | 2.2 GB | 301 MB | 395 MB | 215 MB |
| 20M esemény | 4.4 GB | 603 MB | 791 MB | 430 MB |
| 50M esemény | 11.1 GB | 1.7 GB | 1.9 GB | 1.1 GB |
| 100M esemény | 22.3 GB | 3.4 GB | 3.7 GB | 2.2 GB |
Ezekben a tesztekben a Parquet-fájlok körülbelül 85%-kal, az ORC-fájlok pedig 82%-kal voltak kisebbek a CSV-nél. Mindkettő beépített tömörítést használó oszlopalapú formátum. Az olyan adatkezelő eszközök, mint a Spark, a Databricks, a dbt és a BigQuery, támogathatják az exportálást ezekbe a formátumokba.
A Parquet, az ORC és a CSV előfeldolgozási ideje hasonló volt. Nagyobb eseményszámnál a CSV.GZ feldolgozása tovább tartott, mert a gzip-fájlok nem oszthatók fel párhuzamos kitömörítéshez.
| Adathalmaz | Parquet | ORC | CSV | CSV.GZ |
|---|---|---|---|---|
| 1M esemény | 55s | 55s | 55s | 55s |
| 5M esemény | 1.5 min | 1.5 min | 1.5 min | 1.5 min |
| 10M esemény | 1.5 min | 1.5 min | 1.5 min | 2 min |
| 20M esemény | 2 min | 2 min | 2 min | 2.5 min |
| 50M esemény | 2 min | 2 min | 2 min | 3 min |
| 100M esemény | 2.5 min | 2.5 min | 2.5 min | 4.5 min |
A teljes idő a feltöltés és az előfeldolgozás idejéből áll össze. Az alábbi példák 100 Mbps sebességű kapcsolattal készültek.
| 10M esemény (100 Mbps) | Fájlméret | Feltöltés | Előfeldolgozás | Összesen |
|---|---|---|---|---|
| Parquet | 301 MB | 30s | 1.5 min | ~2 min |
| ORC | 395 MB | 40s | 1.5 min | ~2.2 min |
| CSV | 2.2 GB | 4 min | 1.5 min | ~5.5 min |
| CSV.GZ | 215 MB | 21s | 2 min | ~2.5 min |
| 50M esemény (100 Mbps) | Fájlméret | Feltöltés | Előfeldolgozás | Összesen |
|---|---|---|---|---|
| Parquet | 1.7 GB | 3 min | 2 min | ~5 min |
| ORC | 1.9 GB | 3.2 min | 2 min | ~5.2 min |
| CSV | 11.1 GB | 18 min | 2 min | ~20 min |
| CSV.GZ | 1.1 GB | 2 min | 3 min | ~5 min |
Nagy adathalmazoknál a Parquet és az ORC a kisebb fájlméretnek köszönhetően csökkenti az átviteli időt. A CSV egyszerű megoldás kisebb adathalmazokhoz, illetve akkor, ha az exportálási folyamat nem támogat oszlopalapú formátumokat. A CSV.GZ lassú kapcsolatnál csökkentheti az átviteli időt, de az adathalmaz méretével nő a kitömörítés ideje.
Fájlformátum választása
- Parquet: Jó alapértelmezett választás nagy adathalmazokhoz, ha az adatfolyamat támogatja. Ezekben a tesztekben ez eredményezte a legkisebb fájlokat.
- ORC: Hasonló lehetőség, különösen akkor, ha az adatfolyamat Hadoopot vagy Sparkot használ.
- CSV: Egyszerű és széles körben támogatott formátum. Kisebb adathalmazokhoz praktikus lehet.
- CSV.GZ: Akkor érdemes választani, ha a feltöltési sebesség jelenti a fő korlátot. Nagyobb eseményszámnál tesztelje az előfeldolgozási időt a saját adataival.
Mely lekérdezési minták lassíthatják az elemzést?
Egyes adatok és dashboard-elrendezések több számítást igényelnek másoknál. Az alábbi szempontok segítenek azonosítani, mi lassíthatja a lekérdezéseket.
- Túl sok tevékenység: Az 50-nél több különböző tevékenységet tartalmazó folyamatábra kiszámítása tovább tarthat, és nehezebb lehet értelmezni. Ha indokolt, vonja össze a kapcsolódó lépéseket.
- Sok egyedi változat: Ha az esetek sokféle útvonalat követnek, a változatok kiszámítása több munkát igényel. A nagy változatosság olyan folyamatműködésre is utalhat, amelyet érdemes megvizsgálni.
- Hosszú esetek: A sok eseményt tartalmazó esetek feldolgozása több időt igényel, mint a rövideké.
- Felesleges oszlopok: A további attribútumok növelik a fájlméretet, és a lekérdezések is több munkát igényelhetnek miattuk. Csak az elemzéshez szükséges mezőket tartsa meg.
- Túlzsúfolt, nagy dashboardok: Minden diagram és csempe külön lekérdezést futtat. Tartsa meg azokat az elemeket, amelyek egyértelmű kérdésre válaszolnak, a többi nézetet pedig helyezze külön dashboardra.
- Nagy számításigényű vizualizációk: Nagy adathalmazoknál a sok kategóriát megjelenítő diagramok kirajzolása tovább tarthat. Ha nincs szüksége részletes bontásra, használjon összesítő nézetet.
- Animáció sok aktív esettel: Az animáció ideje a megjelenített esetek számától függ. Ha csak a folyamat útvonalát szeretné megvizsgálni, csökkentse a sebességet, vagy kapcsolja ki az útvonalnyomokat és az effekteket.
Hogyan válassza ki a megfelelő adatmennyiséget?
Kezdje a kérdés megválaszolásához szükséges legkisebb adathalmazzal. A célzott adathalmaz gyorsabban feltölthető és könnyebben ellenőrizhető. Bővítse, ha szélesebb lefedettségre, ritka események vizsgálatára vagy hosszabb távú trendekre van szüksége.
Kisebb adathalmazon építse fel és ellenőrizze a modellt
Kezdjen egy friss mintával, állítsa be a modellt, majd ellenőrizze az adatokat, mielőtt nagyobb adathalmazra vált.
- Kezdjen egy mintával. Például nyerjen ki 1 millió eseményt egy közelmúltbeli, három hónapos időszakból. A mérésben a feltöltés 1 Gbps sebességgel 3 másodpercig, 100 Mbps sebességgel 22 másodpercig tartott, majd az előfeldolgozás további 55 másodpercet vett igénybe.
- Építse fel a modellt. Állítsa be a tevékenységeket, a szűrőket és a nézeteket. A tesztelt, 1–10 millió eseményt tartalmazó adathalmazoknál a modell módosítása körülbelül 14–20 másodpercig tartott.
- Ellenőrizze az eredményeket. Nézze meg, hogy a tevékenységek nevei és a folyamat útvonalai megfelelnek-e a valóságnak, és javítsa az adatminőségi problémákat.
- Szükség esetén adjon hozzá több adatot. Növelje az események számát, ha ritka eseteket szeretne vizsgálni, vagy hosszabb időszakokat szeretne összehasonlítani.
A táblázat a különböző eseményszámokhoz tartozó kezdeti várakozási időt hasonlítja össze 100 Mbps sebességű kapcsolat mellett.
| Módszer | Feltöltés (100 Mbps) | Előfeldolgozás | Teljes várakozás | Dashboard sebessége |
|---|---|---|---|---|
| Kezdés 1M eseménnyel | 22s | 55s | ~1.5 min | 1–2s |
| Kezdés 5M eseménnyel | 2 min | 1.5 min | ~3.5 min | 1–2.5s |
| Kezdés 50M eseménnyel | 18 min | 2 min | ~20 min | 1–6s |
A megfelelő eseményszám az Ön kérdésétől függ. A gyakori folyamatminták vizsgálatához elegendő lehet egy kisebb adathalmaz, ritka események elemzéséhez vagy a teljes sokaság lefedésére vonatkozó követelmény teljesítéséhez viszont több adatra lehet szükség.
Konkrét kérdés esetén szűkítse az adathalmazt
Ha egy országot, részleget vagy termékvonalat vizsgál, kezdje az adott szegmenssel, ne vonjon össze egymástól független csoportokat. A szegmentálás egyértelműbbé teheti az összehasonlítást, és csökkentheti a feldolgozandó adatmennyiséget.
Például a mérés egy 42 millió szállítási eseményt tartalmazó, 8 országra kiterjedő európai logisztikai adathalmazt mutat be:
- Minden ország: 42 millió esemény, 9,3 GB, 16 perc feltöltés 100 Mbps sebességgel, 2 perc előfeldolgozás.
- Németország: 8,5 millió esemény, 1,9 GB, 3 perc feltöltés, 1,5 perc előfeldolgozás.
- Hollandia: 3,1 millió esemény, 690 MB, 1 perc feltöltés, 1 perc előfeldolgozás.
Az egyes szegmensek ellenőrzése után összehasonlíthatja őket. Hasznos szempont lehet a földrajzi terület, a szervezet, a termék, az időszak vagy az ügyfélszegmens.
Szűrjön a szükséges esetekre
Ha kivételeket vizsgál, csak a releváns esetek exportálásával jelentősen csökkentheti az adathalmaz méretét. A mérés például egy 1,2 millió beszerzési rendelést és 8,4 millió eseményt tartalmazó beszerzéstől kifizetésig folyamatot mutat be. Eszerint 96 000 rendelésnél, vagyis az esetek 8%-ánál fordult elő kivétel, például elutasítás, visszáru, duplikált számla vagy hiányzó jóváhagyás.
Ebben az elemzésben a kivételes esetek exportálásával az adathalmaz 8,4 millióról 670 ezer eseményre csökken. A jelentés szerint a fájlméret 1,9 GB-ról 150 MB-ra, a feltöltési idő pedig 100 Mbps sebességnél 3 percről 15 másodpercre esik. Ha ugyanezt az adatot 15 MB-os Parquet-fájlként exportálja, a mérésben a feltöltés kevesebb mint 2 másodpercig tartott.
Szűrjön állapot, tevékenység, eset időtartama, időszak vagy üzleti egység szerint, ha ezek a mezők kapcsolódnak a vizsgált kérdéshez.
Csak a szükséges oszlopokat válassza ki
Minden oszlop növeli a fájlméretet. A hosszú szöveges mezők, a redundáns azonosítók, az auditmezők és a technikai metaadatok nem feltétlenül szükségesek az elemzéshez.
A mérés egy 1,8 millió beszerzési rendelési eseményt tartalmazó, 45 oszlopos SAP-exportot mutat be. A fájlméret a 12 szükséges oszlopra szűkítve 2,1 GB-ról 380 MB-ra csökkent. Ha ezeket az oszlopokat Parquet formátumban exportálta, a fájl mérete tovább, 58 MB-ra esett. A jelentés szerint a feltöltési idő 100 Mbps sebességnél 3,5 percről 6 másodpercre csökkent.
Tartsa meg az elemzéshez szükséges mezőket, köztük a CaseId, Activity és Timestamp mezőt, valamint a releváns üzleti attribútumokat, például az állapotot, az összeget, a kategóriát vagy a régiót. Ha a személyes adatokra nincs szükség az elemzéshez, távolítsa el őket.
Mikor érdemes nagyobb adathalmazt használni?
Ha a kérdés megválaszolásához szélesebb lefedettségre vagy hosszabb időszakra van szükség, érdemes több eseményt tartalmazó adathalmazzal dolgozni.
- Ritka események: A 100 000 esetből egyszer előforduló kivételek megtalálásához olyan nagy adathalmazra van szükség, amelyben ezek is szerepelnek. Ha egy kivétel az esetek 0,01%-ában fordul elő, és 50 ilyen esetet szeretne vizsgálni, körülbelül 500 000 esetre lesz szüksége.
- Ritkán előforduló változatok: Az esetek 0,1%-ában előforduló változatok egy 1 millió eseményes mintában láthatatlanok maradhatnak, míg egy 50 millió eseményt tartalmazó adathalmazban már jól mérhetők.
- Megfelelés és audit: Egyes követelmények mintavétel helyett a teljes adathalmaz lefedését írják elő.
- Hosszú távú trendek: A 2024. első negyedévének, 2025. első negyedévének és 2026. első negyedévének összehasonlításához mindhárom időszak adataira szükség van. A delta betöltéssel fokozatosan bővítheti a lefedettséget.
Az 50 millió eseménynél nagyobb adathalmazokhoz a benchmark Parquet használatát, az API-n keresztüli feltöltést és, ha elérhető, gyors hálózati kapcsolatot javasol. A tesztben az 50 millió eseményes CSV-fájl 11,1 GB volt, míg Parquet formátumban 1,7 GB.
A teljesítmény mindig kompromisszumokkal jár: a több adat és a nagyobb sebesség többe kerül. Nem az a kérdés, hogy mire képes egy eszköz, hanem az, hogy mire van szüksége a folyamatának. A ProcessMind nagy adathalmazokkal is jól működik, de a rendkívül nagy adatmennyiségeket továbbra sem javasoljuk, mert gyakran nincs rájuk szükség, és a velük járó bonyolultság elvonhatja a figyelmet magáról a folyamatfejlesztésről.
Hogyan maradhat gyors a modell és a felület?
Az adatmennyiség csak az egyik tényező. A folyamatmodell és a dashboard kialakítása is befolyásolja, milyen gyorsan tud dolgozni.
- Tartsa áttekinthetően a modellt: A nagy folyamatokat bontsa moduláris Subprocesses elemekre. A sok látható elemet tartalmazó vászon lassabban jelenhet meg, és nehezebb rajta tájékozódni. Szerkezeti módosítások után használja az auto-layout funkciót.
- Gondosan válassza ki a dashboard elemeit: Minden diagram és csempe számításokat igényel. Csak azokat a nézeteket tartsa meg, amelyek választ adnak az aktuális kérdéseire.
- Az adatokhoz illő diagramokat használjon: Nagy adathalmazoknál a sok kategóriát megjelenítő vizualizáció kiszámítása tovább tarthat. Ha nincs szüksége részletes bontásra, használjon összesítést.
- Csak a kérdéshez szükséges szűrőket használja: A szűrők segítenek szűkíteni az elemzést. Ne kombináljon olyan szűrőket, amelyek nem segítenek megválaszolni a kérdést.
- Állítsa be az animációt: Az animáció terhelése az aktív esetek számával nő. Ha csak a folyamat menetét szeretné megvizsgálni, csökkentse a sebességet, vagy kapcsolja ki a nyomvonalakat és az effekteket. További információ: Process Animation.
- Csak a módosult részeket számítsa újra: A modell módosításakor a modellfüggő számítások frissülnek, így nem kell újra lefuttatni a teljes előfeldolgozást. A benchmarkban a módosítások 1 millió eseménynél körülbelül 14 másodpercig, 100 millió eseménynél pedig 52 másodpercig tartottak.
Hogyan csökkenti a delta betöltés a feltöltési időt?
Delta betöltéssel az új eseményeket egy meglévő adathalmazhoz fűzheti, így nem kell minden alkalommal a teljes adathalmazt feltöltenie. Növekvő eseménynapló frissítésekor kevesebb adatot kell továbbítani.
| Forgatókönyv | Teljes újrafeltöltés | Delta feltöltés | Megtakarított idő |
|---|---|---|---|
| 10 millió meglévő + 500 000 új esemény (100 Mbps) | 4 perc feltöltés | 5 mp feltöltés | ~4 perc |
| 20 millió meglévő + 2 millió új esemény (100 Mbps) | 7 perc feltöltés | 44 mp feltöltés | ~6 perc |
| 50 millió meglévő + 5 millió új esemény (100 Mbps) | 18 perc feltöltés | 2 perc feltöltés | ~16 perc |
Delta feltöltés után az előfeldolgozás újra lefut az egyesített adathalmazon. A benchmarkban ez 1–2,5 percet vett igénybe. A feltöltéssel megtakarított idő abból adódik, hogy csak az új eseményeket kell továbbítani.
A deltafájlnak ugyanazt a fájlformátumot és oszlopszerkezetet kell használnia, mint az eredeti feltöltésnek. Részletekért tekintse meg a növekményes adatbetöltés útmutatóját.
Mikor érdemes API-n keresztül feltölteni?
Rendszeresen feltöltött vagy több gigabájtos fájlok esetén az API-s feltöltés könnyebben kezelhető lehet, mint a böngészőn keresztüli adatátvitel. Egy script vagy parancssori eszköz beilleszthető az ETL-folyamatba, támogatja az ütemezett feltöltéseket, és megjeleníti az átvitel állapotát.
A ProcessMind előre aláírt URL-eket biztosít a felhőtárhelyre történő közvetlen feltöltéshez. A feltöltési URL-t a ProcessMind felületén, az adathalmaz beállításai menüből másolhatja ki.
# Upload a Parquet file directly using a presigned URL
curl -X PUT "$PRESIGNED_URL" --upload-file data.parquet
A API-dokumentációban Bash-, JavaScript- és Python-példákat talál, többek között az előre aláírt URL-ek lekérésére és a deltafájlok feltöltésére.
Mikor érdemes felosztani egy adathalmazt?
Ossza fel az adathalmazt, ha egy adott elemzéshez csak az adatok egy részére van szükség, vagy ha különálló csoportokat önállóan szeretne összehasonlítani. Az adatokat földrajzi terület, részleg, termékvonal, időszak vagy esettípus szerint szegmentálhatja, majd külön-külön elemezheti az egyes adathalmazokat.
Hagyja együtt az adatokat, ha a kérdés megválaszolásához össze kell hasonlítania a csoportokat, vagy követnie kell a teljes folyamatot az összes csoportban. Felosztás előtt ellenőrizze, hogy az nem változtatja-e meg az eset jelentését, és nem távolít-e el olyan eseményeket, amelyek szükségesek az útvonal megértéséhez. Időszak szerinti felosztásnál például vegye figyelembe azokat az eseteket, amelyek az egyik időszakban kezdődnek, de a másikban fejeződnek be.
Tesztelje a teljesítményt a saját adataival
A benchmarkok segítenek a tervezésben, de nem jelzik előre minden eseménynapló, hálózat vagy lekérdezés eredményét. Tesztelje a használni kívánt adathalmazt, majd mérje meg a feltöltési és előfeldolgozási időt, valamint az Önnek fontos dashboard-nézetek válaszidejét.
Ha segítségre van szüksége az eseménynapló előkészítéséhez, először olvassa el az adat-előkészítési útmutatót. Azt is megnézheti, hogyan elemezheti a folyamatát, illetve hogyan követheti folyamatosan a folyamatát.
Tesztelje a saját adatmennyiségével
Töltse be az elemezni kívánt eseménynaplót, és mérje meg, hogyan teljesít a saját adataival.