Process mining 성능: 벤치마크와 개선 방법
데이터 양, 파일 형식, 쿼리 구조가 process mining 성능에 미치는 영향을 확인하세요. 100K~100M 이벤트를 대상으로 측정한 벤치마크와 측정 시점도 함께 소개합니다.

Process mining 성능은 이벤트 수만으로 결정되지 않습니다. 파일 크기, 케이스 수, 쿼리 구조, 네트워크 처리량에 따라 대기 시간이 달라집니다. 아래 벤치마크는 100K~100M 이벤트 데이터셋을 대상으로 합니다. 2026년 3월 AWS 운영 환경에서 이 페이지에 설명한 파일 형식과 테스트 조건으로 측정했습니다.
주요 내용
- 파일이 크거나 연결 속도가 느리면 업로드 시간이 전체 대기 시간의 대부분을 차지할 수 있습니다.
- Parquet과 ORC 파일은 원본 CSV보다 훨씬 작아 전송 시간이 줄어듭니다.
- 대시보드 응답 시간은 쿼리에 따라 달라집니다. 통계는 빠르게 표시되지만 이벤트 수가 늘수록 프로세스 흐름을 계산하는 데 시간이 더 걸립니다.
- Delta 로딩을 사용하면 전체 데이터셋을 다시 업로드하지 않고 새 이벤트만 전송할 수 있습니다.
- 필요한 데이터만 추린 데이터셋은 업로드가 빠르고 분석하기도 쉽습니다.
Process mining 성능을 좌우하는 요인은 무엇인가요?
성능은 네 가지 요인에 따라 달라집니다. 데이터 양, 이벤트 로그 구조, 실행하는 쿼리, 그리고 데이터를 전송하고 처리하는 환경입니다.
- 이벤트 수와 케이스 수: 이벤트가 많을수록 업로드하고 처리할 데이터가 늘어나는 것이 일반적입니다. 케이스 수에 따라 분석 대상 프로세스 인스턴스의 수가 결정됩니다.
- 쿼리 구조: 요약 통계와 프로세스 흐름은 서로 다른 계산이 필요합니다. 활동 간 전환을 계산하는 쿼리는 미리 집계된 데이터를 조회하는 쿼리보다 오래 걸릴 수 있습니다.
- 활동 수와 케이스 길이: 서로 다른 활동이 많고 케이스가 길수록 흐름과 변형을 계산하는 작업이 늘어납니다.
- 파일 크기와 네트워크 속도: 이 두 요인이 업로드 시간을 결정합니다. 텍스트 필드가 긴 넓은 CSV는 같은 이벤트를 담은 압축된 컬럼형 파일보다 훨씬 클 수 있습니다.
이벤트 수만으로 데이터셋 처리 시간을 예측할 수는 없습니다. 벤치마크를 참고 자료로 활용하되, 실제 사용할 이벤트 로그와 쿼리를 테스트하세요. 자신의 환경에서 process mining 성능을 파악하는 가장 효과적인 방법입니다.
데이터 파이프라인: 시간은 어디에 쓰이나요?
데이터셋은 업로드, 전처리, 프로세스 모델 변경에 따른 재계산의 세 단계를 거칩니다.
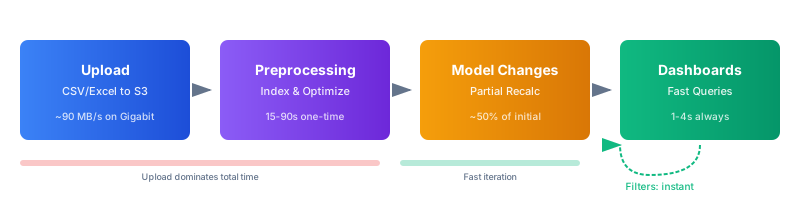
- 업로드: 파일은 인터넷을 통해 ProcessMind의 클라우드 인프라로 전송됩니다. 네트워크 처리량과 파일 크기에 따라 전송 시간이 달라집니다. 예를 들어 5,000만 이벤트가 담긴 11GB CSV 파일은 1Gbps에서 약 2분, 100Mbps에서 18분, 10Mbps에서 3시간 넘게 걸립니다. 같은 데이터가 1.7GB Parquet 파일이면 각각 약 19초, 3분, 28분이 걸립니다.
- 전처리: 업로드 후 시스템은 데이터를 최적화된 컬럼형 스토리지로 변환하고, 이벤트를 색인하며, 활동 전환과 프로세스 변형을 계산하고 요약 통계를 생성합니다. 아래 벤치마크에서는 100K 이벤트에 35초, 100M 이벤트에 최대 2.5분이 걸렸습니다.
- 모델 변경: 활동 매핑을 변경하거나 활동을 추가 또는 제거하면 ProcessMind가 모델에 따라 달라지는 계산을 업데이트합니다. 아래 벤치마크에서는 1M 이벤트에 약 14초, 100M 이벤트에 52초가 걸렸습니다. 필터 변경은 즉시 반영됩니다.
대규모 데이터셋에서는 파일 크기를 줄이는 것이 초기 대기 시간을 단축하는 가장 효과적인 방법인 경우가 많습니다. 전처리 후에는 대시보드에서 계산할 내용에 따라 쿼리 성능이 달라집니다.
쿼리 성능은 어떻게 달라지나요?
쿼리마다 처리 비용이 다릅니다. 다음 특성을 참고하면 예상되는 성능과 데이터 구성 방법을 파악하는 데 도움이 됩니다.
- 활동 수: 활동이 10~20개인 모델은 분석하고 표시하기가 더 쉽습니다. 활동이 50개를 넘으면 프로세스 플로우 계산에 시간이 더 걸리고 읽기도 어려워질 수 있습니다. 프로세스를 정확히 나타내는 경우 관련 단계를 그룹화합니다.
- 변형 다양성: 대부분의 케이스가 몇 가지 경로를 따르는 프로세스는 케이스마다 경로가 다른 프로세스보다 일반적으로 분석이 빠릅니다. 변형이 많다는 점은 의미 있는 정보일 수 있지만, 쿼리 시간이 늘어날 수 있습니다.
- 열 수: 프로세스 분석에는 CaseId, Activity, Timestamp가 필요합니다. 추가 속성은 필터링과 분류에 도움이 되지만, 전송하고 검색할 데이터가 늘어납니다.
- 케이스 길이: 이벤트가 50개인 케이스는 5개인 케이스보다 처리할 데이터가 많습니다. 케이스당 이벤트가 수백 개에 이르는 프로세스는 쿼리 시간이 더 길어질 수 있습니다.
대시보드 응답 시간
아래 중앙값은 여러 차례 벤치마크를 실행해 얻은 결과입니다. 대시보드 구성 요소는 각각 별도의 쿼리를 실행하며 병렬로 로드됩니다.
| 데이터셋 | 통계 | 프로세스 흐름 | 변형 | 범주 | 데이터 브라우저 | 애니메이션 |
|---|---|---|---|---|---|---|
| 100K | 0.6s | 1.5s | 1.1s | 1.5s | 1.2s | 1.4s |
| 1M | 0.6s | 1.6s | 1.4s | 1.9s | 1.5s | 2.0s |
| 5M | 0.6s | 2.5s | 1.8s | 2.4s | 1.3s | 2.1s |
| 10M | 0.6s | 3.4s | 2.2s | 2.5s | 1.6s | 2.4s |
| 20M | 0.6s | 3.9s | 2.7s | 3.3s | 1.9s | 3.6s |
| 50M | 0.6s | 5.1s | 4.2s | 5.7s | 1.6s | 2.7s |
| 100M | 0.6s | 7.2s | 3.5s | 4.7s | 1.6s | 5.0s |
테스트한 데이터셋 크기와 관계없이 통계는 약 0.6초로 일정했습니다. 프로세스 흐름은 활동 간 전환을 계산하므로 이벤트 수가 늘수록 처리 시간이 길어졌습니다. 변형과 범주는 처리 시간이 완만하게 늘었고, 페이지 단위로 표시하는 데이터 브라우저는 응답성을 유지했습니다. 애니메이션 시간은 표시되는 활성 케이스 수에 따라 달라졌습니다.
이벤트가 1M10M일 때 구성 요소에 따라 측정된 응답 시간은 0.63.4초였습니다. 50M 이벤트에서는 프로세스 흐름과 범주에 약 5~6초가 걸렸습니다. 이는 벤치마크 결과이며 모든 데이터셋이나 환경에서 같은 성능을 보장하지는 않습니다.
벤치마크 데이터: 테스트 조건은 무엇이었나요?
이 벤치마크는 2026년 3월 AWS 운영 환경에서 실행했습니다. 업로드와 전처리 시간은 여러 차례 테스트한 결과의 평균이며, 대시보드 응답 시간은 여러 차례 실행한 결과의 중앙값입니다. 데이터셋 크기별로 50가지가 넘는 쿼리 유형을 테스트했습니다.
아래 이벤트 수는 테스트 파일에서 실제로 집계한 값입니다. 파일 크기는 일반적인 이벤트 로그 스키마(CaseId, Activity, Timestamp 및 업무 속성 5~8개)를 사용한 압축 전 CSV 기준입니다. 파일 크기와 결과는 열 수, 콘텐츠, 네트워크 상태, 데이터 센터까지의 거리, 현재 부하에 따라 달라집니다.
업로드 및 전처리 시간
| 데이터셋 | 실제 이벤트 수 | 파일 크기 | 업로드 (1 Gbps) | 업로드 (100 Mbps) | 업로드 (50 Mbps) | 업로드 (10 Mbps) | 전처리 |
|---|---|---|---|---|---|---|---|
| 100K | 125,260 | 22 MB | < 1s | 2s | 4s | 22s | 35s |
| 500K | 626,300 | 110 MB | 1s | 11s | 22s | 2 min | 45s |
| 1M | 1,253,424 | 221 MB | 3s | 22s | 44s | 4 min | 55s |
| 2M | 2,506,848 | 443 MB | 5s | 44s | 1.5 min | 7 min | 1 min |
| 5M | 4,996,877 | 1.1 GB | 13s | 2 min | 4 min | 18 min | 1.5 min |
| 10M | 12,511,867 | 2.2 GB | 25s | 4 min | 7 min | 37 min | 1.5 min |
| 20M | 25,023,734 | 4.4 GB | 50s | 7 min | 15 min | 1.2 hr | 2 min |
| 50M | 62,559,335 | 11.1 GB | 2 min | 18 min | 37 min | 3 hr | 2 min |
| 100M | 125,118,670 | 22.3 GB | 4 min | 37 min | 1.2 hr | 6 hr | 2.5 min |
AWS eu-central-1까지 측정한 1 Gbps 전송 속도는 88 MB/s였습니다. 다른 속도는 실제 처리량을 기준으로 추산했습니다. 50 Mbps에서는 약 5 MB/s, 100 Mbps에서는 10 MB/s, 10 Mbps에서는 1 MB/s입니다. 실제 처리량은 네트워크와 환경에 따라 달라집니다.
이 테스트에서 전처리 시간은 35초에서 2.5분 사이였습니다. 파일이 클수록 업로드 시간이 늘어나 대용량 파일의 전체 대기 시간에서 가장 큰 비중을 차지했습니다.
파일 형식: Parquet 및 ORC와 CSV 비교
ProcessMind는 CSV, Parquet, ORC, Excel, XES를 지원합니다. 아래 파일 크기 비교는 앞서 소개한 벤치마크와 이벤트 수 및 스키마가 같습니다.
| 데이터셋 | CSV | Parquet | ORC | CSV.GZ |
|---|---|---|---|---|
| 1M 이벤트 | 221 MB | 34 MB | 39 MB | 20 MB |
| 5M 이벤트 | 1.1 GB | 151 MB | 197 MB | 107 MB |
| 10M 이벤트 | 2.2 GB | 301 MB | 395 MB | 215 MB |
| 20M 이벤트 | 4.4 GB | 603 MB | 791 MB | 430 MB |
| 50M 이벤트 | 11.1 GB | 1.7 GB | 1.9 GB | 1.1 GB |
| 100M 이벤트 | 22.3 GB | 3.4 GB | 3.7 GB | 2.2 GB |
이 테스트에서 Parquet 파일은 CSV보다 약 85%, ORC 파일은 약 82% 작았습니다. 두 형식 모두 압축 기능이 내장된 컬럼형 파일 형식입니다. Spark, Databricks, dbt, BigQuery 같은 데이터 도구에서 이 형식으로 내보낼 수 있습니다.
Parquet, ORC, CSV의 전처리 시간은 비슷했습니다. 이벤트 수가 많을 때 CSV.GZ의 전처리에 시간이 더 걸렸습니다. gzip 파일은 병렬 압축 해제를 위해 분할할 수 없기 때문입니다.
| 데이터셋 | Parquet | ORC | CSV | CSV.GZ |
|---|---|---|---|---|
| 1M 이벤트 | 55s | 55s | 55s | 55s |
| 5M 이벤트 | 1.5 min | 1.5 min | 1.5 min | 1.5 min |
| 10M 이벤트 | 1.5 min | 1.5 min | 1.5 min | 2 min |
| 20M 이벤트 | 2 min | 2 min | 2 min | 2.5 min |
| 50M 이벤트 | 2 min | 2 min | 2 min | 3 min |
| 100M 이벤트 | 2.5 min | 2.5 min | 2.5 min | 4.5 min |
전체 시간은 업로드와 전처리에 걸린 시간을 합한 값입니다. 아래 예시는 100 Mbps 연결을 기준으로 합니다.
| 10M 이벤트 (100 Mbps) | 파일 크기 | 업로드 | 전처리 | 전체 |
|---|---|---|---|---|
| Parquet | 301 MB | 30s | 1.5 min | ~2 min |
| ORC | 395 MB | 40s | 1.5 min | ~2.2 min |
| CSV | 2.2 GB | 4 min | 1.5 min | ~5.5 min |
| CSV.GZ | 215 MB | 21s | 2 min | ~2.5 min |
| 50M 이벤트 (100 Mbps) | 파일 크기 | 업로드 | 전처리 | 전체 |
|---|---|---|---|---|
| Parquet | 1.7 GB | 3 min | 2 min | ~5 min |
| ORC | 1.9 GB | 3.2 min | 2 min | ~5.2 min |
| CSV | 11.1 GB | 18 min | 2 min | ~20 min |
| CSV.GZ | 1.1 GB | 2 min | 3 min | ~5 min |
대규모 데이터셋에서는 Parquet과 ORC의 파일 크기가 작아 전송 시간을 줄일 수 있습니다. 소규모 데이터셋이나 내보내기 과정에서 컬럼형 파일 형식을 지원하지 않는 경우에는 CSV를 간편하게 사용할 수 있습니다. CSV.GZ는 네트워크 속도가 느릴 때 전송 시간을 줄일 수 있지만, 데이터셋이 클수록 압축 해제에 더 많은 시간이 듭니다.
파일 형식 선택하기
- Parquet: 데이터 파이프라인에서 지원한다면 대규모 데이터셋에 기본 형식으로 사용하기 좋습니다. 이 테스트에서 파일 크기가 가장 작았습니다.
- ORC: 데이터 파이프라인에서 Hadoop이나 Spark를 사용한다면 적합한 대안입니다.
- CSV: 간단하고 널리 지원되는 형식입니다. 소규모 데이터셋에 실용적입니다.
- CSV.GZ: 업로드 속도가 가장 큰 제약일 때 고려하세요. 특히 이벤트 수가 많은 경우에는 실제 데이터로 전처리 시간을 확인하세요.
어떤 쿼리 유형이 분석을 느리게 하나요?
데이터와 대시보드 구성에 따라 필요한 처리량이 달라집니다. 다음 항목을 확인해 쿼리 지연의 원인을 찾아보세요.
- 활동이 너무 많음: 서로 다른 활동이 50개를 넘는 프로세스 흐름은 계산에 시간이 더 걸리고 해석하기 어려울 수 있습니다. 적절한 경우 관련 단계를 묶으세요.
- 서로 다른 변형이 많음: 케이스마다 경로가 다양하면 변형 계산에 더 많은 작업이 필요합니다. 변동성이 높다면 조사해 볼 만한 프로세스 특성이 있다는 뜻일 수도 있습니다.
- 케이스가 김: 이벤트가 많은 케이스는 짧은 케이스보다 처리량이 많습니다.
- 불필요한 열: 추가 속성은 파일 크기를 늘리고 해당 속성을 쿼리할 때 처리량을 늘릴 수 있습니다. 분석에 필요한 필드만 유지하세요.
- 구성이 복잡하고 항목이 많은 대시보드: 차트나 타일은 각각 별도의 쿼리를 실행합니다. 명확한 질문에 답하는 구성 요소만 두고, 다른 화면은 별도의 대시보드에 배치하세요.
- 처리량이 큰 시각화: 대규모 데이터셋에서는 범주가 많은 차트를 표시하는 데 시간이 더 걸릴 수 있습니다. 세부 구분이 필요하지 않다면 요약 화면을 사용하세요.
- 활성 케이스가 많은 애니메이션: 애니메이션 시간은 표시되는 케이스 수에 따라 달라집니다. 흐름만 살펴보면 된다면 재생 속도를 낮추거나 꼬리 효과와 시각 효과를 끄세요.
적절한 데이터 크기는 어떻게 선택하나요?
질문에 답할 수 있는 가장 작은 데이터셋부터 시작하세요. 필요한 데이터만 담은 데이터셋은 업로드가 빠르고 검증하기도 쉽습니다. 더 넓은 범위나 드문 이벤트, 장기 추세를 살펴봐야 할 때 데이터셋을 확장하세요.
소규모 데이터셋으로 모델을 만들고 검증하기
최근 데이터에서 일부를 추출해 시작하고, 모델을 설정한 다음 데이터가 적절한지 확인한 뒤 규모를 늘리세요.
- 샘플부터 시작하세요. 예를 들어 최근 3개월에서 이벤트 1M개를 추출합니다. 벤치마크에서는 1Gbps에서 업로드에 3초, 100Mbps에서 22초가 걸렸고, 전처리에는 55초가 걸렸습니다.
- 모델을 구성하세요. 활동, 필터, 화면을 설정합니다. 테스트한 1M
10M 이벤트 데이터셋에서는 모델 변경에 약 1420초가 걸렸습니다. - 분석 결과를 검증하세요. 활동 이름과 프로세스 경로가 타당한지 확인하고 데이터 품질 문제를 해결하세요.
- 필요하면 데이터를 추가하세요. 드문 케이스를 조사하거나 더 긴 기간을 비교해야 할 때 이벤트 수를 늘리세요.
아래 표는 100 Mbps 연결에서 이벤트 수에 따라 초기 대기 시간이 어떻게 달라지는지 보여줍니다.
| 접근 방식 | 업로드 (100 Mbps) | 전처리 | 전체 대기 시간 | 대시보드 속도 |
|---|---|---|---|---|
| 이벤트 1M부터 시작 | 22s | 55s | ~1.5 min | 1–2s |
| 이벤트 5M부터 시작 | 2 min | 1.5 min | ~3.5 min | 1–2.5s |
| 이벤트 50M부터 시작 | 18 min | 2 min | ~20 min | 1–6s |
적절한 이벤트 수는 질문에 따라 달라집니다. 일반적인 프로세스 패턴을 파악하는 데는 소규모 데이터셋으로 충분할 수 있지만, 드문 이벤트를 조사하거나 전체 모집단을 빠짐없이 분석해야 한다면 더 많은 데이터가 필요합니다.
질문이 구체적이라면 데이터 범위를 나누세요
특정 국가, 부서, 제품군을 조사한다면 서로 관련 없는 그룹을 합치기보다 해당 범위의 데이터부터 살펴보세요. 데이터를 나누면 비교가 명확해지고 처리할 데이터 양도 줄일 수 있습니다.
예를 들어 벤치마크에서는 8개국의 배송 이벤트 42M건으로 구성된 유럽 물류 데이터셋을 소개합니다.
- 전체 국가: 이벤트 42M건, 9.3 GB. 100 Mbps에서 업로드에 16분, 전처리에 2분이 걸립니다.
- 독일: 이벤트 8.5M건, 1.9 GB. 업로드에 3분, 전처리에 1.5분이 걸립니다.
- 네덜란드: 이벤트 3.1M건, 690 MB. 업로드에 1분, 전처리에 1분이 걸립니다.
각 범위를 검증한 뒤 서로 비교할 수 있습니다. 지역, 조직, 제품, 기간, 고객군 등을 기준으로 나눠 살펴보세요.
필요한 케이스만 필터링하세요
예외 상황을 조사한다면 관련 케이스만 내보내 데이터셋을 크게 줄일 수 있습니다. 예를 들어 벤치마크에서는 구매부터 지급까지의 프로세스에 구매 주문 120만 건과 이벤트 8.4M건이 포함된 사례를 소개합니다. 이 가운데 96,000건, 즉 8%에서 거부, 반품, 중복 청구서, 승인 누락 등의 예외가 발생했습니다.
이 분석에서 예외 케이스만 내보내면 데이터셋이 이벤트 8.4M건에서 670K건으로 줄어듭니다. 파일 크기는 1.9 GB에서 150 MB로, 100 Mbps에서 업로드 시간은 3분에서 15초로 감소합니다. 같은 데이터를 15 MB Parquet 파일로 내보내면 벤치마크 기준 업로드에 2초도 걸리지 않습니다.
조사하려는 질문에 맞는 필드가 있다면 상태, 활동, 케이스 기간, 기간 범위, 사업부 등을 기준으로 필터링하세요.
필요한 열만 선택하세요
열마다 파일 크기가 늘어납니다. 긴 텍스트 필드, 중복 식별자, 감사 필드, 기술 메타데이터는 분석에 필요하지 않을 수 있습니다.
벤치마크에서는 열이 45개인 SAP 구매 주문 이벤트 1.8M건을 내보낸 사례를 소개합니다. 필수 열 12개만 남기자 파일 크기가 2.1 GB에서 380 MB로 줄었습니다. 해당 열을 Parquet으로 내보내면 58 MB까지 줄었습니다. 보고된 100 Mbps 업로드 시간은 3.5분에서 6초로 감소했습니다.
CaseId, Activity, Timestamp와 상태, 금액, 범주, 지역 등 분석에 필요한 업무 속성을 포함해 분석에 사용할 필드만 유지합니다. 분석에 필요하지 않은 개인정보는 제거합니다.
더 큰 데이터셋은 언제 사용해야 하나요?
질문이 데이터 범위나 기간에 따라 달라진다면 이벤트 수를 늘려야 할 수 있습니다.
- 희귀 이벤트: 100,000건 중 한 번 발생하는 예외를 찾으려면 해당 예외가 포함될 만큼 충분한 데이터를 확보해야 합니다. 예외가 0.01%의 빈도로 발생하고 50건을 분석하려면 약 500K건의 사례가 필요합니다.
- 발생 빈도가 낮은 변형: 0.1%의 빈도로 발생하는 변형은 이벤트 1M건 표본에서는 드러나지 않을 수 있지만, 50M건 전체 데이터에서는 명확히 측정할 수 있습니다.
- 규정 준수 및 감사: 일부 요구사항은 표본 추출이 아니라 전체 데이터 범위의 확인을 요구합니다.
- 장기 추세: 2024년 1분기, 2025년 1분기, 2026년 1분기를 비교하려면 세 기간의 데이터가 모두 필요합니다. 델타 로딩을 사용하면 데이터를 조금씩 추가해 비교 범위를 확보할 수 있습니다.
이벤트가 50M건을 넘는 데이터셋에서는 벤치마크 결과에 따라 Parquet을 사용하고 API로 업로드하는 것이 좋습니다. 가능하다면 빠른 네트워크 연결도 활용하세요. 테스트에서 이벤트 50M건이 담긴 CSV 파일은 11.1 GB였고, Parquet 파일은 1.7 GB였습니다.
성능을 높일 때는 데이터 규모와 속도에 따른 비용도 함께 고려해야 합니다. 중요한 것은 도구의 한계가 아니라 프로세스에 필요한 데이터 규모입니다. ProcessMind는 대규모 데이터도 처리할 수 있지만, 지나치게 큰 데이터셋은 대개 필요하지 않고 복잡성만 더해 개선 과제에 집중하기 어렵게 만들 수 있습니다.
모델과 인터페이스의 응답 속도를 유지하려면 어떻게 해야 할까요?
데이터 규모만이 전부는 아닙니다. 프로세스 모델과 대시보드의 구성도 작업 속도에 영향을 줍니다.
- 모델을 읽기 쉽게 구성합니다: 규모가 큰 프로세스는 모듈형 Subprocess로 나눕니다. 화면에 표시되는 요소가 많으면 렌더링이 느려지고 탐색하기도 어려워질 수 있습니다. 구조를 변경한 뒤에는 자동 레이아웃을 사용하세요.
- 대시보드 구성요소를 신중히 선택합니다: 차트와 타일마다 계산이 필요합니다. 현재 궁금한 점에 답하는 화면만 유지하세요.
- 데이터에 맞는 차트를 사용합니다: 대규모 데이터셋에서는 범주가 많은 시각화의 계산에 시간이 더 걸릴 수 있습니다. 세부 분석이 필요하지 않다면 요약 정보를 사용하세요.
- 필터는 분석 질문에 맞게 설정합니다: 필터를 사용하면 분석 범위를 좁힐 수 있습니다. 답을 찾는 데 필요하지 않은 필터를 함께 적용하지 마세요.
- 애니메이션 설정을 조정합니다: 활성 사례가 많을수록 애니메이션 처리 비용이 늘어납니다. 흐름만 확인하면 된다면 속도를 낮추거나 꼬리 효과와 기타 효과를 끄세요. 자세한 내용은 프로세스 애니메이션을 참고하세요.
- 변경된 부분만 다시 계산합니다: 모델을 변경하면 전체 전처리를 다시 수행하지 않고 모델에 종속된 계산 결과를 갱신합니다. 벤치마크에서는 이벤트 1M건의 변경 사항을 반영하는 데 약 14초, 100M건에서는 52초가 걸렸습니다.
델타 로딩으로 업로드 시간을 줄이는 방법은 무엇일까요?
델타 로딩을 사용하면 전체 데이터셋을 다시 업로드하지 않고 기존 데이터셋에 새 이벤트를 추가할 수 있습니다. 계속 늘어나는 이벤트 로그를 갱신할 때 전송할 데이터 양을 줄여 줍니다.
| 시나리오 | 전체 재업로드 | 델타 업로드 | 절약 시간 |
|---|---|---|---|
| 기존 10M건 + 신규 500K건 (100 Mbps) | 업로드 4분 | 업로드 5초 | 약 4분 |
| 기존 20M건 + 신규 2M건 (100 Mbps) | 업로드 7분 | 업로드 44초 | 약 6분 |
| 기존 50M건 + 신규 5M건 (100 Mbps) | 업로드 18분 | 업로드 2분 | 약 16분 |
델타 업로드 후에는 결합된 데이터셋을 다시 전처리합니다. 벤치마크에서는 1~2.5분이 걸렸습니다. 업로드 시간을 절약하는 이유는 새 이벤트만 전송하기 때문입니다.
델타 파일은 최초 업로드 파일과 형식 및 열 구조가 같아야 합니다. 자세한 내용은 증분 데이터 로딩 안내를 참고하세요.
API 업로드는 언제 사용해야 할까요?
정기적으로 업로드하거나 파일 크기가 수 GB에 달한다면 브라우저보다 API 업로드를 관리하기 쉬울 수 있습니다. 스크립트나 명령줄 도구를 ETL 파이프라인에 연결하고, 예약 업로드를 설정하며, 전송 진행 상황을 확인할 수 있습니다.
ProcessMind는 클라우드 스토리지에 직접 업로드할 수 있도록 사전 서명된 URL을 제공합니다. ProcessMind UI의 데이터셋 설정 메뉴에서 업로드 URL을 복사할 수 있습니다.
# Upload a Parquet file directly using a presigned URL
curl -X PUT "$PRESIGNED_URL" --upload-file data.parquet
사전 서명된 URL을 가져오는 방법과 델타 파일 업로드 방법을 포함한 Bash, JavaScript, Python 예제는 API 문서에서 확인하세요.
데이터셋은 언제 분할해야 할까요?
특정 분석에 데이터 일부만 필요하거나 서로 다른 그룹을 따로 비교해야 한다면 데이터셋을 분할하세요. 지역, 부서, 제품군, 기간 또는 사례 유형을 기준으로 나눈 뒤 각 데이터셋을 개별적으로 분석할 수 있습니다.
그룹 간 비교나 전체 프로세스 추적이 필요하다면 데이터를 한데 유지하세요. 분할하기 전에 사례의 의미가 달라지거나 흐름을 이해하는 데 필요한 이벤트가 빠지지 않는지 확인해야 합니다. 예를 들어 기간별로 나눌 때는 한 기간에 시작해 다른 기간에 끝나는 사례를 고려하세요.
실제 데이터로 성능을 테스트하세요
벤치마크는 계획을 세우는 데 도움이 되지만, 모든 이벤트 로그와 네트워크, 쿼리에서의 결과를 예측하지는 못합니다. 실제로 사용할 데이터셋으로 테스트한 다음 업로드 시간과 전처리 시간, 중요한 대시보드 화면의 응답 시간을 확인하세요.
이벤트 로그를 분석에 맞게 구성하는 방법이 궁금하다면 먼저 데이터 준비 안내를 읽어보세요. 프로세스 분석 방법과 프로세스 지속 모니터링 방법도 확인할 수 있습니다.
실제 데이터 규모로 테스트
분석할 이벤트 로그를 불러와 실제 데이터에서 성능을 측정합니다.