เครื่องมือ ETL สำหรับ process mining: สิ่งที่คุณต้องมี
เมื่อ process mining ต้องใช้ ETL ข้อมูลที่ดึงออกมาต้องมีอะไรบ้าง และทำไม ProcessMind จึงโหลดข้อมูลที่ไปป์ไลน์เดิมของคุณสร้างขึ้นได้.

ต้องใช้ ETL กับ process mining หรือไม่?
เครื่องมือ ETL ดึงข้อมูลจากระบบต้นทาง ปรับรูปแบบให้นำไปใช้ได้ แล้วโหลดข้อมูลเพื่อวิเคราะห์ บทความนี้อธิบายว่างาน ETL แบบใดจำเป็นจริงสำหรับโครงการ process mining และกรณีใดที่ไม่ต้องทำ นี่ไม่ใช่คู่มือเลือก pipeline หากระบบใดระบบหนึ่งส่งออกข้อมูลได้ และไฟล์มีรหัสเคส กิจกรรม และเวลา คุณมักข้ามการทำ pipeline ในการวิเคราะห์ครั้งแรก แล้วโหลดไฟล์ส่งออกได้เลย
คำตอบขึ้นอยู่กับกระบวนการ ระบบที่เกี่ยวข้อง และความถี่ที่ต้องอัปเดตผลวิเคราะห์ เริ่มจากดึงข้อมูลให้น้อยที่สุดเท่าที่จะตอบคำถามได้ แล้วค่อยเพิ่มการเตรียมข้อมูลและระบบอัตโนมัติเมื่อผลวิเคราะห์ครั้งแรกแสดงว่าจำเป็น
มี 3 กรณีที่ควรทำ ETL:
- กระบวนการเกี่ยวข้องกับหลายระบบ ต้องรวมข้อมูลและปรับรหัสอ้างอิงให้ตรงกัน จึงจะติดตามเคสเดียวกันได้ตั้งแต่ต้นจนจบ
- ข้อมูลต้นทางยังนำไปใช้ไม่ได้ ต้องปรับชื่อกิจกรรม เวลา หรือรหัสเคสให้เป็นมาตรฐานก่อนนำไปวิเคราะห์
- ต้องดึงข้อมูลซ้ำตามกำหนด หากข้อมูลเปลี่ยนทุกวันและต้องอัปเดตผลวิเคราะห์ตาม การส่งออกด้วยมือก็ไม่สะดวกอีกต่อไป
เหตุผลเหล่านี้บอกว่าควรเตรียมข้อมูล ไม่ได้แปลว่าต้องสร้าง pipeline ก่อนตอบคำถามแรก ลองโหลดข้อมูลที่หาได้ ตรวจดูว่ายังขาดอะไร แล้วค่อยตัดสินใจ
ช่วงแรกเราคิดว่า ETL ควรเป็นส่วนหนึ่งของผลิตภัณฑ์ แต่เมื่อดูว่าลูกค้ามีอะไรอยู่แล้ว เราก็เปลี่ยนใจ กระแสคลังข้อมูลดำเนินมาราว 20 ปี ภายใต้ชื่อเรียกหลายแบบ เช่น data mart และ data lake จนปัจจุบันบริษัทส่วนใหญ่มีข้อมูลที่นำไปใช้ได้ เราจึงหยุดสร้าง pipeline ของเราเอง คุณนำไฟล์ส่งออกจากระบบที่ใช้อยู่มาได้เลย หรือเชื่อม pipeline ที่ทีมดูแลอยู่เข้ากับ API ของเรา แล้วเริ่มจากข้อมูลที่มี
คุณอาจไม่ต้องมี pipeline แยก หาก:
- กระบวนการส่วนใหญ่บันทึกอยู่ในระบบเดียว
- ส่งออกข้อมูลที่เกี่ยวข้องได้
- ไฟล์มีรหัสเคส กิจกรรม และเวลา
- ไฟล์มีขนาดเล็กพอที่จะเตรียมด้วยมือ
- คุณกำลังทดสอบว่าข้อมูลตอบคำถามได้หรือไม่
คุณใช้สเปรดชีตเปลี่ยนชื่อคอลัมน์ แก้ความไม่สอดคล้องที่เห็นได้ชัด และลบฟิลด์ที่ไม่ต้องใช้ออกได้ การเตรียมข้อมูลด้วยมือไม่จำเป็นต้องทำไปตลอด เมื่อผลวิเคราะห์แสดงว่ามีประโยชน์และต้องอัปเดตข้อมูลบ่อย ให้ทำขั้นตอนที่ต้องทำซ้ำให้เป็นอัตโนมัติ
ไฟล์ส่งออกต้องมีข้อมูลอะไรบ้าง
บันทึกเหตุการณ์สำหรับ process mining ต้องมี 3 ฟิลด์ และมีข้อมูลหนึ่งแถวต่อหนึ่งเหตุการณ์.
| ฟิลด์ | ใช้แทนข้อมูลอะไร | สิ่งที่ควรตรวจสอบ |
|---|---|---|
| รหัสเคส | หนึ่งหน่วยของกระบวนการ เช่น คำสั่งซื้อหรือคำขอบริการ | รหัสเคสเดียวกันต้องเชื่อมเหตุการณ์ทั้งหมดของหน่วยนั้นเข้าด้วยกัน |
| กิจกรรม | ขั้นตอนหนึ่งที่เกิดขึ้นในกระบวนการ | ใช้ชื่อที่แยกขั้นตอนจริงออกจากกัน และใช้ให้สม่ำเสมอ |
| เวลา | เวลาที่เกิดขั้นตอน | เป็นวันและเวลาจริง และใช้เขตเวลาเดียวกันในแหล่งข้อมูลที่นำมารวมกัน |
ข้อมูลประกอบ เช่น ต้นทุน ผู้ใช้ ทีม กลุ่มลูกค้า หรือปริมาณ CO₂ เป็นฟิลด์เสริม แต่ข้อมูลเหล่านี้ทำให้คุณวิเคราะห์กระบวนการได้มากกว่าแค่ดูภาพรวม ทุกฟิลด์ที่เก็บไว้จะกลายเป็นตัวกรอง ตัวแบ่งกลุ่ม หรือค่าที่ใช้วัดผลได้ในภายหลัง ดูรายละเอียดของแต่ละฟิลด์ได้ที่คู่มือฟิลด์ในชุดข้อมูล.
แม้ฟิลด์จะมีอยู่ในระบบต้นทาง ก็ไม่ได้หมายความว่าจะนำไปใช้ได้เสมอไป รหัสเคสที่เปลี่ยนไปมาระหว่างระบบจะเชื่อมเหตุการณ์ไม่ได้ ชื่อกิจกรรมที่ไม่สม่ำเสมอทำให้ขั้นตอนเดียวกันกลายเป็นสามขั้นตอน ส่วนเวลาที่จัดเก็บเป็นข้อความอาจทำให้เรียงเหตุการณ์ผิด ตรวจไฟล์ส่งออกก่อนทำแผนที่ และตรวจฟิลด์จำเป็นทั้ง 3 ฟิลด์ก่อน หากต้องการดูภาพรวมว่าบันทึกเหตุการณ์ควรมีอะไรบ้าง อ่านข้อมูลที่ process mining ต้องใช้.
ตัวอย่าง query สำหรับบันทึกเหตุการณ์ขั้นต่ำ
หากระบบต้นทางบันทึกข้อมูลหนึ่งแถวต่อกิจกรรมอยู่แล้ว ก็ใช้ query แบบ select ได้ ตัวอย่างนี้สมมติว่ามีตารางชื่อ process_events ซึ่งมีเคส กิจกรรม และเวลาเกิดเหตุการณ์:
SELECT
  case_id        AS case_id,
  activity_name  AS activity,
  event_time     AS timestamp
FROM process_events
WHERE case_id IS NOT NULL
  AND activity_name IS NOT NULL
  AND event_time IS NOT NULL
ORDER BY case_id, event_time;
query ตั้งชื่อให้ทั้งสามฟิลด์ ตัดแถวที่ใช้ไม่ได้ออก และเรียงเหตุการณ์ภายในแต่ละเคส ปรับชื่อตารางและคอลัมน์ให้ตรงกับระบบต้นทาง แล้วตรวจตัวอย่างเคสก่อนโหลด แต่ละเคสควรมีเหตุการณ์ตามที่คาดไว้ และเรียงลำดับที่คนทำงานเข้าใจได้
ขั้นตอนการแปลงข้อมูลที่ควรทำ
การแปลงข้อมูลควรแก้จุดที่อาจทำให้ผลวิเคราะห์คลาดเคลื่อน โดยทั่วไปมี 4 ขั้นตอนหลัก.
-
ปรับรูปแบบเหตุการณ์ให้เป็นมาตรฐาน
แยกแต่ละกิจกรรมที่เกิดขึ้นให้อยู่คนละแถว พร้อมรหัสเคสและเวลา แม้ระบบต้นทางจะเก็บขั้นตอนของกระบวนการไว้คนละคอลัมน์ก็ตาม\n -
จัดรูปแบบเวลาให้นำไปใช้ได้
ตรวจว่าค่าเป็นวันและเวลาจริง และระบุว่าเป็นเวลาท้องถิ่นหรือ UTC ปรับเขตเวลาของแหล่งข้อมูลที่นำมารวมกันให้ตรงกัน มิฉะนั้นลำดับเหตุการณ์จะคลาดเคลื่อน\n -
ใช้ชื่อกิจกรรมให้เป็นมาตรฐาน
ใช้ชื่อเดียวกันสำหรับแต่ละขั้นตอนจริง เลือกภาษาเดียวและสะกดให้ตรงกัน อย่ารวมขั้นตอนที่ดูคล้ายกันเพียงเพื่อลดจำนวนรายการ\n -
รวมแหล่งข้อมูลเมื่อจำเป็นเท่านั้น
หารหัสที่ใช้เชื่อมข้อมูลและตรวจสอบว่าตรงกัน การ join ที่ทำให้เหตุการณ์ซ้ำหรือเคสหายไปจะเปลี่ยนภาพกระบวนการ ให้เปรียบเทียบจำนวนระเบียนก่อนและหลัง
หากไฟล์ส่งออกมีข้อมูลหนึ่งแถวต่อเหตุการณ์ พร้อมทั้งสามฟิลด์อยู่แล้ว ก็ไม่ต้องแปลงข้อมูล นี่เป็นเรื่องปกติ ไม่ใช่การลัดขั้นตอน วิธีสร้างบันทึกเหตุการณ์สำหรับ process miningอธิบายขั้นตอนเดียวกันพร้อมตัวอย่าง Excel และ SQL.
ควรโหลดบันทึกเหตุการณ์ไว้ที่ใด?
โหลดข้อมูลที่เตรียมแล้วไปยังแพลตฟอร์มที่คุณจะใช้วิเคราะห์ สำหรับการตรวจดูครั้งแรก ไฟล์เดียวก็เพียงพอ เตรียมไฟล์ โหลดข้อมูล ดูภาพกระบวนการ แล้วปรับข้อมูลส่งออกเมื่อเห็นแล้วว่าข้อมูลรองรับอะไรได้บ้าง อย่าเพิ่งตั้งระบบจัดเก็บข้อมูลใหม่เพื่อใช้กับ process mining โดยเฉพาะ หากทีมของคุณดูแลคลังข้อมูลหรือ data lake อยู่แล้ว ให้เก็บข้อมูลไว้ที่เดิม แล้วโหลดข้อมูลที่ระบบนั้นสร้างขึ้น
ดูรายละเอียดได้ที่หน้ารูปแบบข้อมูลที่รองรับ และหากไม่ต้องการอัปโหลดด้วยมือ คุณสามารถตั้งงานตามกำหนดเวลาให้ส่งไฟล์รูปแบบเดียวกันผ่านdata APIได้.
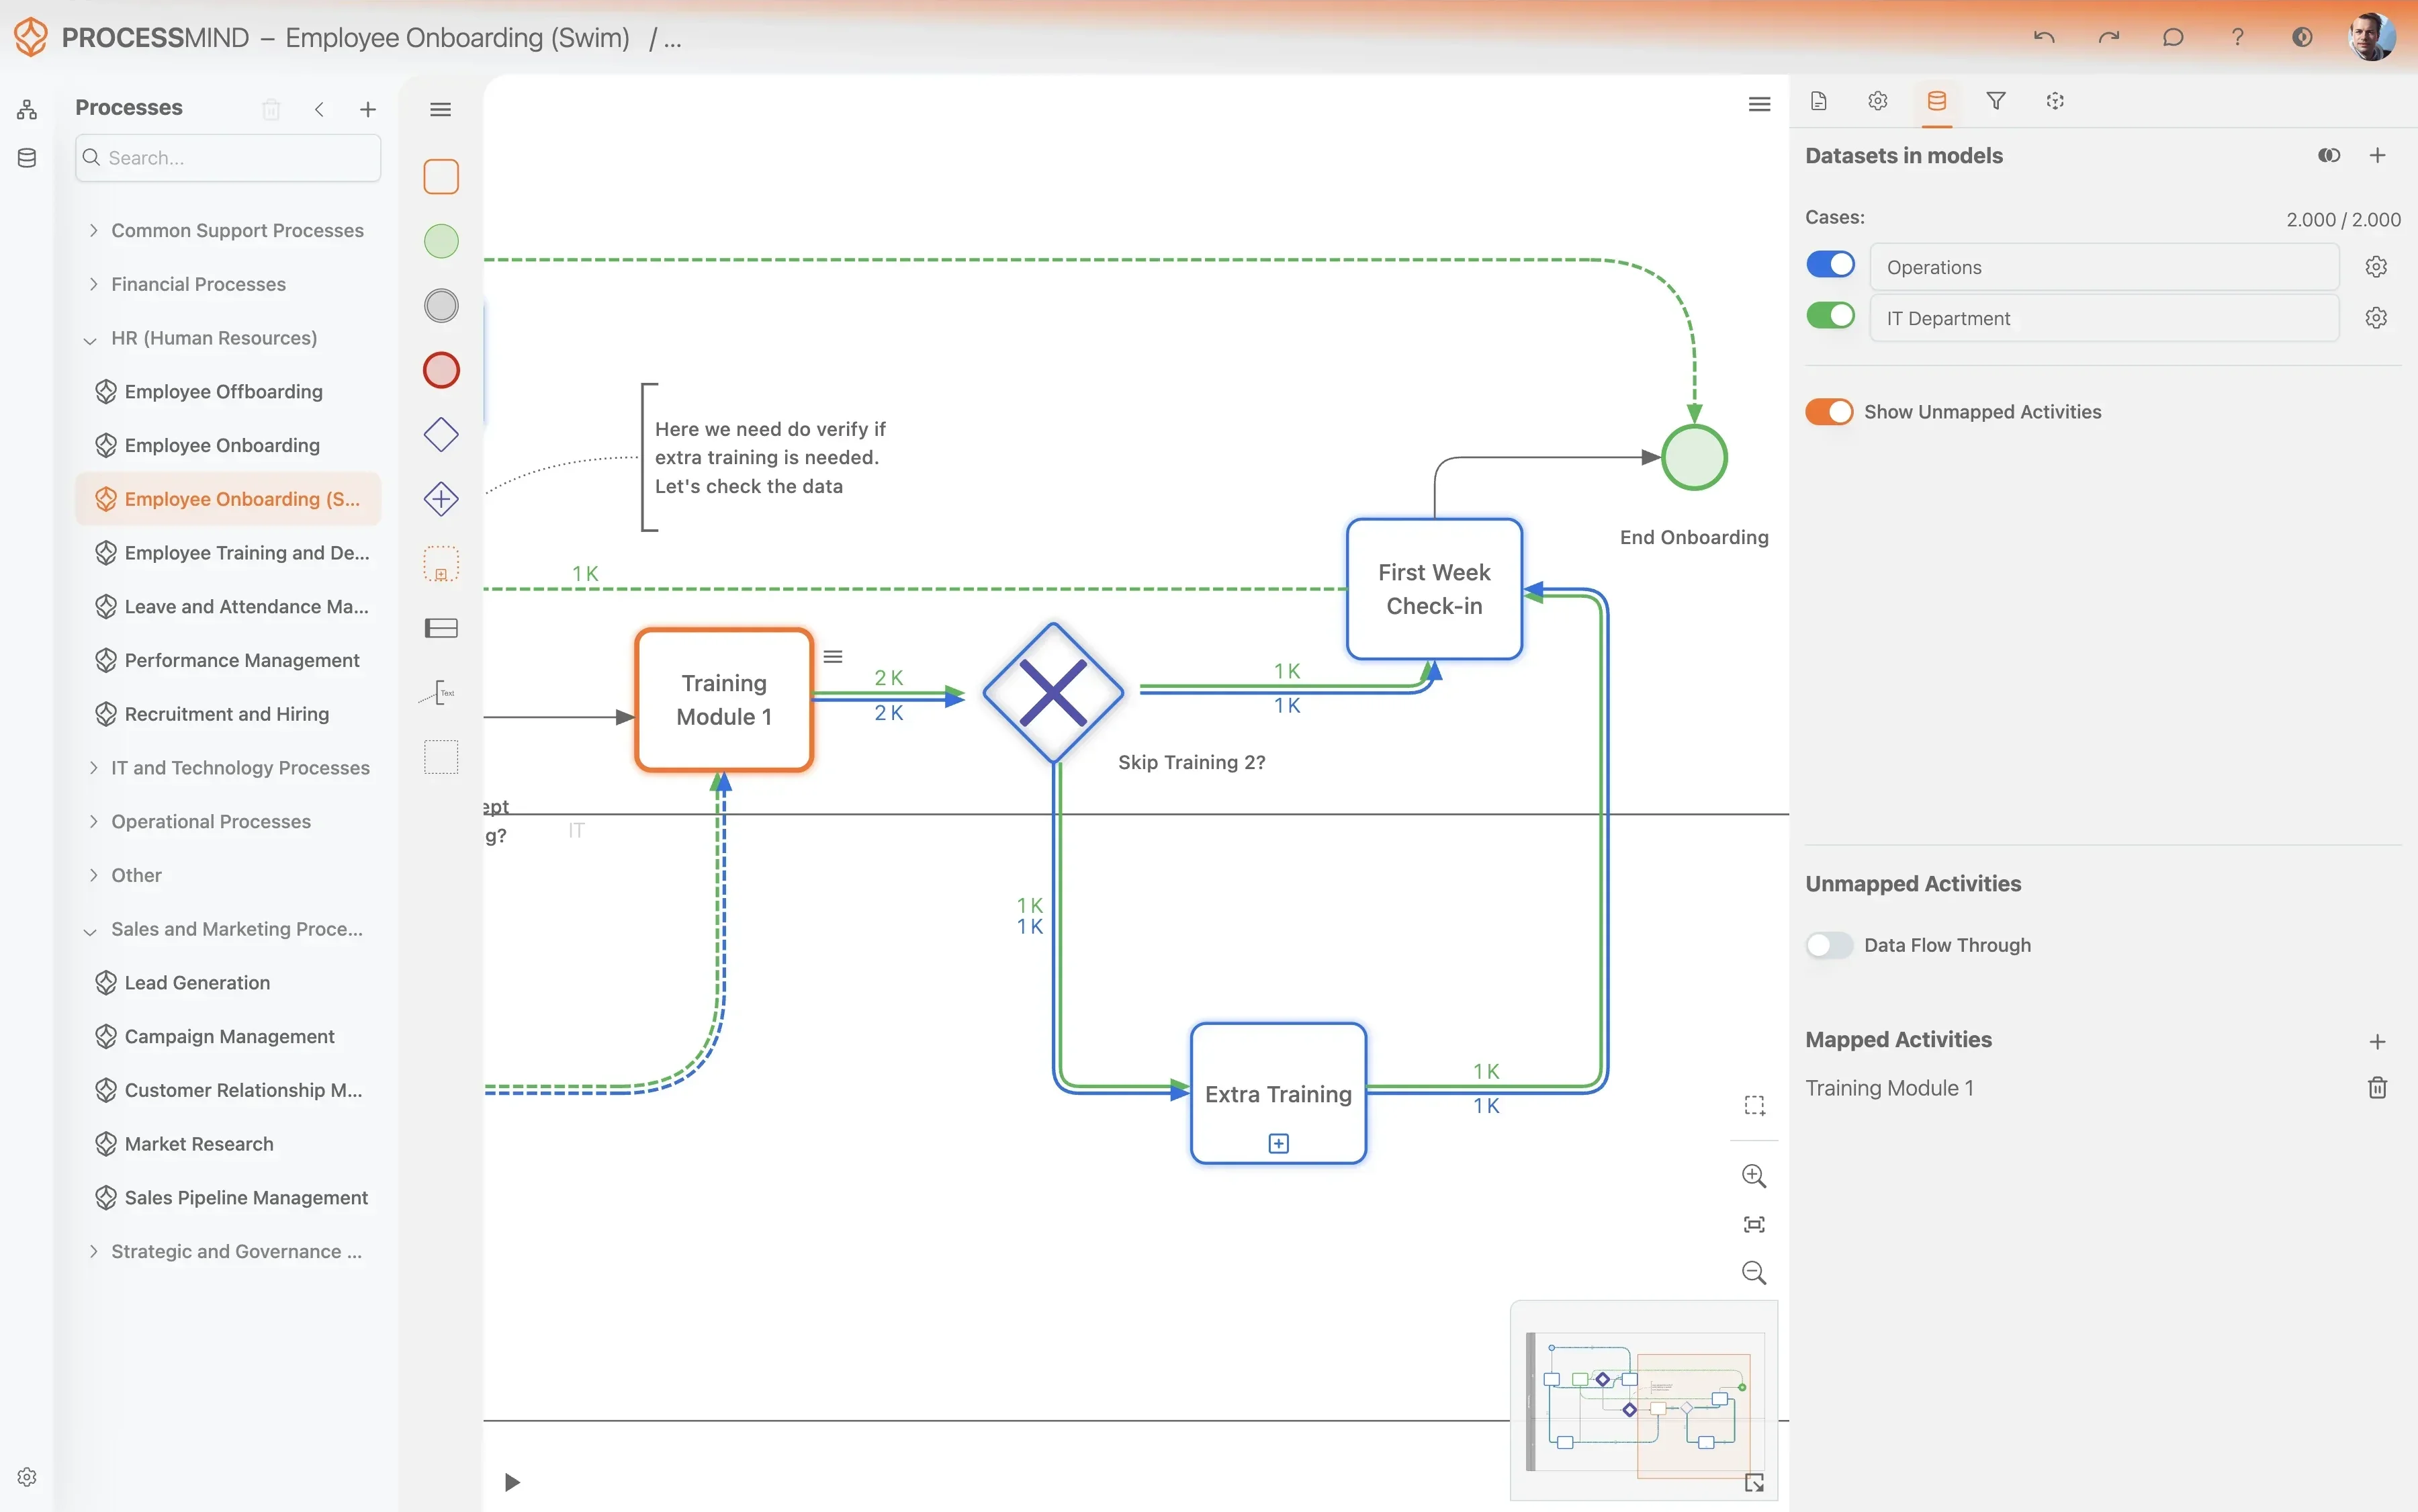
ไม่ว่าคุณจะเลือกวิธีใด ข้อมูลที่โหลดควรอยู่ในจุดที่ใช้วิเคราะห์ ไฟล์ที่วางไว้ในโฟลเดอร์ซึ่งไม่มีใครดูแลไม่ใช่กลยุทธ์ด้านข้อมูล แต่ชุดข้อมูลที่มีคนทำแผนที่และตรวจสอบต่างหากที่ใช่.
เครื่องมือ ETL แบบใดเหมาะกับ process mining?
ไม่มีรายการเครื่องมือ ETL ชุดเดียวที่เหมาะกับทุกโครงการ ให้เลือกจากแหล่งที่เก็บข้อมูล เครื่องมือที่ทีมใช้อยู่ และระดับการเตรียมข้อมูลที่บันทึกเหตุการณ์ต้องการ งานส่วนใหญ่เป็นงานวิศวกรรมข้อมูลทั่วไป ข้อกำหนดเฉพาะสำหรับ process mining มีเพียงผลลัพธ์ต้องเก็บรหัสเคส กิจกรรม และเวลาไว้
| วิธีการ | เหมาะเมื่อ | ข้อแลกเปลี่ยน |
|---|---|---|
| ส่งออกและเตรียมข้อมูลด้วยมือ | คุณกำลังทดสอบกระบวนการเดียวกับชุดข้อมูลขนาดเล็กที่ไม่ค่อยเปลี่ยน | เริ่มได้เร็วที่สุด แต่ต้องทำงานด้วยมือทุกครั้งที่อัปเดตข้อมูล |
| ใช้เครื่องมือที่ทีมมีอยู่แล้ว | ทีมใช้ SQL, dbt, คลังข้อมูล หรือ data lake อยู่แล้ว | ใช้ทักษะและโครงสร้างพื้นฐานเดิม และนำตรรกะไปใช้ซ้ำนอก process mining ได้ |
| ใช้เครื่องมือ ETL จากผู้ให้บริการภายนอก | ต้องดึงข้อมูลจากหลายระบบซ้ำตามกำหนด | มีส่วนประกอบให้ตั้งค่าและดูแลเพิ่มขึ้น |
| ใช้ ETL ในตัวแพลตฟอร์ม process mining | แพลตฟอร์มรองรับการแปลงข้อมูลที่ต้องการ | สะดวก แต่ควรตรวจสอบว่านำตรรกะไปใช้ที่อื่นได้ง่ายเพียงใด และนำข้อมูลไปใช้ซ้ำได้หรือไม่ |
ชื่อเครื่องมือที่มักพบในโครงการ process mining ได้แก่ CData และ dbt สำหรับดึงข้อมูลและแปลงข้อมูลด้วย SQL, BigQuery, Snowflake และ Databricks สำหรับคลังข้อมูล ส่วน Talend, Apache NiFi และ Airbyte เหมาะเมื่อการย้ายข้อมูลระหว่างระบบเป็นงานหลัก เครื่องมือโอเพนซอร์สก็เป็นตัวเลือกที่ใช้ได้ โดยมักเริ่มจาก NiFi และ Airbyte นอกจากนี้ยังมีผู้ให้บริการบางรายที่จำหน่าย ETL สำหรับ process mining โดยเฉพาะ เช่น Evidant และ Konekti พร้อมเทมเพลตสำหรับระบบที่ใช้กันทั่วไป
ตัวอย่างเหล่านี้ไม่ได้เป็นการรับรองผลิตภัณฑ์ และไม่มีรายใดเป็นพันธมิตรของเรา เลือกเครื่องมือและรูปแบบไฟล์ที่ทีมดูแลต่อได้หลังจบโครงการ และหากทำได้ ให้เก็บตรรกะการแปลงข้อมูลไว้นอกผลิตภัณฑ์ process mining ควรพิจารณา ETL ในตัวให้รอบคอบ เพราะสะดวกเมื่อยังใช้แพลตฟอร์มนั้น แต่ทำให้การเตรียมข้อมูลอยู่ในจุดที่นำไปใช้ซ้ำกับโครงการวิเคราะห์หรือ AI ครั้งต่อไปได้ยากขึ้น
จัดการข้อมูลอย่างไรหลังโหลดแล้ว?
การดึงข้อมูลเป็นเพียงครึ่งหนึ่งของงาน วิธีจัดการชุดข้อมูลหลังจากนั้นเป็นตัวกำหนดว่าผลวิเคราะห์จะยังใช้ได้หรือไม่เมื่อเวลาผ่านไปหนึ่งไตรมาส.
- ตั้งชื่อชุดข้อมูลให้สื่อถึงเนื้อหา ชื่อ
Q1_2025_Sales_DataหรือCustomer_Support_Logsเข้าใจง่ายกว่าexport_final_v3 - เลือกรูปแบบไฟล์ให้เหมาะกับงาน ไฟล์ CSV หรือ Excel เหมาะกับไฟล์ขนาดเล็กที่อัปโหลดด้วยมือ ส่วน Parquet หรือ ORC เหมาะกับชุดข้อมูลขนาดใหญ่และไฟล์ที่ pipeline สร้างขึ้น
- ดูตัวอย่างก่อนจับคู่ข้อมูล ตรวจโครงสร้าง ชนิดข้อมูลของคอลัมน์ และข้อมูลสักสองสามแถว จากนั้นยืนยันรหัสเคส กิจกรรม และเวลาในการตั้งค่าชุดข้อมูล
- ตรวจการจับคู่กิจกรรม ให้ระบบจับคู่อัตโนมัติในรอบแรก แล้วตรวจกิจกรรมที่ยังไม่ได้จับคู่ ขั้นตอนที่เกิดขึ้นแต่ไม่มีร่องรอยในข้อมูล สามารถกำหนดเป็นdata flow through เพื่อให้ยังมองเห็นขั้นตอนนั้นโดยไม่เปลี่ยนตัวเลข
- อัปเดตข้อมูล ไม่ต้องสร้างใหม่ หากส่งออกข้อมูลเป็นประจำ ให้นำไฟล์ใหม่มาแทนชุดข้อมูลตามความถี่ที่การวิเคราะห์ต้องใช้จริง เช่น รายวันหรือรายสัปดาห์ และใช้การจับคู่เดิม
- บันทึกข้อจำกัดของข้อมูล ระบุช่วงเวลา ระบบ และขั้นตอนที่ขาดไว้ในบันทึกการวิเคราะห์ เพราะข้อมูลเหล่านี้มีผลต่อข้อสรุปที่คุณจะรายงาน
- กำหนดสิทธิ์เข้าถึง แล้วเก็บถาวร ให้สิทธิ์เข้าถึงชุดข้อมูลแก่ผู้ที่จำเป็นต้องใช้ และเก็บถาวรข้อมูลของโครงการที่เสร็จแล้วและไม่ได้ใช้อีกต่อไป
สรุปประเด็นสำคัญ
ETL เป็นเครื่องมือ ไม่ใช่เป้าหมายของโครงการ process mining วางแผนให้ ETL ไม่ทำให้การวิเคราะห์ครั้งแรกล่าช้า:
- เริ่มจากข้อมูลที่คุณหาได้ภายในสัปดาห์นี้
- เก็บฟิลด์ที่จำเป็นทั้งสามไว้ ไม่ว่าจะตัดข้อมูลส่วนอื่นออกหรือไม่
- โหลดไฟล์ส่งออกก่อน แล้วค่อยทำให้ขั้นตอนนี้เป็นอัตโนมัติเมื่อผลวิเคราะห์แสดงว่าคุ้มค่า
- เลือกใช้เครื่องมือและรูปแบบไฟล์ที่ทีมดูแลอยู่แล้ว.
โครงการจำนวนมากล้มเหลวเพราะสร้าง pipeline ก่อนรู้ว่าต้องตอบคำถามอะไร มากกว่าจะล้มเหลวเพราะ pipeline เรียบง่ายเกินไป.
Where to Go From Here
คุณมีไฟล์ส่งออก หรือมี pipeline ที่สร้างไฟล์ให้ได้แล้ว ขั้นต่อไปคือโหลดข้อมูลและตรวจว่าไฟล์ที่ดึงมาตอบคำถามของคุณได้หรือไม่.