如何构建流程挖掘事件日志
了解如何构建流程挖掘事件日志:掌握必备列,下载餐厅示例,并按步骤使用Excel和SQL创建日志。
流程挖掘事件日志从一张表开始:每条活动都带有时间戳,并按案例ID归组。本指南以虚构的餐厅订单流程为例,说明如何从系统数据构建事件日志。您可以选择两种方法:在Excel中整理几行数据,或运行一条SQL查询,通过UNION ALL合并活动。操作时,可随时对照完整示例日志。
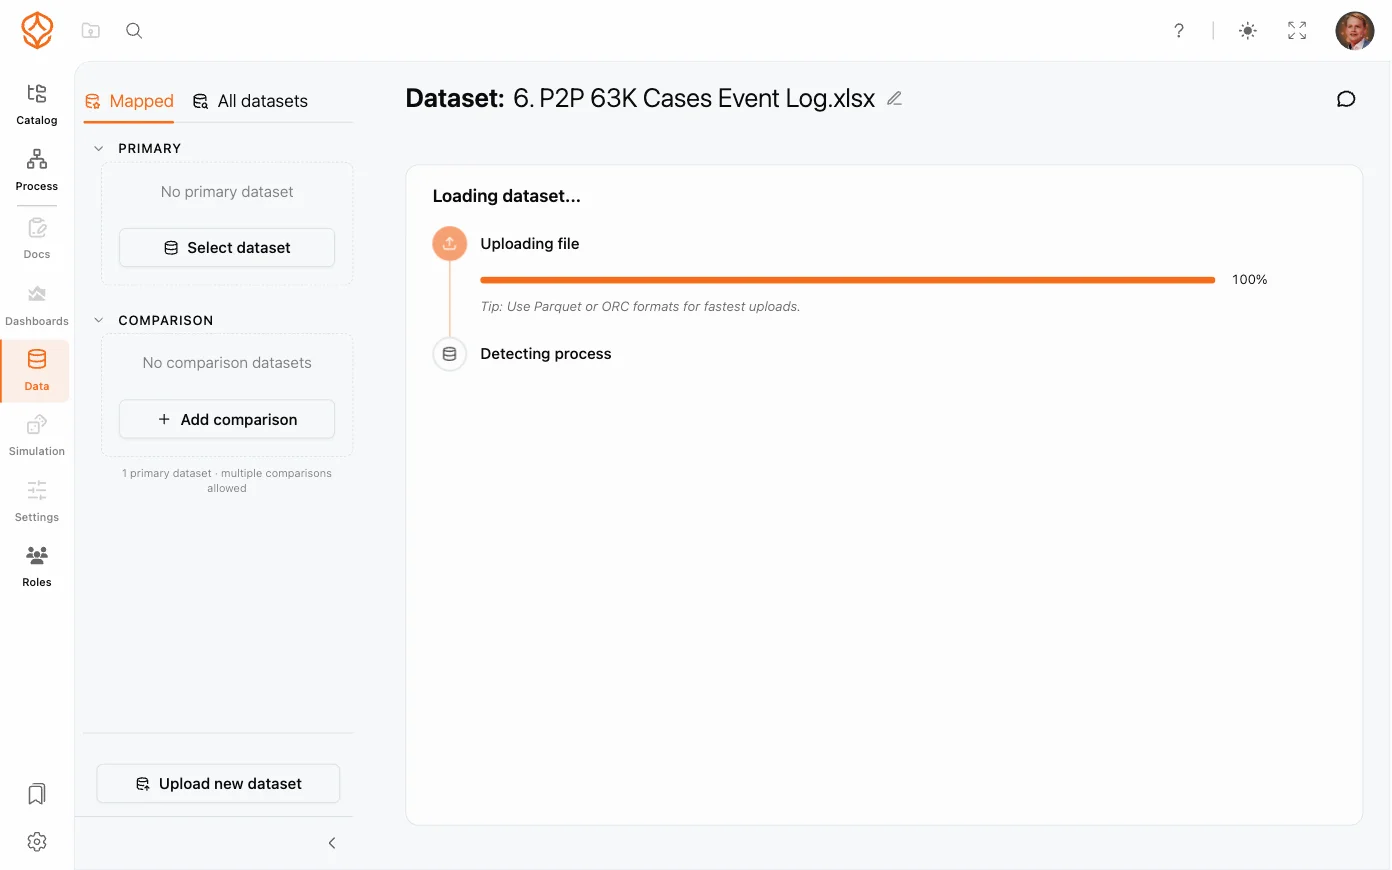
创建事件日志常被认为是一项艰巨的任务。其实,只要不试图一次完成所有工作,就没那么难。您可以从模板或Excel中的几行数据开始,了解需求后再逐步扩展。
流程挖掘事件日志:必需的三列
事件日志是对流程中已发生事项的结构化记录。每一行代表一个事件,例如下单或收到付款。案例ID用于关联相关事件,时间戳标明事件发生的时间。借助这些信息,工具可以还原案例在流程中的流转情况。
**活动是一种类型,事件则是一次具体发生。**活动是一类操作,例如“订单已发货”。事件则是这类操作的一次具体发生:订单12345于1月15日下午2:30发货。日志记录的是事件,每个事件都带有活动名称。人们常把这两个词混用,但准备数据时必须区分:活动说明发生了什么,事件则说明这件事何时发生在当前案例中。
基础流程挖掘事件日志需要三列:
| 列 | 内容 | 示例 |
|---|---|---|
| 案例ID | 用于归并同一案例相关事件的标识符 | 1001 |
| 时间戳 | 事件发生的时间 | 2025-01-15 18:30:00 |
| 活动 | 发生的事项 | Order Placed |
继续之前,请检查这三个字段:
| 检查项 | 确认内容 |
|---|---|
| 案例ID | 相关事件使用相同ID,不同案例使用不同ID |
| 时间戳 | 每个事件都有可用的日期和时间 |
| 活动 | 提取数据中的名称清晰且一致 |
这三个字段是基础,任何一个缺失或不一致,流程视图都可能错误呈现工作顺序。其他字段均为可选项:流程挖掘工具读取的业务流程事件日志始终是一张包含案例和事件的表,而可用的业务流程挖掘事件日志所需的三列始终不变。支持的格式和准备步骤,请参阅流程挖掘数据文档。
示例:Pizza Palace订单系统
为便于说明,我们以一家虚构餐厅Pizza Palace为例。顾客在线下单,员工准备餐食,司机负责配送。示例不包含任何顾客数据。
假设系统将信息存储在以下数据表中:
- orders:订单ID、顾客和下单时间
- order_items:每笔订单中的披萨、配菜和饮料
- kitchen_queue:订单进入和离开厨房的时间
- delivery_assignments:司机分配和配送跟踪信息
- payments:付款处理记录
目标是创建一份事件日志,跟踪每笔订单从下单到送达的全过程。订单ID将作为案例ID,每个相关时间戳和操作都将成为一行。下载Pizza Palace示例日志,将其用作流程挖掘事件日志样例,并将其中的列与您自己的数据进行对照。
**提取数据前,先确定要纳入哪些活动。**在Pizza Palace的订单流程中,共有六个步骤:
- 已下单:顾客提交订单。
- 已收到付款:付款处理成功。
- 订单已送至厨房:订单进入备餐队列。
- 订单已备好:厨房将订单标记为完成。
- 已分配司机:系统为订单分配司机。
- 配送已完成:订单已送达。
针对每项活动,确定其源数据表、时间戳字段和案例ID字段。确认案例ID能将事件关联到正确的订单。
| 活动 | 源数据表 | 时间戳字段 | 案例ID字段 |
|---|---|---|---|
| 已下单 | orders | created_at | id |
| 已收到付款 | payments | payment_time | order_id |
| 订单已送至厨房 | kitchen_queue | queue_entry_time | order_id |
| 订单已备好 | kitchen_queue | completed_time | order_id |
| 已分配司机 | delivery_assignments | assigned_at | order_id |
| 配送已完成 | delivery_assignments | delivered_at | order_id |
**区分直接记录的事件和推断出的事件。**直接记录的事件在源系统中有明确记录和时间戳:已下单取自orders行的时间戳,已收到付款取自payments,配送已完成取自delivery_assignments。只要时间戳代表您要分析的事件,通常就能直接提取。
推断出的事件没有独立记录,因此需要根据其他字段推断其发生时间。已分配司机可能只有配送分配记录的创建时间,订单已备好则可能只能根据厨房队列状态变为“completed”的时间来确定。推断出的事件可能有用,但请记录推断方法:状态变更或记录创建时间未必与活动名称所表达的含义完全一致。在将字段用作事件时间戳之前,请向熟悉源系统的人员确认其含义。
这份映射只是计划,并不能证明每个字段都适用。请检查时间戳是否有值,以及每张表能否通过订单ID关联而不产生重复行。
案例和事件属性
属性可为分析补充背景信息。它们是案例ID、时间戳和活动以外的列,只有在含义明确且能关联到正确案例或事件时,才值得添加。
案例属性描述整个案例,通常在案例的各个事件中保持不变,例如顾客姓名、订单总金额、配送地址和订购商品数量。在扁平化事件日志中,同一案例的每一行都会重复这些值,之后您便可以根据案例级信息筛选或比较事件。
事件属性描述单个事件,例如配送事件中的司机、付款事件中的付款方式、厨房事件中的工作站。这类列并不适用于每一行,因此不适用时请留空,但仍应保留该列,以确保每行结构一致。
最终的事件日志应是一张扁平表,每行对应一个事件。以下是Pizza Palace的日志:
| 案例ID | 时间戳 | 活动 | 顾客 | 订单金额 | 司机 | 付款方式 |
|---|---|---|---|---|---|---|
| 1001 | 2025-01-15 18:30:00 | 已下单 | John Smith | 45.99 | ||
| 1001 | 2025-01-15 18:30:15 | 已收到付款 | John Smith | 45.99 | 信用卡 | |
| 1001 | 2025-01-15 18:31:00 | 订单已送至厨房 | John Smith | 45.99 | ||
| 1001 | 2025-01-15 18:45:00 | 订单已备好 | John Smith | 45.99 | ||
| 1001 | 2025-01-15 18:46:00 | 已分配司机 | John Smith | 45.99 | Maria Garcia | |
| 1001 | 2025-01-15 19:05:00 | 配送已完成 | John Smith | 45.99 | Maria Garcia | |
| 1002 | 2025-01-15 18:35:00 | 已下单 | Jane Doe | 28.50 | ||
| 1002 | 2025-01-15 18:35:20 | 已收到付款 | Jane Doe | 28.50 | PayPal | |
| … | … | … | … | … | … | … |
同一案例的每个事件都会重复显示顾客和订单金额。这是有意为之:这样日志就能保持为流程挖掘工具可读取的简单表格。
方法一:在Excel中构建
Excel适合处理少量数据或进行初步练习。分别导出各类事件,统一列结构,再将各行合并到同一工作表中。使用Pizza Palace的数据完成以下五个步骤,大约需要一小时。
**步骤1:将各类事件分别导出到单独的工作表。**为每种活动创建一个工作表。例如:
工作表1:已下单
| 案例ID | 时间戳 | 活动 | 顾客 | 订单金额 |
|---|---|---|---|---|
| 1001 | 2025-01-15 18:30:00 | 已下单 | John Smith | 45.99 |
| 1002 | 2025-01-15 18:35:00 | 已下单 | Jane Doe | 28.50 |
工作表2:已收到付款
| 案例ID | 时间戳 | 活动 | 顾客 | 订单金额 | 付款方式 |
|---|---|---|---|---|---|
| 1001 | 2025-01-15 18:30:15 | 已收到付款 | John Smith | 45.99 | 信用卡 |
| 1002 | 2025-01-15 18:35:20 | 已收到付款 | Jane Doe | 28.50 | PayPal |
按照相同方法,为厨房和配送事件创建其他工作表。
**步骤2:统一列结构。**所有工作表使用相同的列名和顺序;某项属性不适用时,也要添加空列。例如,已下单工作表可以包含完整的列:
| 案例ID | 时间戳 | 活动 | 顾客 | 订单金额 | 司机 | 付款方式 |
|---|---|---|---|---|---|---|
| 1001 | 2025-01-15 18:30:00 | 已下单 | John Smith | 45.99 |
检查各列值的格式是否兼容。尤其要确认时间戳存储为日期和时间,而不是仅看起来像时间戳的文本。
步骤3:合并工作表。新建名为事件日志的工作表,将各活动工作表中的事件行复制到其中。保留一行表头,并确保每行对应一个事件。
**步骤4:按案例和时间戳排序。**先按案例ID升序,再按时间戳升序排列合并后的数据。这样更便于检查每个案例的事件顺序。排序无法修正错误的时间戳,因此在依赖事件顺序之前,请检查时间相同或不符合预期的事件。
**步骤5:导出为CSV。**将合并后的工作表保存为流程挖掘工具可读取的事件日志CSV文件,并打开导出文件检查表头、分隔符、日期格式和空值是否符合预期。
Excel使用提示:
- 使用VLOOKUP或XLOOKUP从orders工作表添加顾客姓名等案例属性。
- 统一使用一种日期和时间格式,例如
YYYY-MM-DD HH:MM:SS。 - 导出前检查是否有重复行。
- 保留原始提取数据的未修改副本,以便追溯任何更正。
方法二:使用SQL构建
如果数据存储在数据库中、数据量较大,或您需要下个月再次执行相同的提取,使用SQL会更合适。通常,每项活动使用一个SELECT,再通过UNION ALL将结果合并。
**UNION ALL的作用。**它会合并多个SELECT语句返回的行。每条语句都必须返回相同数量、顺序一致且数据类型兼容的列,并使用一致的别名,以便最终列名清晰明确。
**查询语句。**以下示例使用虚构的Pizza Palace数据表。修改前,请检查您自己的表名、字段名、时间戳含义和SQL方言。
-- Event Log Extraction for Pizza Palace
-- This query combines multiple event types into a single event log
-- Each SELECT block represents one activity type

-- Event 1: Order Placed
-- Source: orders table
-- This captures when customers submit their orders
SELECT
    o.id AS case_id,                          -- The order ID is our case identifier
    o.created_at AS timestamp,                -- When the order was placed
    'Order Placed' AS activity,               -- The activity name (hardcoded)
    o.customer_name AS customer,              -- Case attribute: who ordered
    o.total_amount AS order_value,            -- Case attribute: order value
    NULL AS driver,                           -- Not applicable for this event
    NULL AS payment_method                    -- Not applicable for this event
FROM orders o
WHERE o.created_at >= '2025-01-01'            -- Filter to your desired date range

UNION ALL

-- Event 2: Payment Received
-- Source: payments table
-- This captures successful payment processing
SELECT
    p.order_id AS case_id,
    p.payment_time AS timestamp,
    'Payment Received' AS activity,
    o.customer_name AS customer,              -- Join to get case attributes
    o.total_amount AS order_value,
    NULL AS driver,
    p.payment_method AS payment_method        -- Event-specific attribute
FROM payments p
JOIN orders o ON p.order_id = o.id            -- Join to get order details
WHERE p.payment_time >= '2025-01-01'
  AND p.status = 'successful'                 -- Only include successful payments

UNION ALL

-- Event 3: Order Sent to Kitchen
-- Source: kitchen_queue table
-- This captures when the kitchen starts working on the order
SELECT
    k.order_id AS case_id,
    k.queue_entry_time AS timestamp,
    'Order Sent to Kitchen' AS activity,
    o.customer_name AS customer,
    o.total_amount AS order_value,
    NULL AS driver,
    NULL AS payment_method
FROM kitchen_queue k
JOIN orders o ON k.order_id = o.id
WHERE k.queue_entry_time >= '2025-01-01'

UNION ALL

-- Event 4: Order Ready
-- Source: kitchen_queue table (different timestamp field)
-- This is an inferred event based on when the kitchen marked it complete
SELECT
    k.order_id AS case_id,
    k.completed_time AS timestamp,            -- Different timestamp than entry
    'Order Ready' AS activity,
    o.customer_name AS customer,
    o.total_amount AS order_value,
    NULL AS driver,
    NULL AS payment_method
FROM kitchen_queue k
JOIN orders o ON k.order_id = o.id
WHERE k.completed_time >= '2025-01-01'
  AND k.completed_time IS NOT NULL            -- Only include completed orders

UNION ALL

-- Event 5: Assigned to Driver
-- Source: delivery_assignments table
-- This captures when a driver is assigned to deliver the order
SELECT
    d.order_id AS case_id,
    d.assigned_at AS timestamp,
    'Assigned to Driver' AS activity,
    o.customer_name AS customer,
    o.total_amount AS order_value,
    d.driver_name AS driver,                  -- Event-specific attribute
    NULL AS payment_method
FROM delivery_assignments d
JOIN orders o ON d.order_id = o.id
WHERE d.assigned_at >= '2025-01-01'

UNION ALL

-- Event 6: Delivery Completed
-- Source: delivery_assignments table (different timestamp field)
-- This captures when the order was delivered to the customer
SELECT
    d.order_id AS case_id,
    d.delivered_at AS timestamp,
    'Delivery Completed' AS activity,
    o.customer_name AS customer,
    o.total_amount AS order_value,
    d.driver_name AS driver,
    NULL AS payment_method
FROM delivery_assignments d
JOIN orders o ON d.order_id = o.id
WHERE d.delivered_at >= '2025-01-01'
  AND d.delivered_at IS NOT NULL              -- Only include completed deliveries

-- Final ordering: by case, then by time
-- This makes the event log easy to read and follow
ORDER BY case_id, timestamp;该查询将订单ID用作案例ID,并为每项活动返回相同的七列。属性不适用时,NULL值可确保列结构一致。日期筛选条件和付款成功条件仅为示例,请根据要分析的流程和时间范围选择合适的筛选条件。
**扩展查询。**如需添加其他活动:
- 复制一个
SELECT代码块作为起点。 - 使用记录该事件的源数据表。
- 选择代表事件时间戳的字段。
- 设置与其他行一致的活动名称。
- 添加案例ID及相关属性。
- 添加符合分析需求的筛选条件。
例如,如果您的系统中有相关数据表和字段,可以按以下方式添加配送尝试事件:
UNION ALL

-- Event 7: Delivery Attempted
-- Add this to track failed delivery attempts
SELECT
    d.order_id AS case_id,
    d.attempt_time AS timestamp,
    'Delivery Attempted' AS activity,
    o.customer_name AS customer,
    o.total_amount AS order_value,
    d.driver_name AS driver,
    NULL AS payment_method
FROM delivery_attempts d
JOIN orders o ON d.order_id = o.id
WHERE d.attempt_time >= '2025-01-01'
分析日志前的检查
分析日志前,请完成以下检查。这些检查涵盖了最容易导致流程挖掘结果失真的事件日志常见问题:重复事件、时间戳缺失、案例ID不稳定,以及将状态字段误认为活动。
- **先准备必需的列。**先用案例ID、时间戳和活动构建一份小型日志,再添加更多事件或属性。
- **使用稳定的案例ID。**同一案例的所有事件都应使用相同标识符。不要使用会在流程中发生变化的值。
- **统一活动名称。**选择一个标签,例如“已下单”,不要与“订单已创建”或“新订单”等名称混用。
- **检查时间戳。**确认时间戳代表事件发生时间、时区一致,并且可以按日期和时间排序。
- **检查重复记录和缺失值。**调查重复事件,以及案例ID、时间戳或活动缺失的行。
- **记录数据提取过程。**记录源数据表、字段、筛选条件、提取日期和假设,方便后续更新和排查日志。
- **谨慎添加属性。**仅纳入有助于回答问题的字段,并确认连接操作不会增加事件行数。
从重复事件到案例ID缺失,七种常见数据问题的解答可在本页末尾的常见问题中找到;流程挖掘ETL则介绍了如何定期提取数据。
没有数据时该怎么办
准备事件日志不需要预置连接器。先检查系统支持哪些导出方式,以及导出的数据是否包含三个必需字段。
- 确定要跟踪的流程和案例ID。
- 检查系统能否导出事件历史、审计记录或带时间戳的状态变更。
- 使用数据模板,将现有字段映射到案例ID、时间戳和活动。
- 如果无法导出可直接使用的事件表,请联系数据团队,申请数据库提取结果或每行对应一个事件的报表。
系统导出的数据可能包含多张表,也可能用不同名称表示同一字段。您可以在Excel或SQL中合并和重命名数据,但必须保留每个字段的原意,并确保能追溯到源数据。流程挖掘数据从哪里来介绍了其他可能包含可用源数据的位置;流程改进指南则已针对您的系统完成步骤1至3,并为每种流程提供数据模板。
如果您想对照其他流程挖掘事件日志示例,了解不同格式,示例日志文件和模板集合中包含一份可直接使用的电子表格;模板事件日志页面列出了必需列和可选列。首次加载数据集的操作步骤请参阅加载您的第一个数据集。
加载您构建的日志
日志准备就绪后,加载文件并映射三个必需列。ProcessMind可直接读取Excel、CSV和数据库提取文件。
- 上传文件或选择数据库提取文件。
- 映射案例ID、时间戳和活动列。
- 检查其他属性。
- 生成流程视图,并确认案例和事件顺序符合预期。
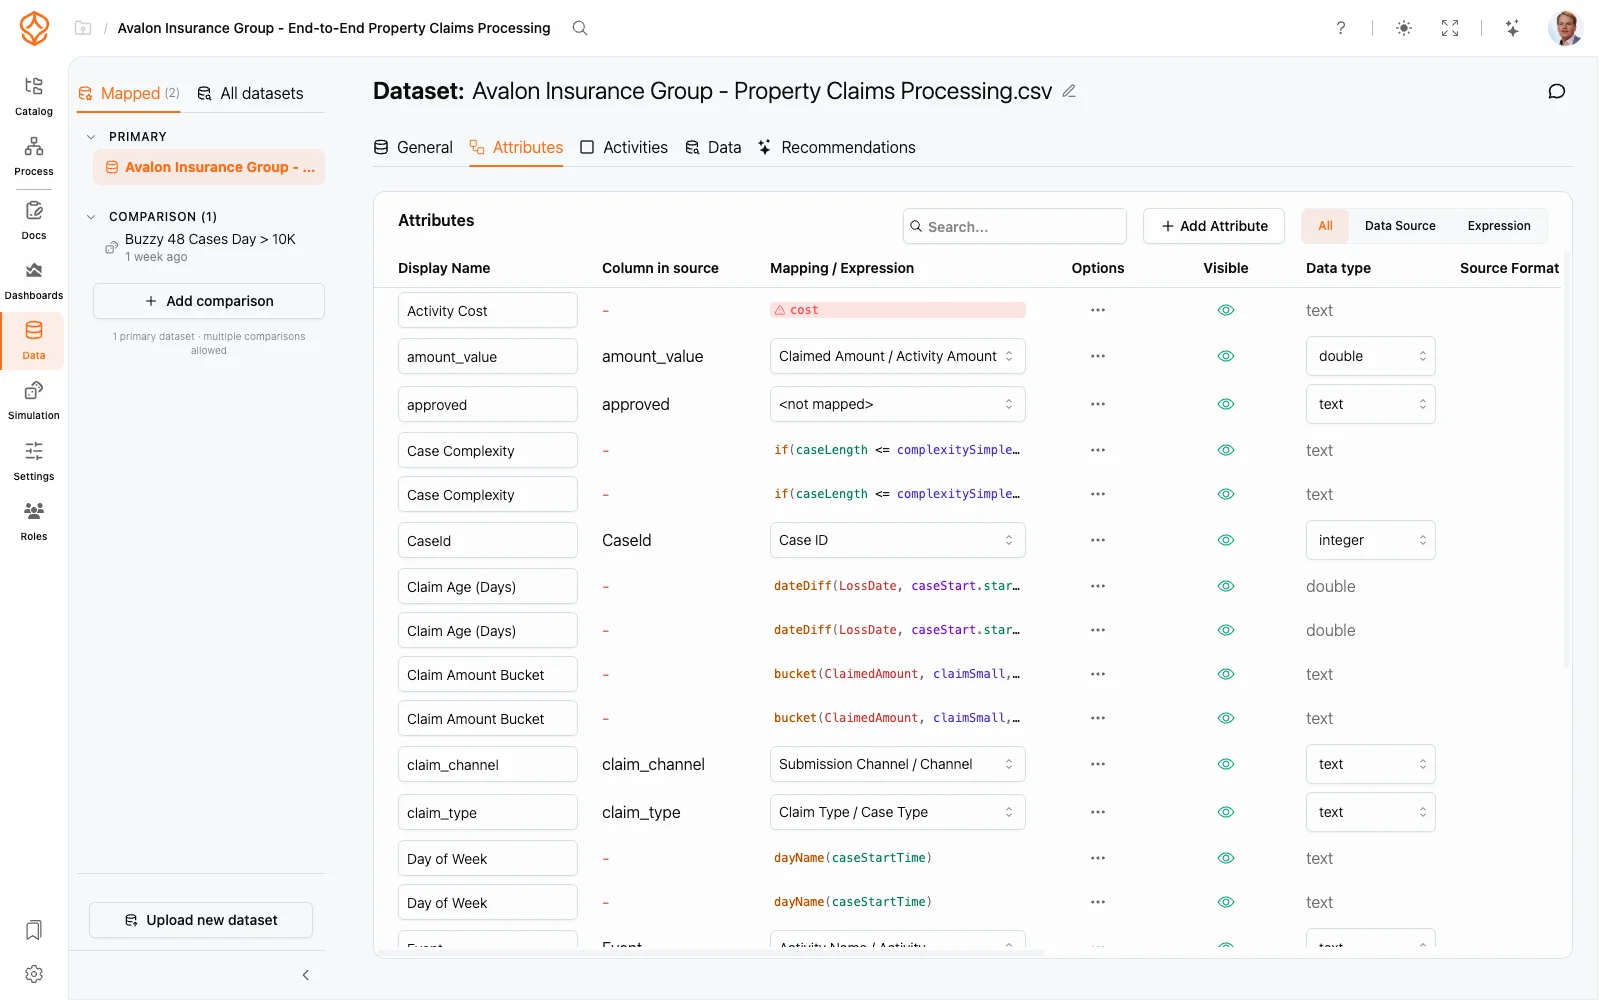
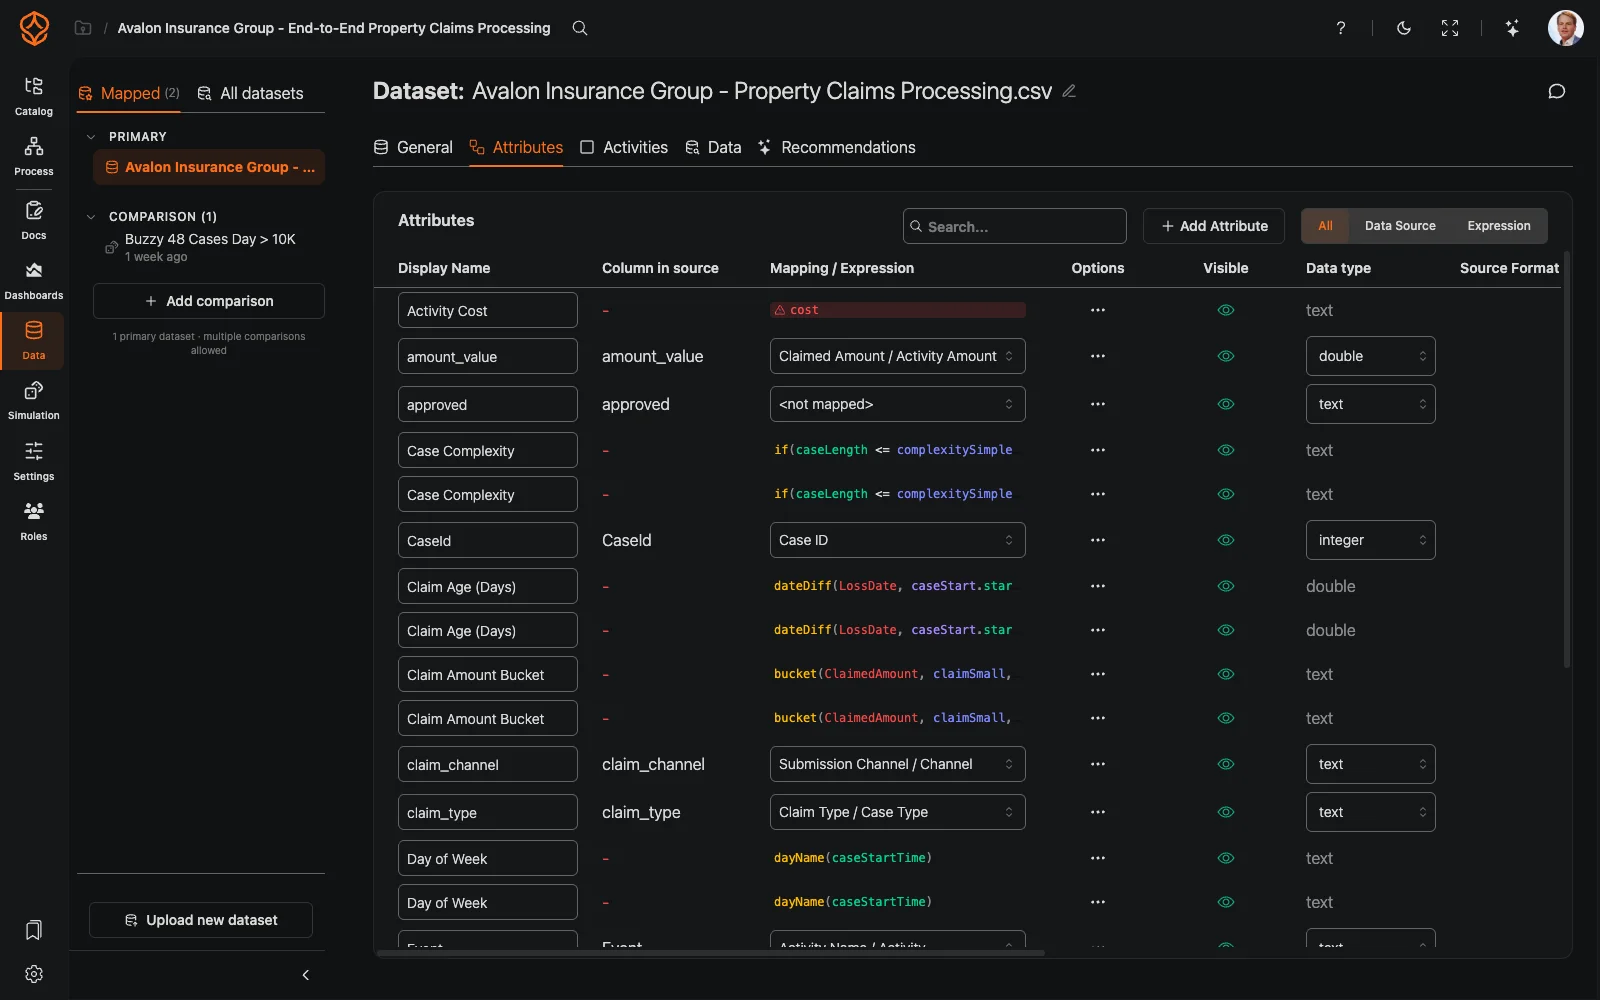
流程视图有助于您发现缺失活动、意外顺序和需要进一步调查的环节。它不会修复源数据,也不会改变工作方式。如果首次分析发现数据问题,请更新提取数据后重新加载。加载您的第一个数据集将详细介绍上传和映射步骤。
Where to Go From Here
您已经有事件日志,或已准备好所需的三列数据。下一步是查看流程的实际运行情况。