ETL-eszközök process mininghoz: mire van szüksége?
Mikor van szükség ETL-re a process mininghoz, mit kell tartalmaznia az adatkinyerésnek, és miért tölti be a ProcessMind a meglévő adatfolyamatok eredményét?

Szüksége van ETL-re a process mininghez?
Az ETL-eszközök kinyerik az adatokat a forrásrendszerekből, használható formára alakítják, majd betöltik az elemzéshez. Ez a cikk azt mutatja be, milyen ETL-munkára van ténylegesen szükség egy process mining projektben, és mi hagyható el. Nem az ETL-folyamatok kiválasztásához ad útmutatót. Ha egy rendszerből exportálhatók a rekordok, a fájlban pedig szerepel ügyazonosító, tevékenység és időbélyeg, az első elemzéshez gyakran kihagyhatja a folyamatot, és változtatás nélkül betöltheti az exportot.
A válasz a folyamattól, a mögötte álló rendszerektől és az elemzés frissítési gyakoriságától függ. Kezdje a kérdés megválaszolásához szükséges legkisebb adatkinyeréssel, majd akkor adjon hozzá előkészítést és automatizálást, ha az első elemzés igazolja ezek szükségességét.
Három helyzetben indokolt ETL-munkát végezni:
- A folyamat több rendszeren ível át. A rekordokat össze kell kapcsolni, az azonosítókat pedig össze kell hangolni, hogy az ügy a teljes folyamaton végigkövethető legyen.
- A forrásadatok jelenlegi formájukban nem használhatók. Az elemzés előtt egységesíteni kell a tevékenységneveket, az időbélyegeket vagy az ügyazonosítókat.
- Az adatkinyerést rendszeresen meg kell ismételni. Ha az adatok naponta változnak, és az elemzésnek követnie kell ezeket a változásokat, a kézi exportálás már nem praktikus.
Ezek az adatok előkészítését indokolják, nem azt, hogy az első kérdés megválaszolása előtt folyamatot építsen. Töltse be, ami rendelkezésre áll, nézze meg, mi hiányzik, és ez alapján döntsön a folytatásról.
Egy ideig azt gondoltuk, hogy az ETL-nek a termék részeként kell működnie. Aztán megnéztük, ügyfeleink mivel rendelkeznek már. Az adattárházak korszaka nagyjából húsz évig tartott, többek között adatpiacok és adattavak formájában. Ennek eredményeként ma a legtöbb vállalatnál rendelkezésre állnak használható adatok. Ezért nem építünk saját adatfeldolgozási folyamatot. Töltsön fel exportot a meglévő rendszereiből, vagy irányítsa a csapata által már fenntartott folyamatot az API-nkra, és kezdje a már rendelkezésre álló adatokkal.
Külön adatfeldolgozási folyamat nélkül is boldogulhat, ha:
- A folyamatot főként egyetlen rendszer rögzíti.
- A szükséges rekordok exportálhatók.
- Az export tartalmaz ügyazonosítót, tevékenységet és időbélyeget.
- A fájl kézzel is előkészíthető méretű.
- Még csak azt vizsgálja, hogy az adatok választ adnak-e a kérdésére.
Egy táblázatban nyugodtan átnevezheti az oszlopokat, kijavíthatja a nyilvánvaló következetlenségeket, és törölheti a szükségtelen mezőket. A kézi előkészítés nem kell, hogy végleges megoldás legyen. Ha az elemzés hasznosnak bizonyul, és gyakran kell frissíteni az adatokat, automatizálja az ismétlődő lépéseket.
Mit kell tartalmaznia az adatkinyerésnek?
A process mininghez használt eseménynaplónak három mezőre és eseményenként egy sorra van szüksége.
| Mező | Mit jelöl? | Mit ellenőrizzen? |
|---|---|---|
| Ügyazonosító | A folyamatpéldányt, például egy megrendelést vagy szolgáltatási igényt | Ugyanaz az ügyazonosító kapcsolja össze az adott példány összes eseményét |
| Tevékenység | A folyamatban történt lépést | A valódi lépéseket megkülönböztető, következetesen használt elnevezéseket |
| Időbélyeg | A lépés időpontját | Valós dátumot és időt, valamint az összevont források egységes időzónáját |
A költség, a felhasználó, a csapat, az ügyfélszegmens vagy a CO2-lábnyom attribútumai nem kötelezők. Ezek különböztetik meg a folyamatnézetet az elemzéstől is: minden megtartott attribútum később szűrőként, bontásként vagy mérőszámként használható. A dataset attribútumainak leírása bemutatja, mire használhatók az egyes mezők.
Egy mező attól még nem feltétlenül használható, hogy szerepel a forrásban. Ha az ügyazonosító rendszerenként változik, az események nem kapcsolhatók össze. A következetlen tevékenységnevek egyetlen valódi lépést három különbözőként jeleníthetnek meg. Ha az időbélyeg szövegként van tárolva, az események rossz sorrendbe kerülhetnek. A leképezés előtt nézze meg az exportot, és először ellenőrizze a három kötelező mezőt. Az eseménynapló tartalmáról bővebben itt olvashat: mire van szükség a process mininghez.
Egy minimálisan használható eseménynapló-lekérdezés
Ha a forrásban már tevékenységenként egy sor szerepel, elég egy SELECT lekérdezés. A példa egy process_events nevű táblából indul ki, amely ügyet, tevékenységet és eseményidőt tartalmaz:
SELECT
  case_id        AS case_id,
  activity_name  AS activity,
  event_time     AS timestamp
FROM process_events
WHERE case_id IS NOT NULL
  AND activity_name IS NOT NULL
  AND event_time IS NOT NULL
ORDER BY case_id, event_time;
A lekérdezés elnevezi a három mezőt, kihagyja a nem használható sorokat, és ügyenként sorba rendezi az eseményeket. Igazítsa a tábla- és oszlopneveket a forrásához, majd betöltés előtt ellenőrizzen néhány ügyet. Minden ügynek az elvárt eseményeket kell tartalmaznia, olyan sorrendben, amelyet a munkát végzők is felismernek.
Mely átalakítási lépésekre van szükség?
Az átalakítás célja, hogy kijavítsa az elemzést torzító hibákat. A legtöbb esetben négy lépés elegendő.
-
Az események egységesítése
Minden tevékenység-előfordulás külön sorba kerüljön az ügyazonosítóval és az időbélyeggel együtt, akkor is, ha a forrás külön oszlopokban tárolja a folyamatlépéseket. -
Az időbélyegek használhatóvá tétele
Ellenőrizze, hogy az értékek valódi dátumok és időpontok-e, és hogy helyi időt vagy UTC-t jelölnek. Hangolja össze az összevont források időzónáit, különben az események sorrendje félrevezető lesz. -
A tevékenységnevek egységesítése
Minden valódi lépéshez egyetlen, egységesen írt, azonos nyelvű címke tartozzon. Ne vonjon össze csak hasonlónak tűnő lépéseket a lista rövidítése érdekében. -
Csak akkor kapcsolja össze a forrásokat, ha szükséges
Keresse meg a rekordokat összekapcsoló kulcsot, és ellenőrizze, hogy megfelelően illeszkedik-e. Ha az összekapcsolás megkettőzi az eseményeket vagy kihagy ügyeket, megváltozik a folyamat képe. Hasonlítsa össze a rekordok számát az összekapcsolás előtt és után.
Ha az export már eseményenként egy sort tartalmaz, és a három szükséges mező is megvan, nincs mit átalakítani. Ez teljesen rendben van, nem kerülőút. A Eseménynapló készítése process mininghez című útmutató ugyanezt mutatja be Excel- és SQL-példákkal.
Hová töltse be az eseménynaplót?
Töltse be az előkészített adatokat abba a platformba, ahol elemezni fogja őket. Első áttekintéshez egyetlen fájl is elég: készítse elő, töltse be, nézze meg a folyamatot, majd pontosítsa az adatkinyerést, amikor már látja, mire alkalmasak az adatok. Ne állítson üzembe új tárolóréteget kizárólag a process mining kedvéért. Ha a csapata már fenntart adattárházat vagy adattavat, hagyja ott az adatokat, és töltse be az adott környezet által előállított fájlt.
A támogatott adatformátumok oldal részletesen bemutatja a lehetőségeket. Ha senki nem szeretné kézzel feltölteni a fájlokat, ütemezett feladat is elküldheti őket a data API-n keresztül.
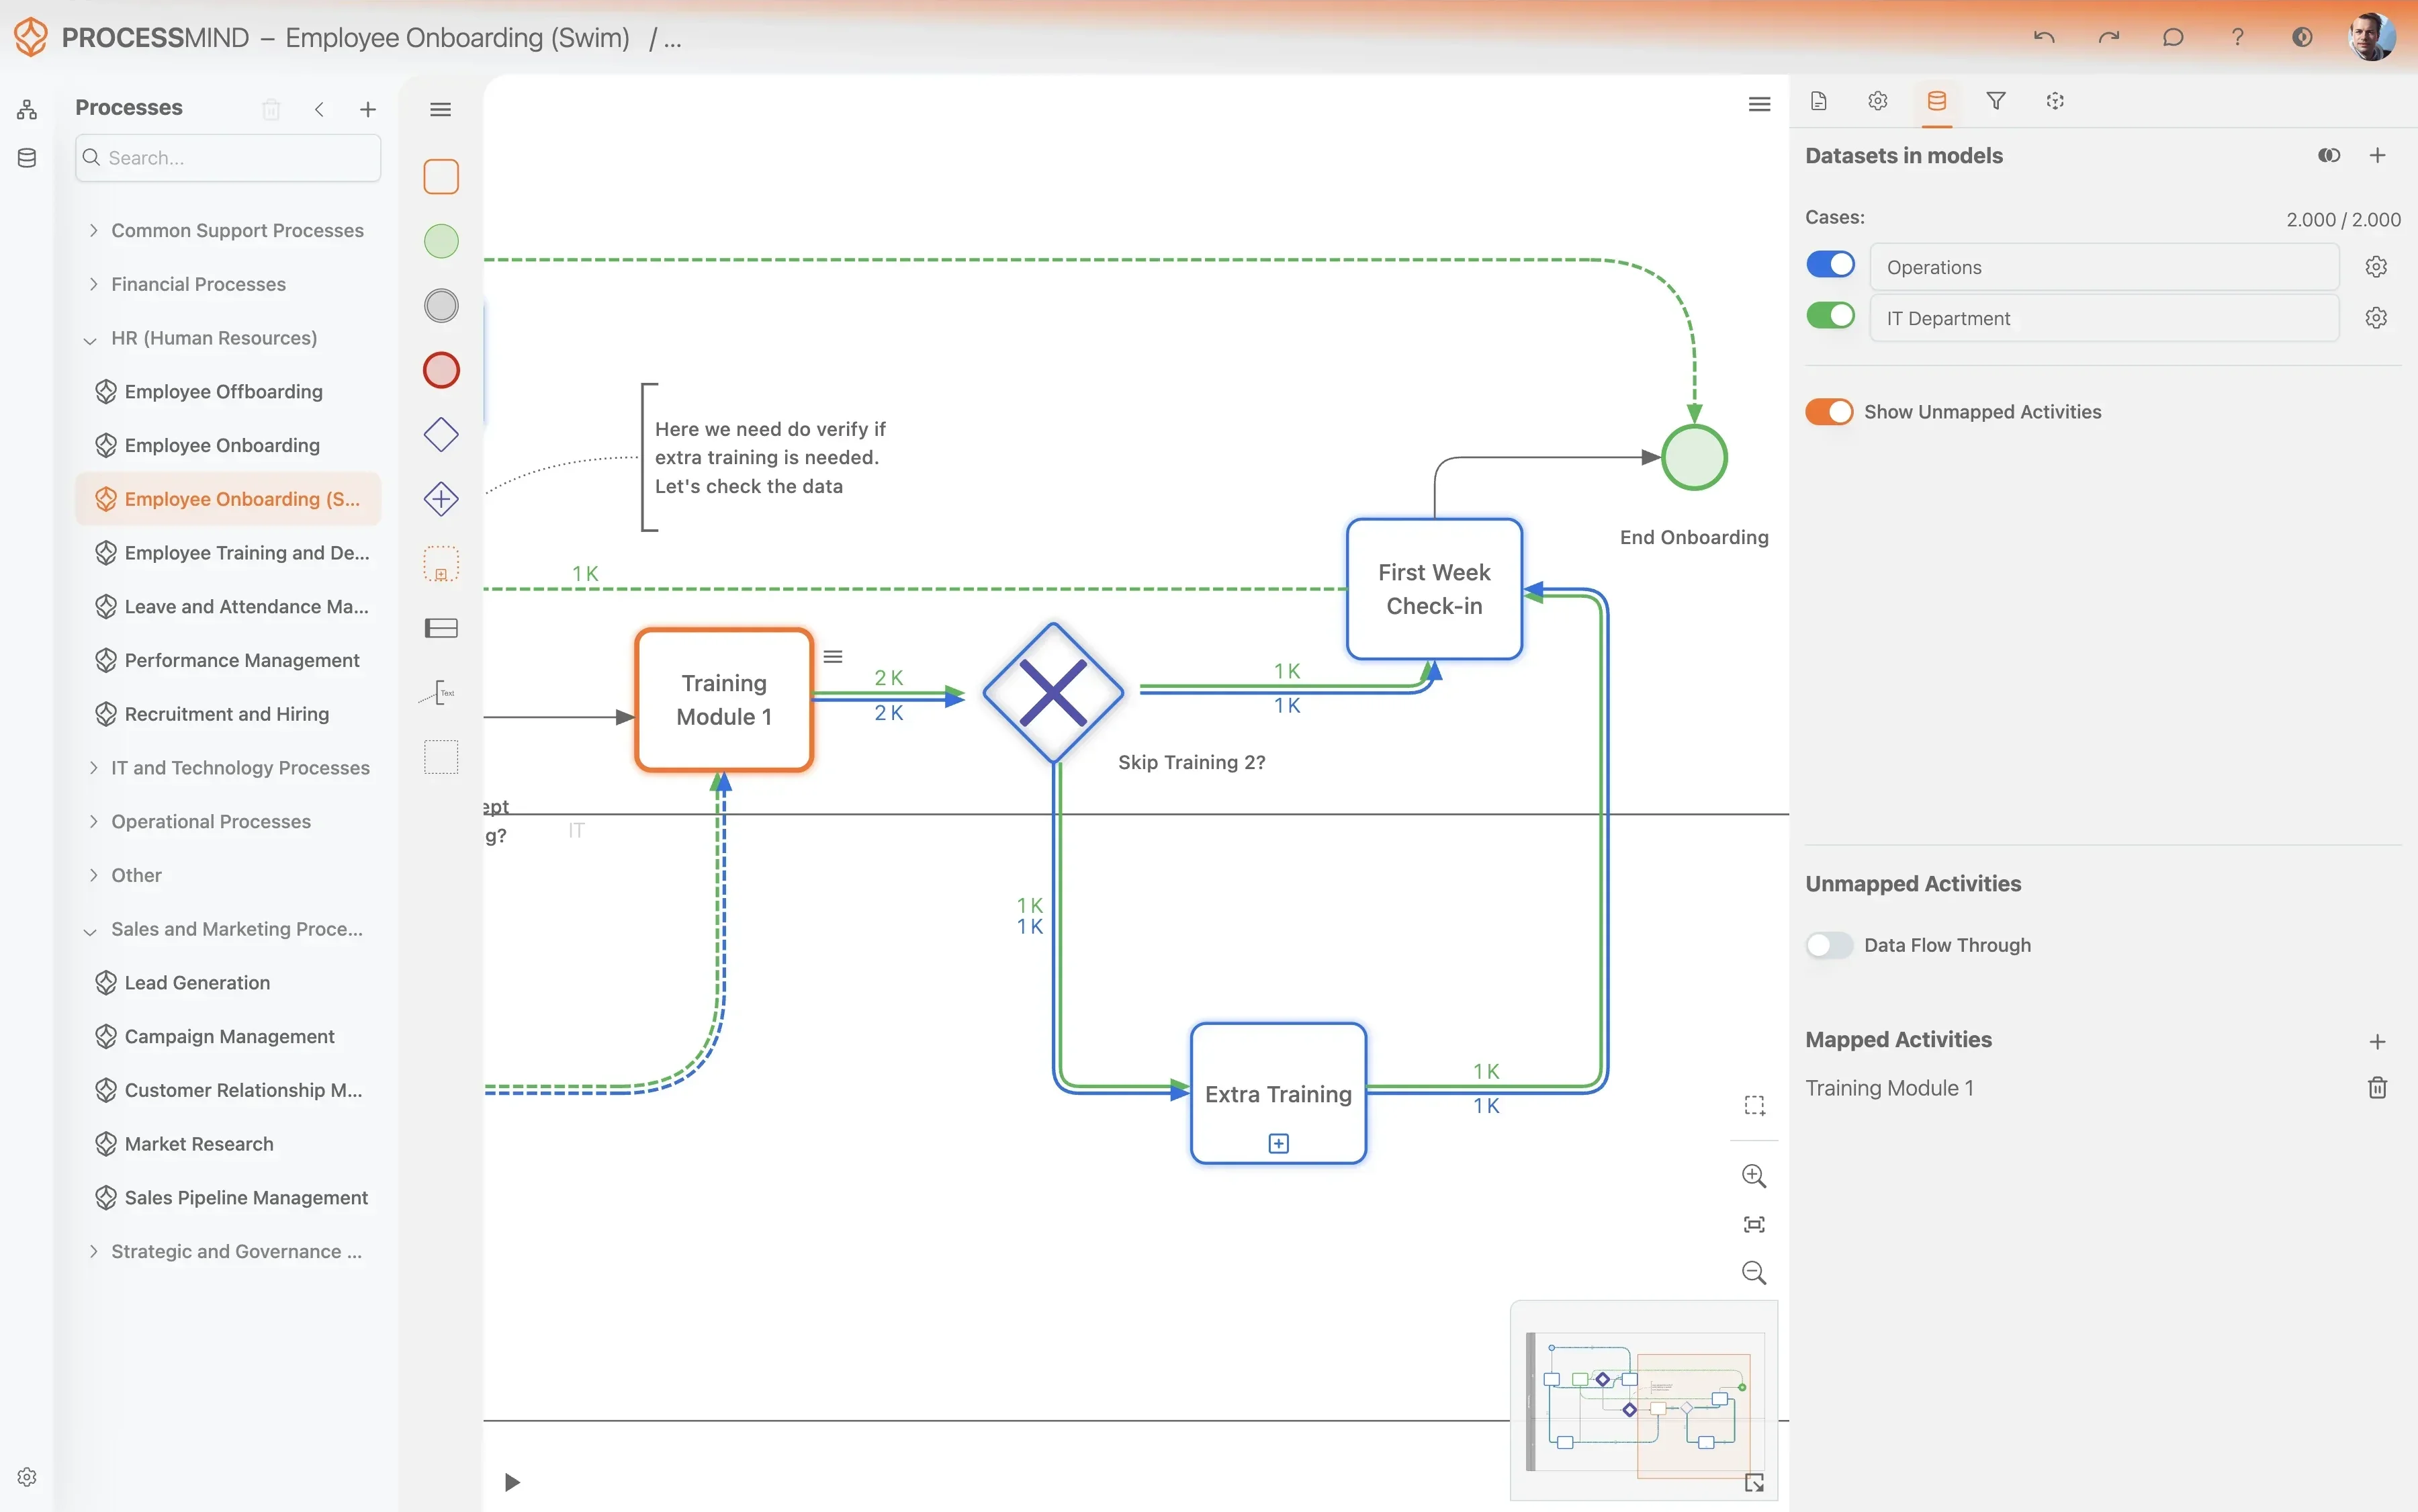
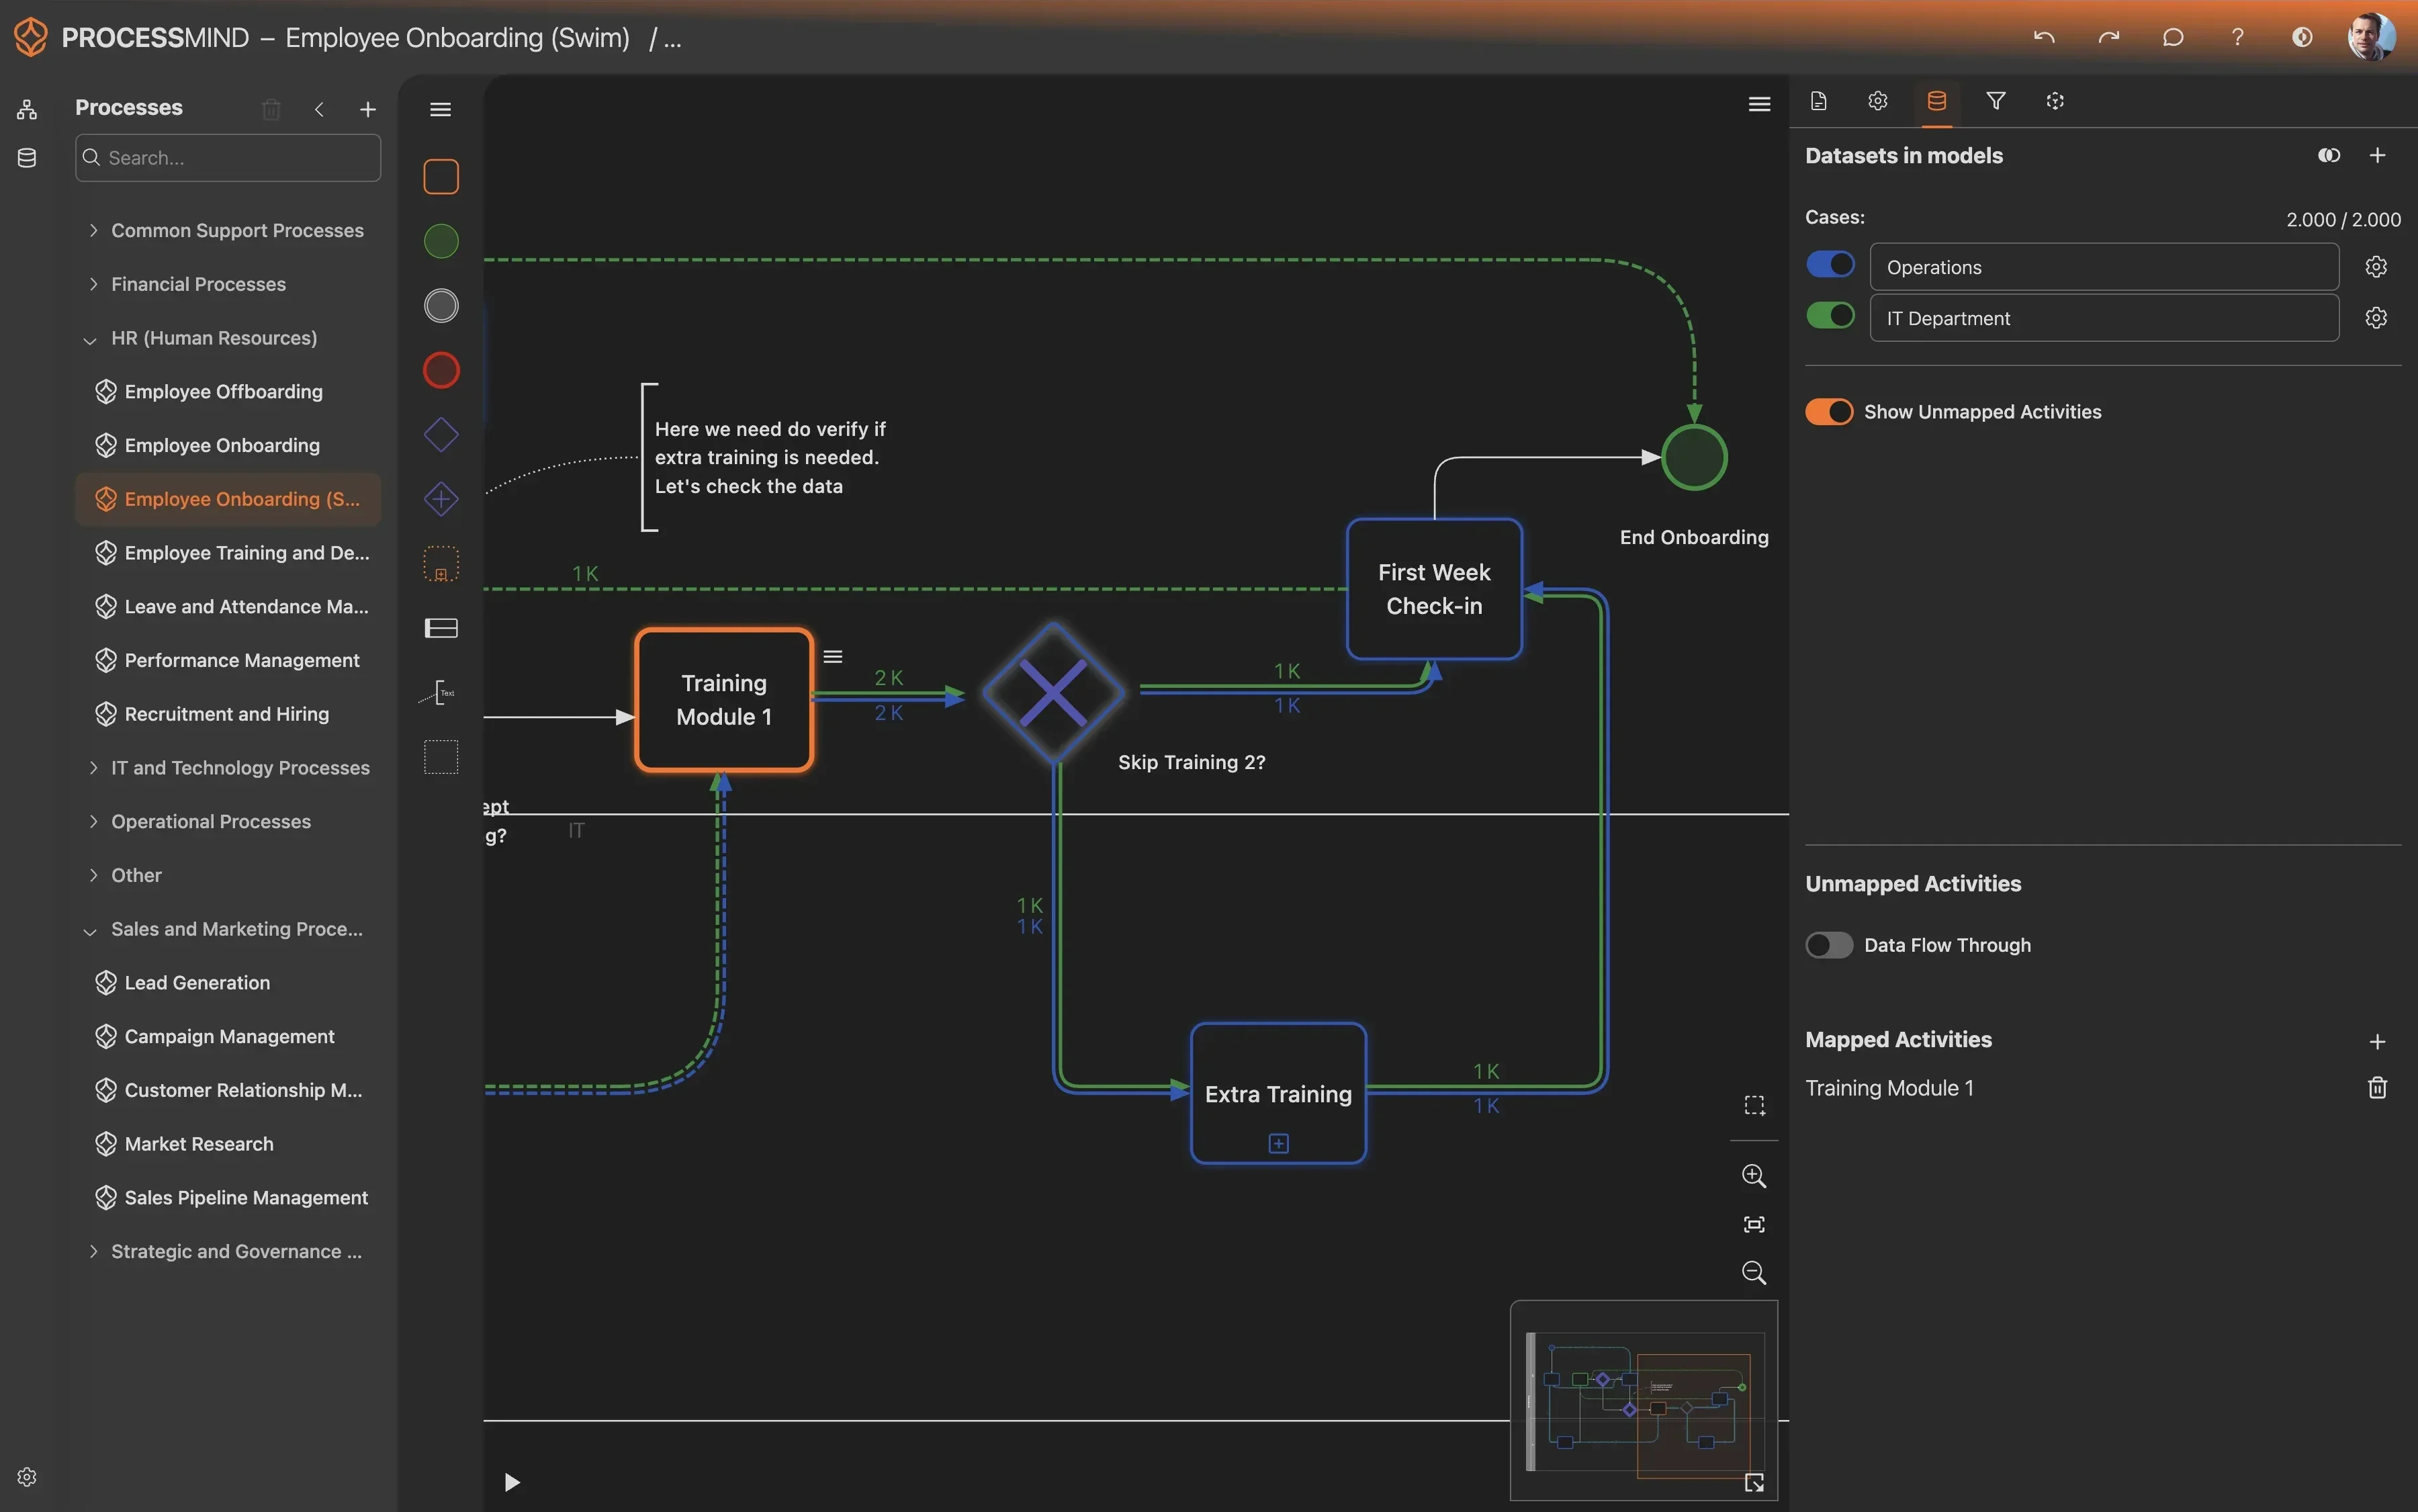
Bármelyik megoldást választja, a betöltésnek ott kell véget érnie, ahol az elemzés történik. Egy olyan mappában lévő fájl, amelyet senki nem figyel, nem adatstratégia. Az elemzéshez leképezett és rendszeresen ellenőrzött adatkészlet viszont az.
Mely ETL-eszközök alkalmasak process mininghez?
Nincs olyan ETL-eszközlista, amely minden projekthez megfelelő. A választást az határozza meg, hol vannak az adatok, milyen eszközöket használ már a csapata, és mennyi előkészítést igényel az eseménynapló. Maga a munka szokásos adatfeldolgozás, a process mining egyetlen különleges elvárása pedig az, hogy az eredményben megmaradjon az ügyazonosító, a tevékenység és az időbélyeg.
| Megközelítés | Mikor érdemes használni? | Hátrány |
|---|---|---|
| Kézi exportálás és előkészítés | Egyetlen folyamatot vizsgál egy kis, stabil adatkészleten | Ezzel kezdhet a leggyorsabban, de minden frissítés kézi munkát jelent |
| A csapata által már használt eszközök | Már rendelkezésre áll SQL, dbt, adattárház vagy adattó | Hasznosítja a meglévő tudást és infrastruktúrát, a logika pedig a process miningen kívül is újrahasználható |
| Külső ETL-eszköz | Több rendszerből kell rendszeresen adatot kinyerni | Több összetevőt kell beállítani és karbantartani |
| A process mining platformba épített ETL | A platform elvégzi a szükséges átalakításokat | Kényelmes, de ellenőrizze, mennyire hordozható a logika, és felhasználhatók-e az adatok máshol is |
A process mining projektekben gyakran felmerülő nevek: adatkinyeréshez és SQL-alapú átalakításhoz a CData és a dbt; adattárházi megoldásként a BigQuery, a Snowflake és a Databricks; rendszerek közötti adatmozgatáshoz pedig a Talend, az Apache NiFi és az Airbyte. A nyílt forráskódú megoldások is szóba jöhetnek, általában a NiFi és az Airbyte a kiindulópont. Egyes szállítók kifejezetten process mininghez készült ETL-eszközöket is kínálnak, például az Evidant és a Konekti, gyakori rendszerekhez használható sablonokkal.
Ezek példák, nem ajánlások, és egyik gyártóval sincs partnerségünk. Olyan eszközöket és formátumokat válasszon, amelyeket a csapata a projekt után is fenn tud tartani, és ahol lehet, tartsa az átalakítási logikát a process mining terméken kívül. A beépített ETL-t érdemes alaposan mérlegelni: kényelmes, amíg az adott platformot használja, viszont az előkészítési logikát nehezebb lesz újrahasznosítani egy későbbi elemzési vagy AI-projektben.
Hogyan kezelje az adatokat betöltés után?
Az adatkinyerés csak a munka fele. Az adatkészletek későbbi kezelése dönti el, hogy az elemzés három hónap múlva is megállja-e a helyét.
- Nevezze el az adatkészleteket a tartalmuk alapján. A
Q1_2025_Sales_DatavagyCustomer_Support_Logsbeszédesebb, mint aexport_final_v3. - A feladathoz illő formátumot válasszon. Kis, kézzel feltöltött fájlokhoz megfelelő a CSV vagy az Excel. Nagy adatkészletekhez és folyamatokból előállított fájlokhoz a Parquet vagy az ORC célszerű.
- Leképezés előtt tekintse meg az adatokat. Ellenőrizze a szerkezetet, az oszloptípusokat és néhány sort, majd erősítse meg az ügyazonosítót, a tevékenységet és az időbélyeget a dataset konfigurációjában.
- Ellenőrizze a tevékenységek leképezését. Hagyja, hogy az automatikus leképezés elvégezze az első kört, majd nézze át a le nem képezett tevékenységeket. Az adatokban nyomot nem hagyó, de ténylegesen megtörtént lépéseket data flow through jelöléssel láthatja el. Így láthatók maradnak anélkül, hogy módosítanák a számokat.
- Frissítse az adatokat, ne építse újra a folyamatot. Ismétlődő export esetén az elemzés szükségleteihez igazodó ütemben, naponta vagy hetente cserélje le az adatkészletet a friss fájlra, és tartsa meg ugyanazt a leképezést.
- Rögzítse, mire nem terjed ki az adat. A kimaradó időszakokat, rendszereket és lépéseket jegyezze fel az elemzésben, mert ezek határozzák meg, mire következtethet.
- Szabályozza a hozzáférést, majd archiváljon. Az adatkészlethez azoknak adjon hozzáférést, akiknek szükségük van rá, a lezárt projektben már nem használt adatokat pedig archiválja.
Összefoglalás
A process mining projektben az ETL eszköz, nem cél. Úgy állítsa be, hogy ne lassítsa az első elemzést:
- Kezdje azokkal az adatokkal, amelyeket ezen a héten be tud szerezni.
- A három kötelező mezőt tartsa meg, bármi mást hagy is ki.
- Először töltse be az exportot, és csak akkor automatizálja a betöltést, ha az elemzés ezt indokolja.
- Használja azokat az eszközöket és formátumokat, amelyeket a csapata már fenntart.
Több projekt bukik el azért, mert a folyamatot még azelőtt építették meg, hogy bárki tudta volna, milyen kérdésre kell választ adnia, mint azért, mert túl egyszerű volt.
Where to Go From Here
Már van exportja, vagy olyan folyamata, amely elő tudja állítani. Következő lépésként töltse be, és ellenőrizze, hogy az adatok választ adnak-e a kérdésére.