Datamapping beheersen voor procesoptimalisatie
Lees hoe datamapping in ProcessMind je eventdata koppelt aan procesmodellen voor analyse en visualisatie.
Datasets mappen is een belangrijke stap om ruwe data om te zetten in inzichten in ProcessMind. Je kunt op elk moment data toevoegen, verwijderen, inschakelen of uitschakelen. Er is geen vaste volgorde of verplichte manier om data aan je proces toe te voegen.
Je kunt op twee manieren met data aan de slag:
| Situatie | Aanpak |
|---|---|
| Je hebt al een proces gedefinieerd en wilt dit met data aanvullen | Begin met een proces en voeg daarna data toe |
| Je hebt alleen ruwe eventdata en nog geen model | Begin met data en voer process mining uit |
| Je wilt ProcessMind eerst uitproberen | Genereer een voorbeeldproces met gesimuleerde data |
In deze documentatie bouw je stap voor stap een proces en analyse op, vanaf een leeg canvas. Wil je liever met een bestaand proces beginnen? Dan kun je een bestaand BPMN-model importeren en meteen data koppelen aan taken en events in het geïmporteerde model.
Maak eerst een nieuw proces aan of open een bestaand proces. Op het canvas bouw je je model en map en orden je datasets. Heb je je data nog niet in het datagedeelte geüpload? Dan kun je die ook rechtstreeks vanuit de procesweergave uploaden. Open daarvoor in het rechterpaneel de datasetselectie, zoals in de afbeelding hieronder.
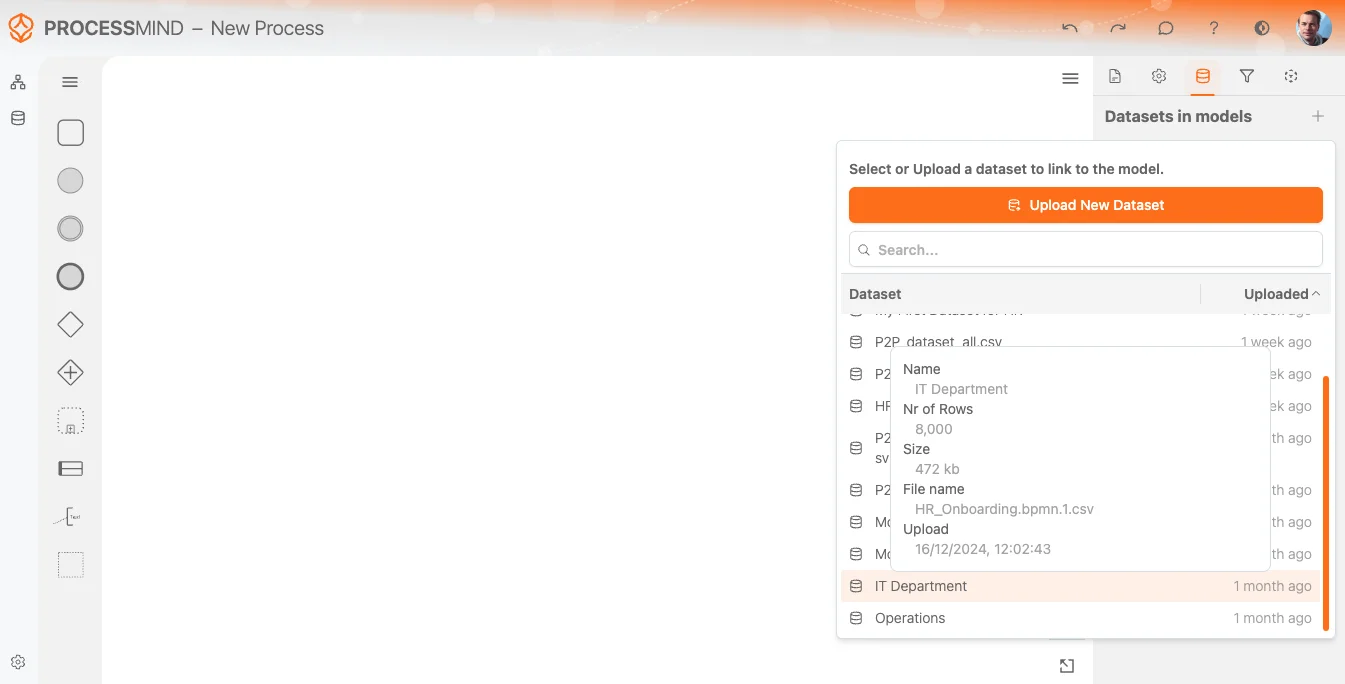
Zodra je dataset is geüpload en verwerkt, krijg je een melding dat deze klaar is voor gebruik. Je kunt de dataset daarna selecteren in de Datasetlijst, zoals hierboven te zien is. De laatst geüploade dataset staat altijd bovenaan.
Beweeg de muisaanwijzer over een dataset in de lijst om extra informatie te zien, zoals:
Zo weet je zeker dat je de juiste dataset voor je proces selecteert.
Na het selecteren voert het systeem een aantal basisbewerkingen uit. Tijdens dit proces zie je een laadpictogram naast de datasetnaam.
Je kunt de dataset een andere naam geven, zodat de naam past bij het gebruik in dit proces en je de dataset later makkelijker herkent. Met een schakelaar kun je de dataset in het model tonen of verbergen.
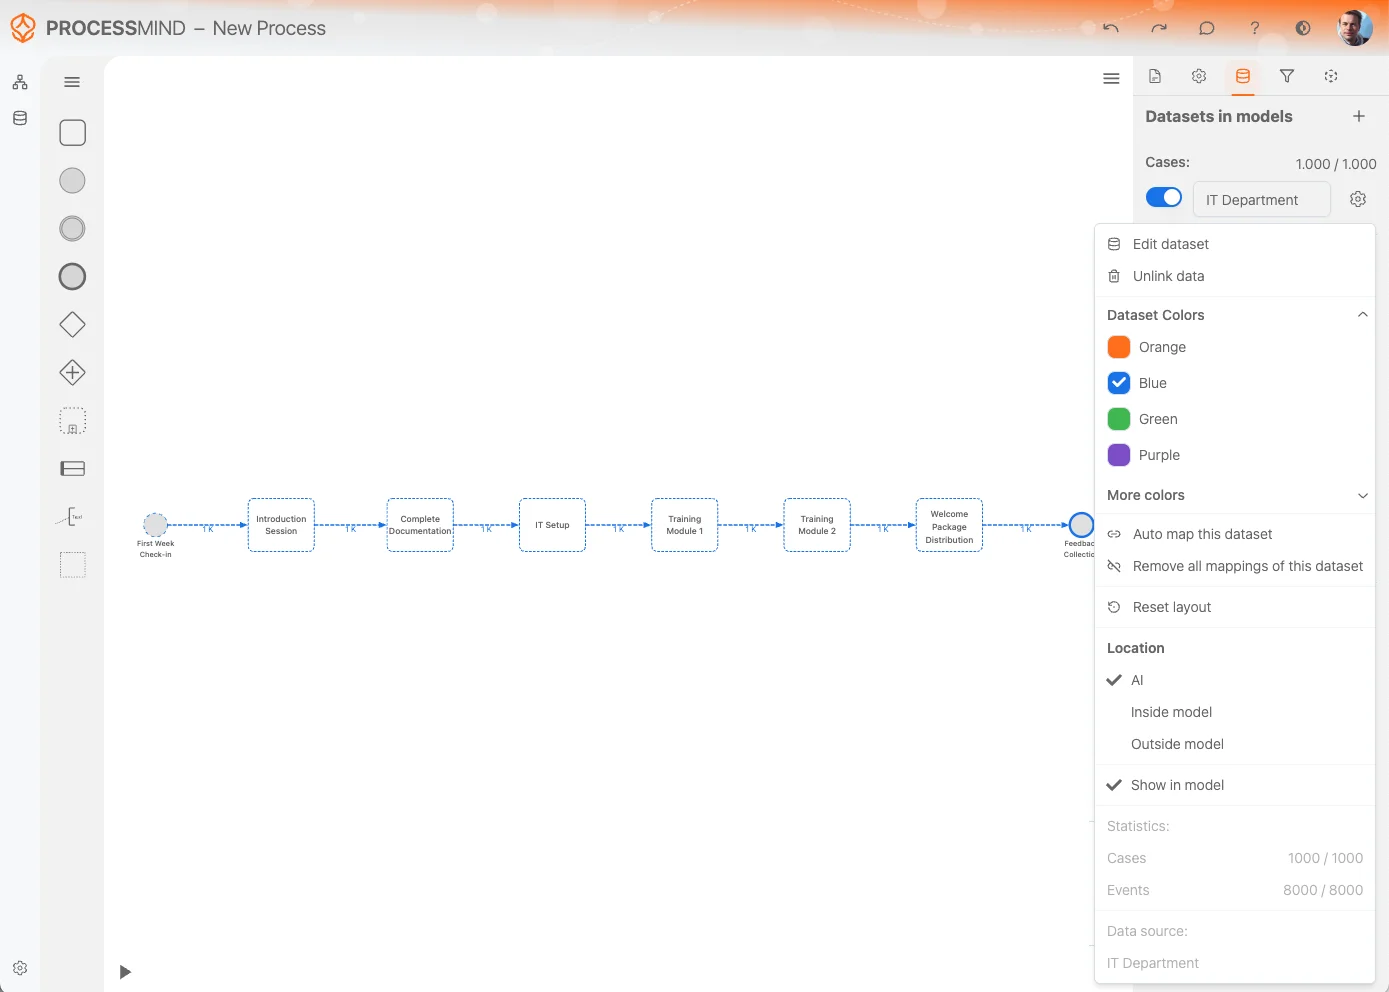
In het menu Datasetinstellingen vind je verschillende opties om je dataset te beheren en aan te passen:
Dataset bewerken:
Kies Dataset bewerken om de dataset zelf aan te passen. Zo kun je de dataset rechtstreeks wijzigen of verfijnen.
Data uit model verwijderen:
Heb je de dataset niet meer nodig in je proces? Kies dan Data uit model verwijderen. Alle verwijzingen naar de dataset worden verwijderd en de dataset verdwijnt van het procescanvas.
Let op: de dataset zelf wordt niet verwijderd. Deze blijft beschikbaar in de Datasetlijst.
Datasetkleuren:
Kies een andere kleur om datasets visueel beter uit elkaar te houden. De gekozen kleur wordt ook gebruikt voor activiteiten uit deze dataset, zodat je ze makkelijker herkent op het canvas.
Deze dataset automatisch mappen:
Met deze optie probeert ProcessMind de datasetactiviteiten automatisch te koppelen aan activiteiten die al in je procesmodel staan. Dat bespaart tijd en helpt om de gegevens consistent te houden.
Alle mappings van deze dataset verwijderen:
Verwijder hiermee alle koppelingen tussen de dataset en je procesmodel. Handig als je opnieuw wilt beginnen of grote wijzigingen wilt aanbrengen.
Model automatisch indelen:
Met de optie Model automatisch indelen worden activiteiten en hun relaties automatisch op het canvas geplaatst. Zo wordt het model duidelijker weergegeven.
Datasets met dezelfde kleur samenvoegen:
Voeg datasets met dezelfde kleur samen tot één model, weergegeven in die kleur.
In de rij van de datasetlijst staat ook de schakelaar Data in model tonen. Hiermee verberg of toon je activiteiten uit de dataset die niet rechtstreeks aan het model zijn gekoppeld. Gebruik de schakelaar om te bepalen welke niet-gekoppelde activiteiten zichtbaar zijn.
Met deze opties bepaal je hoe datasets in je procesmodellen worden opgenomen, weergegeven en vergeleken. Lees bij Primair en vergelijking hoe je datasets van rol laat wisselen, een dataset primair maakt of verwijdert.
Zodra de dataset volledig is geladen, toont het systeem het resultaat van process mining op het canvas. Dit eerste procesmodel staat los en is nergens aan vastgemaakt. Wil je het opnemen in je procesontwerp en bewerken? Koppel het dan aan een bestaand model of een bestaande activiteit, of zet het om in een vast model.
Je kunt activiteiten uit het zwevende model op twee manieren aan het canvas vastmaken:
Activiteiten afzonderlijk selecteren:
Selecteer de activiteiten die je afzonderlijk wilt koppelen.
Meerdere activiteiten selecteren:
Gebruik de selectietool of sneltoetsen om meerdere activiteiten tegelijk te selecteren:
Ctrl + A (Windows) of Command + A (macOS) om alle activiteiten te selecteren.Na je selectie verschijnt er een contextmenu naast de geselecteerde activiteiten. Kies daarin Aan model toevoegen. De geselecteerde activiteiten worden dan aan het canvas vastgemaakt. Je kunt vervolgens:
Als je de proceskaart van je dataset aan het canvas vastmaakt, kun je je proces aanvullen met attributen, relaties en context. Zo zet je ruwe data om in inzichten.
Niet-gekoppelde activiteiten staan wel in de dataset, maar zijn nog niet gekoppeld aan attributen in het model. Het kunnen ontbrekende onderdelen zijn die je nog in je procesontwerp moet opnemen.
Als je de optie Niet-gekoppelde activiteiten in- of uitschakelt, worden niet-gekoppelde gegevens met stippellijnen weergegeven. Zo zie je in één oogopslag welke activiteiten wel en niet zijn gekoppeld.
In het voorbeeld zie je de situatie voor en na het in- of uitschakelen van de optie voor niet-gekoppelde activiteiten:
Met deze functie beheer je niet-gekoppelde data en bepaal je wat ermee gebeurt. Zo maak je je procesmodel zo volledig en nauwkeurig mogelijk.
Of je nu begint met een gedefinieerd proces of met ruwe data, je kunt je model gaandeweg opbouwen en verfijnen. Zo ontstaat een volledig model dat je kunt analyseren en verbeteren.
Krijg meteen toegang, zonder creditcard of wachttijd. Maak van de manier waarop je organisatie werkt heldere, samenhangende procesmodellen.
Breng de procesarchitectuur in kaart, leg verantwoordelijkheden en beheersmaatregelen vast en stem rollen en taken op elk niveau op elkaar af.
Start je gratis proefperiode en bouw een betrouwbare basis om processen te beheren en continu te verbeteren.
We gebruiken cookies om je ervaring te verbeteren, content persoonlijker te maken en verkeer te analyseren. We meten paginaweergaven ook anoniem, zonder cookies. Als je toestemming geeft voor analytics, voegen we een identifier toe waarmee we je bezoeken aan elkaar kunnen koppelen. Door op "Alles accepteren" te klikken, geef je toestemming voor het gebruik van cookies.